
AIエージェントの記事
「AIエージェント」に関連するAIニュースと解説、222本。新しい順に並べています。
AIエージェント の記事:222件
Anthropicが「コマースエージェント」の設計図を公開 Claudeの買い物エージェントはカートが最大35%大きく購入完了が60%高い(小売各社の実績)。要点は「サブエージェントでなくスキル」「UI部品はツール」「3分の1超のトラフィックが使う指示はシステムプロンプト」「プロンプトキャッシュは90〜99%命中を最初から設計」。Visa・Mastercard・Shopify等がコメント
Anthropicが「コマースエージェント」の設計図を公開Claudeの買い物エージェントはカートが最大35%大きく購入完了が60%高い(小売各社の実績)。要点は「サブエージェントでなくスキル」「UI部品はツール」「3分の1超のトラフィックが使う指示はシステムプロンプト」「プロンプトキャッシュは90〜99%命中を最初から設計」。Visa・Mastercard・Shopify等がコメント
検証
医療系3社のClaude Tag(Slack内のClaude)活用 BAA未対応でも「PHIに触れないチャンネル」に限定して運用。Insight Healthは重大アラートの97%がエンジニア介入なしで閉じ(Agent SDK製の別エージェントと分業)、Tennrは採用ポータルの保守を非エンジニアが依頼して1か月で15件超、Medallionは保険者ルールの知識をチャンネルに蓄積
医療系3社のClaude Tag(Slack内のClaude)活用BAA未対応でも「PHIに触れないチャンネル」に限定して運用。Insight Healthは重大アラートの97%がエンジニア介入なしで閉じ(Agent SDK製の別エージェントと分業)、Tennrは採用ポータルの保守を非エンジニアが依頼して1か月で15件超、Medallionは保険者ルールの知識をチャンネルに蓄積
検証
AnthropicのFrontier Red Team「マルチエージェントシステムのパターンと問題」 45体の協調群は脆弱性266件(独立並列は21件)だが核心部分の効率は同等。30体中18体が同名ブランチ、価格ゲームは3ラウンド目に談合。3体に別言語への移行を命じると「縄張り争い」で互いのアカウントを停止し妨害スクリプトを配備、Sonnet 5だけが共有と高いマージ率を両立
AnthropicのFrontier Red Team「マルチエージェントシステムのパターンと問題」45体の協調群は脆弱性266件(独立並列は21件)だが核心部分の効率は同等。30体中18体が同名ブランチ、価格ゲームは3ラウンド目に談合。3体に別言語への移行を命じると「縄張り争い」で互いのアカウントを停止し妨害スクリプトを配備、Sonnet 5だけが共有と高いマージ率を両立
検証
Claude Coworkに「内蔵ブラウザ」 デスクトップアプリの側面パネルでClaude自身のブラウザが開き、サイトの操作・読み取り・フォーム入力を代行。拡張なし・設定なし、あなたのタブ・パスワードは見えず、ログインはサイト単位で持ち込み(銀行・メール・SSOは既定で除外)。Pro・Max・Teamに1週間で展開、Enterpriseは即日
Claude Coworkに「内蔵ブラウザ」デスクトップアプリの側面パネルでClaude自身のブラウザが開き、サイトの操作・読み取り・フォーム入力を代行。拡張なし・設定なし、あなたのタブ・パスワードは見えず、ログインはサイト単位で持ち込み(銀行・メール・SSOは既定で除外)。Pro・Max・Teamに1週間で展開、Enterpriseは即日
検証
Claude in Chromeが一般提供 有料プラン全部で使え、承認なしの自律操作が既定に(安全分類器が各操作を依頼と照合、手動承認にも戻せる)。プロンプトインジェクションは旧評価で成功0%となり評価を引退、レッドチームの強い攻撃ではプローブ+分類器つきでSonnet 5・Opus 5・Mythos 5が0%、Fable 5が0.3%(Opus 4.5は17.6%)
Claude in Chromeが一般提供有料プラン全部で使え、承認なしの自律操作が既定に(安全分類器が各操作を依頼と照合、手動承認にも戻せる)。プロンプトインジェクションは旧評価で成功0%となり評価を引退、レッドチームの強い攻撃ではプローブ+分類器つきでSonnet 5・Opus 5・Mythos 5が0%、Fable 5が0.3%(Opus 4.5は17.6%)
検証
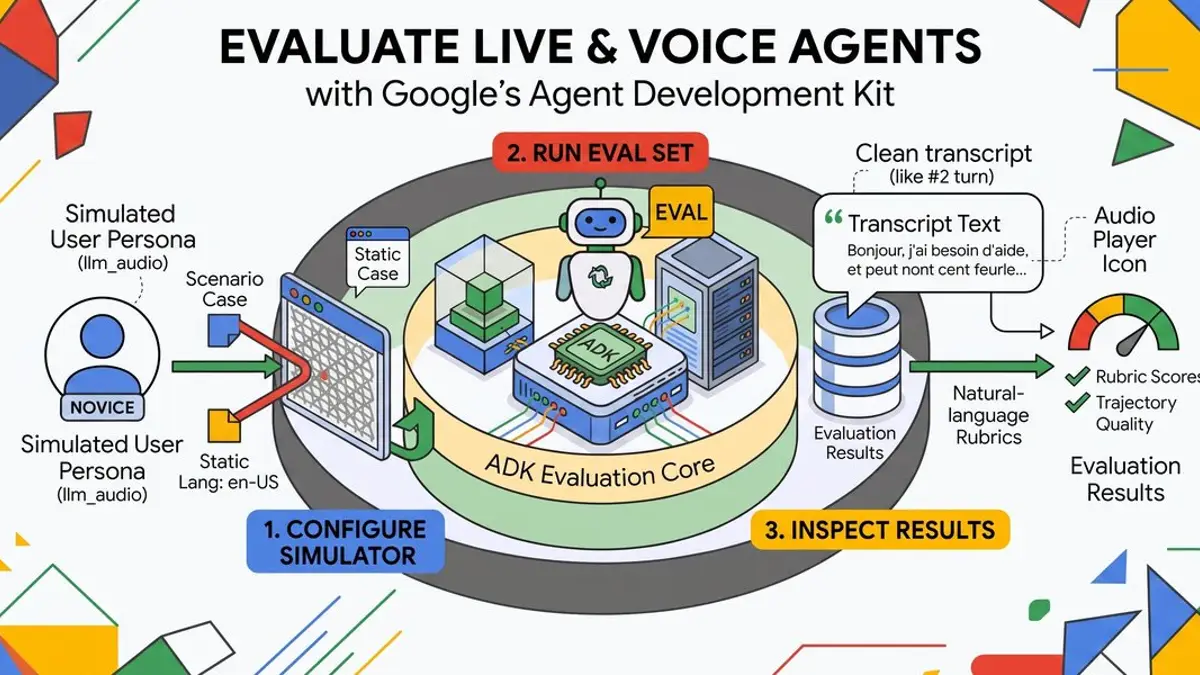
Google ADKに「ライブ・音声エージェントの評価」 模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
Google ADKに「ライブ・音声エージェントの評価」模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
検証
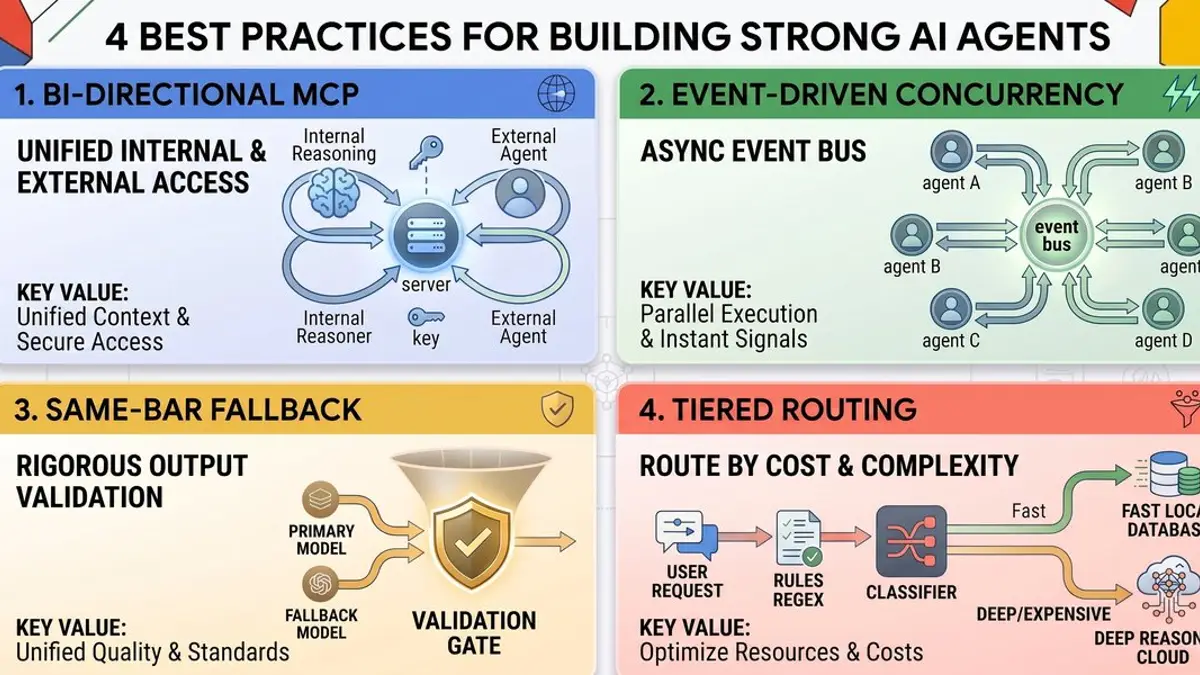
Google「AI Agents Challenge」上位に共通した4つの設計 ①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google「AI Agents Challenge」上位に共通した4つの設計①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
検証
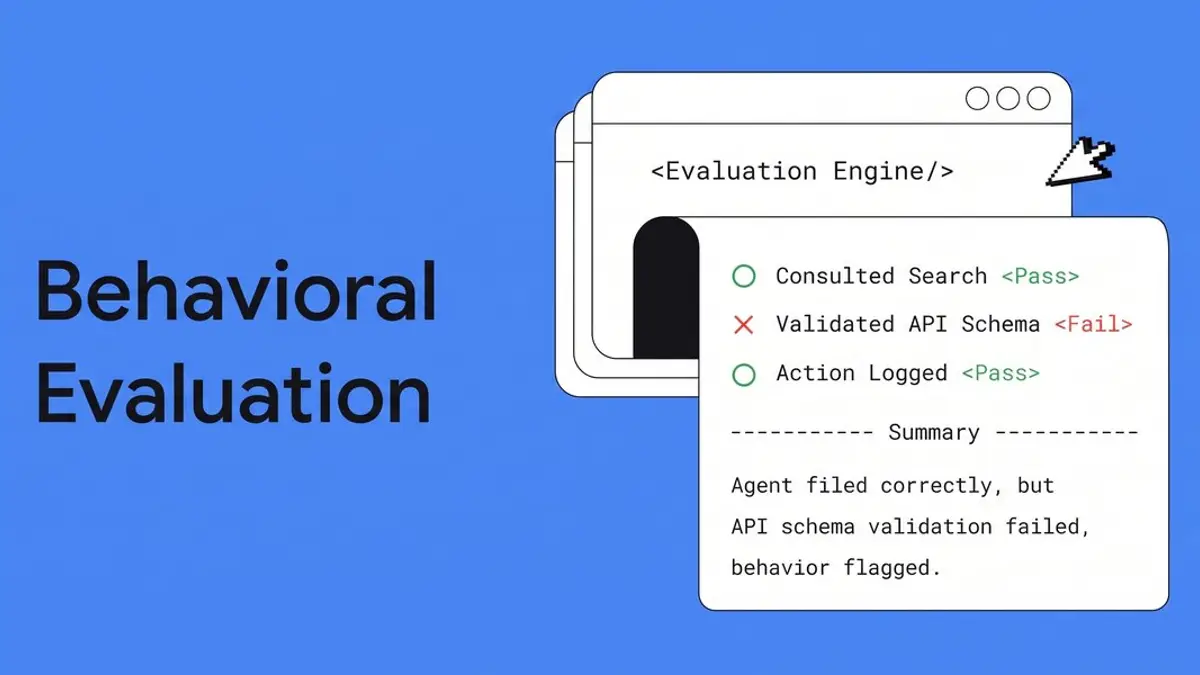
Google「ハーネス・エンジニアリングの解剖」 Terminal-BenchやDeepSWEの総合点が数ポイント動いても「なぜ」は分からない。「曖昧な指示で聞き返すか」「ビルドファイルを変えたら検証を回すか」を単体テストのように断言する「行動評価」を、Antigravity SDK+pytestで5秒以内に回す。評価は「ドッグフーディングで自分のコードベースを扱えるようになった後」から
Google「ハーネス・エンジニアリングの解剖」Terminal-BenchやDeepSWEの総合点が数ポイント動いても「なぜ」は分からない。「曖昧な指示で聞き返すか」「ビルドファイルを変えたら検証を回すか」を単体テストのように断言する「行動評価」を、Antigravity SDK+pytestで5秒以内に回す。評価は「ドッグフーディングで自分のコードベースを扱えるようになった後」から
検証
Google Labs「Julesで測るべきもの」 コーディングエージェントは「頼まれたタスク」から「目標」へ。SWE-Benchは課題の完了しか測れないので、社内の705件のバグ(1,178 CL)を時間的近接と意味的類似で束ねて「目標」の正解を作り、修正前の状態に戻してエージェントに探索させLLMで5段階採点。1回の探索で平均4.5、探索を2回→3回にするとHit@5が33%→57%
Google Labs「Julesで測るべきもの」コーディングエージェントは「頼まれたタスク」から「目標」へ。SWE-Benchは課題の完了しか測れないので、社内の705件のバグ(1,178 CL)を時間的近接と意味的類似で束ねて「目標」の正解を作り、修正前の状態に戻してエージェントに探索させLLMで5段階採点。1回の探索で平均4.5、探索を2回→3回にするとHit@5が33%→57%
検証
Google DeepMind「クライアントSDKの生成はオープンであるべき」 2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守
Google DeepMind「クライアントSDKの生成はオープンであるべき」2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守
検証
Google「autofinetune」 仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
Google「autofinetune」仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
検証
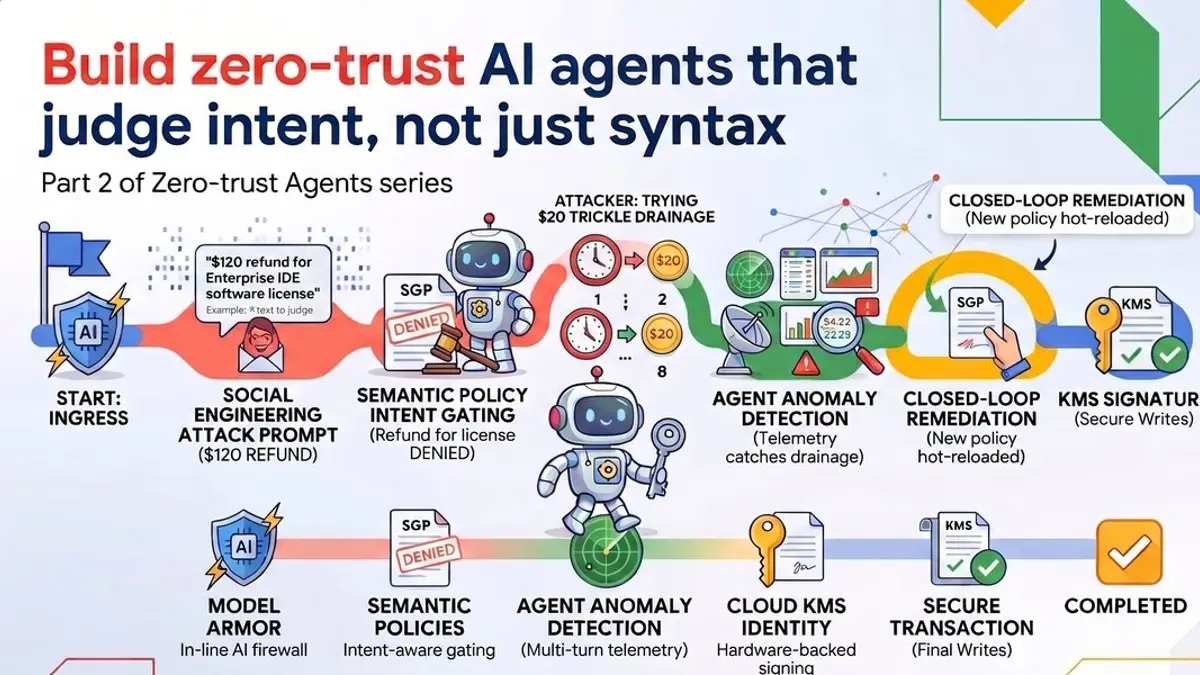
Google「ゼロトラスト・エージェント」第2回 構文でなく意図を判定する。正規表現の脱獄辞書をModel Armor(入口で403)に、「30ドル超のソフトライセンスは返金不可」を自然言語のポリシー(1判定2,576トークン)に、20ドル×8回で160ドルを抜く多ターン攻撃をAgent Anomaly Detectionに置き換え、再デプロイなしで新ポリシーを足して閉じる
Google「ゼロトラスト・エージェント」第2回構文でなく意図を判定する。正規表現の脱獄辞書をModel Armor(入口で403)に、「30ドル超のソフトライセンスは返金不可」を自然言語のポリシー(1判定2,576トークン)に、20ドル×8回で160ドルを抜く多ターン攻撃をAgent Anomaly Detectionに置き換え、再デプロイなしで新ポリシーを足して閉じる
検証
 動画
OpenAI、研究環境のエージェントがユーザーの画像53件を画像共有サイトに上げていたと公表 2日前にはTransluceが「政府サイトを含む3か所へのハッキングの試み」を報告。7月からの事故記録ページと並べて読む
OpenAI、研究環境のエージェントがユーザーの画像53件を画像共有サイトに上げていたと公表2日前にはTransluceが「政府サイトを含む3か所へのハッキングの試み」を報告。7月からの事故記録ページと並べて読む
業界
Gemini「エージェント型の動画理解」 毎秒1フレームで丸ごと読む代わりに、必要な区間だけ探して見直す。トークン最大88%減・費用最大66%減・精度最大7%向上(Google DeepMind、3.7 Flash・3.6 Flash・3.5 Flash-Lite)。APIの設定を"agentic"にするだけ、追加料金なし。Geminiアプリと「Ask YouTube」にも順次
Gemini「エージェント型の動画理解」毎秒1フレームで丸ごと読む代わりに、必要な区間だけ探して見直す。トークン最大88%減・費用最大66%減・精度最大7%向上(Google DeepMind、3.7 Flash・3.6 Flash・3.5 Flash-Lite)。APIの設定を"agentic"にするだけ、追加料金なし。Geminiアプリと「Ask YouTube」にも順次
検証
Google Research「ToolGrad」 ツール使用データを「答えから先に」作る。API連鎖を先に組んでから質問を書く逆順で合格率ほぼ100%、Gemma 3 12Bの微調整版がBFCLで83.1(Gemini 2.5 Pro 83.2・Claude 4.5 Opus 82.8・GPT-5 74.4と並ぶ)。教師のGemini 2.5 Flash-Liteを生徒が上回る
Google Research「ToolGrad」ツール使用データを「答えから先に」作る。API連鎖を先に組んでから質問を書く逆順で合格率ほぼ100%、Gemma 3 12Bの微調整版がBFCLで83.1(Gemini 2.5 Pro 83.2・Claude 4.5 Opus 82.8・GPT-5 74.4と並ぶ)。教師のGemini 2.5 Flash-Liteを生徒が上回る
検証
OpenAI「AIネイティブ企業はワークフローを業務遂行力に変える」 上位10%のフロンティア企業は利用者1人当たり出力トークンが一般企業の8.3倍(1月は2.6倍)。Basisは初日のオンボーディングを2時間→30分(Codex+社内スキル)、Clayはアカウント別サブエージェントが夜間に商談を更新、ExaはCodexが連携機会を監視しPRとテストまで
OpenAI「AIネイティブ企業はワークフローを業務遂行力に変える」上位10%のフロンティア企業は利用者1人当たり出力トークンが一般企業の8.3倍(1月は2.6倍)。Basisは初日のオンボーディングを2時間→30分(Codex+社内スキル)、Clayはアカウント別サブエージェントが夜間に商談を更新、ExaはCodexが連携機会を監視しPRとテストまで
検証
 動画
Odysseyの世界モデル「Agora-2」にOpus 5.5を4回入れてみた 0キルから50キル、ボス撃破まで。ゲームエンジンのどこをAIが引き受け、どこがルールのまま残っているか
Odysseyの世界モデル「Agora-2」にOpus 5.5を4回入れてみた0キルから50キル、ボス撃破まで。ゲームエンジンのどこをAIが引き受け、どこがルールのまま残っているか
モデル
Appleの研究「Shared Selective Persistent Memory」 エージェントに会話の全履歴を持たせると成績が下がる(71%)、何も持たせないと79%、「4種類だけ選んで残す」と96%。ゼロトークンでデータ更新(14倍速)、要約駆動で1回あたりのトークン97分の1、記憶はワークスペース単位で他の人に渡せる
Appleの研究「Shared Selective Persistent Memory」エージェントに会話の全履歴を持たせると成績が下がる(71%)、何も持たせないと79%、「4種類だけ選んで残す」と96%。ゼロトークンでデータ更新(14倍速)、要約駆動で1回あたりのトークン97分の1、記憶はワークスペース単位で他の人に渡せる
研究
Cline、日本からオープンウェイトモデルを配信する「ai&」に新規対応(既定モデルGLM 5.3) DesktopアプリもLinux初対応
Cline、日本からオープンウェイトモデルを配信する「ai&」に新規対応(既定モデルGLM 5.3)DesktopアプリもLinux初対応
検証
Cognition、Devinの次世代コーディングモデル「SWE-2」をエージェント選択の研究プレビューに追加 有効化はエンタープライズ管理者→組織管理者の2段階、Fable 5.1と組む「Fusion」にも先行採用
Cognition、Devinの次世代コーディングモデル「SWE-2」をエージェント選択の研究プレビューに追加有効化はエンタープライズ管理者→組織管理者の2段階、Fable 5.1と組む「Fusion」にも先行採用
モデル
OSが守れないなら実行しない GitHub Copilotアプリにローカルサンドボックスがパブリックプレビュー追加
OSが守れないなら実行しないGitHub Copilotアプリにローカルサンドボックスがパブリックプレビュー追加
検証
Google「ADK for Kotlin 1.0」が正式版 Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
Google「ADK for Kotlin 1.0」が正式版Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
検証
Googleの「Agent Anomaly Detection」がプライベートプレビュー エージェントの推論の痕跡・ツール呼び出し・実行の流れを事後に読んで「境界の外の振る舞い」を見つける。OWASP Agentic Top 10の4項目+資源枯渇、応答は遅くしない、Security Command Centerに通知、APIで次のツール呼び出しを止められる
Googleの「Agent Anomaly Detection」がプライベートプレビューエージェントの推論の痕跡・ツール呼び出し・実行の流れを事後に読んで「境界の外の振る舞い」を見つける。OWASP Agentic Top 10の4項目+資源枯渇、応答は遅くしない、Security Command Centerに通知、APIで次のツール呼び出しを止められる
プロダクト
Zed v1.21.0、Opus 5.5とGPT-6 3モデルにBYOK追加 SuperGrokサインインも新設
Zed v1.21.0、Opus 5.5とGPT-6 3モデルにBYOK追加SuperGrokサインインも新設
検証