Meta「Muse Ember(ミューズ エンバー)」公開単価はHaiku 5.5・GPT-6 Lunaと同じ、Metaの表では10項目中8勝、外部の総合指数はHaikuと同点を約3分の1の費用で
日刊AIニュース11月7日(土)号:前日のAIのニュース3本を短くまとめました(約5分)›
Metaは2026年11月9日(米国時間)、同社で最も小さいモデル「Muse Ember」をMeta Model APIとMuse Codeで公開した。100万トークンあたり入力0.10ドル・出力0.50ドルで、Claude Haiku 5.5・GPT-6 Lunaと同じ単価。Metaの比較表ではHaiku 5.5に10項目中8項目、GPT-6 Lunaに9項目で上回り、Artificial Analysisの総合指数はHaiku 5.5と同じ36で、1作業あたりの費用は約3分の1だった。
目次
Metaは2026年11月9日(米国時間)、同社で最も小さく効率のよいモデルとして「Muse Ember(ミューズ エンバー)」を公開した。Meta Model APIとMuse Codeで今日から使え、100万トークンあたりの単価は入力0.10ドル・出力0.50ドル。この単価はClaude Haiku 5.5・GPT-6 Lunaと同じで、Metaの比較表ではHaiku 5.5に10項目中8項目、GPT-6 Lunaに9項目で上回った。外部のArtificial Analysisの総合指数はHaiku 5.5と同じ36で、1作業あたりの費用は約3分の1だった。動画での解説は YouTube(AI時短ラボ) にある。
3行まとめ
- Meta、最小モデル「Muse Ember」(muse-ember-1.0)を公開。文脈100万トークン・出力最大512Kトークン、文章・画像・音声・動画を入力できる。Muse Wonder Fullを使って学習させた最初のモデル。
- 単価は入力0.10ドル・出力0.50ドルでHaiku 5.5・GPT-6 Lunaと同じ。Metaの表ではHaiku 5.5に8勝1敗1分(負けはFrontierCode 2.0)、GPT-6 Lunaに9勝1分。
- Artificial Analysisの総合指数はHaiku 5.5と同じ36で、1作業の費用は0.14ドル対0.41ドル。知識の正答率は21.1%と低いが、64%の質問で答えを控え、作り話の率はHaiku 5.5の半分。
本記事の数値は、日本時間11月10日3時台に取得したMetaの公式ページ(研究ブログ・評価方法の報告書・開発者ページ)、Artificial Analysisの公式X、OpenRouterのモデル一覧にもとづく。発表はマーク・ザッカーバーグCEOのXアカウントで日本時間11月10日2時54分、Artificial Analysisの評価はその約13分後に出た。
Muse Emberはどんなモデルか
Metaの研究ブログによると、Muse Emberは「エージェントが1日中くり返す仕事」向けのモデルだ。挙げているのは、ツールの呼び出し、コーディングの小さな作業、振り分け(ルーティング)、情報の抜き出し、長い文書の読み取り。難しい問題はMuse Wonderに計画させ、量の多い作業をMuse Emberにこなさせる組み合わせをMetaは勧めている。
| 項目 | 内容(Metaの公式ブログ・開発者ページ) |
|---|---|
| モデル名 | muse-ember-1.0 |
| 使える場所 | Meta Model API・Muse Code |
| 文脈長/出力 | 100万トークン/最大512Kトークン |
| 入力 | 文章・画像・音声・動画 |
| 単価(100万トークン) | 入力0.10ドル・キャッシュした入力0.004ドル・出力0.50ドル |
| 20万トークン超の入力 | 単価が3倍(開発者ページの料金表) |
| API | Responses APIに対応 |
| 学習 | Muse Wonder Fullを使って学習させた最初のモデル |
Metaはブログで、Muse WonderとMuse Wonder Fullを出した時に「それを使ってみんなに届けられる専用のモデルを作る」と言っていたと書き、Muse Emberをその最初の1つと位置づけている。
単価はHaiku・Lunaと同じ、差がつくのは1作業の費用
Metaが記事の最初に置いたのは、Artificial Analysisの総合指数と1作業あたりの費用を並べたグラフだ。推論の設定ごとに点が打たれている。
| モデル(設定) | 総合指数 | 1作業の費用 |
|---|---|---|
| Muse Ember(xhigh) | 33.9 | 0.116ドル |
| Muse Ember(max) | 35.8 | 0.136ドル |
| Claude Haiku 5.5(xhigh) | 34.3 | 0.248ドル |
| Claude Haiku 5.5(max) | 36.2 | 0.411ドル |
| GPT-6 Luna(max) | 27.8 | 0.152ドル |
Metaのブログはこう書いている。
it matches Haiku's best score at about a third of the cost and beats every Luna setting.
(Haikuの最高点に約3分の1の費用で並び、Lunaのどの設定も上回る)
ただ、グラフの値ではHaiku 5.5(max)の36.2に対してMuse Ember(max)は35.8で、「並ぶ」は四捨五入した総合指数(36対36)での話だ。Artificial Analysisも、Muse Ember(max)を「36点以上のモデルの中で最も安い(the cheapest model scoring 36 or higher)」としている。
100万トークンあたりの単価は3つとも同じだ。OpenRouterのモデル一覧では、Claude Haiku 5.5とGPT-6 Lunaはどちらも入力0.10ドル・出力0.50ドルで、Muse Emberの公式の単価と一致する。Artificial Analysisも「Haiku 5.5・GPT-6 Lunaと入出力のトークン単価が同じ」と書いている。単価が同じで1作業の費用が約3分の1になるのは、同じ作業を少ないトークンで解いているからということになる。「安いモデル」というより、「同じ値段の帯で、作業1回あたりが安いモデル」と見るほうが数字に合う。
Metaの比較表:Haiku 5.5に8勝、GPT-6 Lunaに9勝
Metaの比較表は10項目で、3つのモデルはすべて最大の推論設定(max)で比べている。
| 項目 | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA(業務の流れ) | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index(Meta独自) | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1(部分点) | 69.5 | 68.9 | 50.5 |
| PerceptionBench(道具あり) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Index | 36 | 36 | 28 |
差が一番大きいのはAutomationBench-AAで、Haiku 5.5の約2.7倍。評価方法の報告書によると、GmailやSalesforce、Slackなどを模したアプリの中で業務の流れを最後までこなす657問で、すべての目標を満たした問題だけを数える。一方、OSWorld 2.1(0.6差)、PerceptionBench(2.0差)、Terminal-Bench 4.0(1.7差)はHaiku 5.5との差が小さい。Personal Superintelligence Indexは、Metaが自分で8つの評価をまとめた社内の指数だ。
Coding Agent Index-AAは、それぞれの会社のコーディング道具に入れて測っている。報告書によると、Muse EmberはMuse Code、Haiku 5.5はClaude Code、GPT-6 LunaはCodexだ。
Haiku 5.5が上だった項目と、同点の総合指数
Metaの表でHaiku 5.5が上だったのは、実在のリポジトリでの変更が「メンテナがそのまま取り込めるか」で採点するFrontierCode 2.0で、34.9対27.2だった。
総合指数は表では36対36の同点で、グラフの細かい値ではHaiku 5.5がわずかに上だった。点数で互角、費用で大きく差がつく、というのがMetaの数字の中身になる。
Artificial Analysisの独立評価:総合は同点、知識の正答率は低い
Artificial Analysisは発表の約13分後に、自分たちで測った結果を公式Xに出した。総合指数(Intelligence Index v5.0)はMuse Ember(max)が36でHaiku 5.5(max)と同じ、GPT-6 Luna(max)は28。上位のMuse Wonder(max)は44で、Artificial Analysisは「その8点下を約50分の1の費用で取っている」と書いている。DeepSeek V4.1 Flash 1017(33点・0.60ドル)やGLM-5.3-Flash(28点・0.58ドル)と比べても、1作業の費用は約4分の1だという。
Artificial Analysisが自分で測った項目では、Haiku 5.5との勝ち負けが分かれた。
| 項目(Artificial Analysisの測定) | Muse Ember | Claude Haiku 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 40.9% | 32.8% |
| GDP.pdf | 22.8% | 20.8% |
| 作り話をする率(低いほどよい) | 17.4% | その約2倍 |
| FrontierCode 2.0 | 27.2% | 34.9% |
| AA-Briefcase(Elo) | 1521 | 1574 |
| 知識の正答率(AA-Omniscience) | 21.1% | 34.7% |
Artificial Analysisは「Knowledge is the main weakness, but it rarely hallucinates.(知識が主な弱点だが、作り話はめったにしない)」と書いている。知識の正答率21.1%は、同じくらいの賢さのモデルの中で最も低く、Gemini 3.8 Flash(high)は50.5%。理由は64%の質問で答えを控えたことで、そのぶん作り話をする率は17.4%と、Haiku 5.5の半分になった。投稿の画像では、HLE-Diamond(25%対30%)とCritPt(39%対44%)もHaiku 5.5が上だった。
筆者が並べて気づいた、同じ名前で違う数字
動画を作るために、Metaの表とArtificial Analysisの投稿を1行ずつ突き合わせたところ、同じテストの名前で数字が違う所が2つあった。
1つ目はTerminal-Bench 4.0のHaiku 5.5の値だ。Metaの表では39.2%で、Muse Emberの40.9%と1.7差の接戦に見える。ところが評価方法の報告書を読むと、この39.2%は「Haiku 5.5のシステムカードにあるAnthropic自身のClaude Codeでの結果」だった。Artificial Analysisが同じ条件で測ると32.8%で、差は8.1に広がる。同じ表の中に、測った人の違う数字が並んでいる。
2つ目はAutomationBench-AAだ。Metaの表ではMuse Emberが37.8%(すべての目標を満たした時だけ数えるStrict pass@1)だが、Artificial Analysisの投稿は68.1%で「Muse Wonderと並ぶ」と書いている。投稿の画像ではHaiku 5.5が35%、GPT-6 Lunaが53%で、Metaの表の13.9%・20.2%とも違う。数え方が違うと見て、動画ではMetaの表の値だけを使った。どちらの数え方でもMuse Emberが3つの中で一番上なのは変わらない。
Meta社内での位置づけと、先に試した会社の声
Metaはブログで、Muse Ember(max)とMuse Spark 1.3(max)を比べた表も出している。総合指数は36対37、1作業の費用は0.14ドル対2.39ドル(約17分の1)、単価は入力0.10ドル・出力0.50ドル対1.25ドル・4.25ドル。Metaは並びを「難しい問題はMuse Wonder、コーディングとエージェントの仕事はMuse Spark、大量にくり返す作業はMuse Ember」と説明している。
ブログには先に試した5社の声が載っている。いずれも各社の評価だ。
- Cloudflare(Dane Knecht CTO):比べたモデルより、遅い側の応答で最大30%速かった
- You.com(Chak Pothina氏):すべてのコーディング課題を解き、95%の応答が2.2秒以内。主要なオープンウェイトのモデルより約4〜13倍速く、出力トークンは36〜48%少なかった
- Cline(Saoud Rizwan氏):コーディングや文書分析のサブエージェントとして作られ、そこに強い
- Box・Oracleも、契約書の確認や開発の作業での手応えを書いている
安全性について書かれていること
Metaによると、公開前にMeta Superintelligence Scaling Frameworkで、化学・生物、サイバーセキュリティ、制御を失う危険を評価し、どの分野も高リスクの基準を下回った。小さいモデルでも大きいモデルと同じ中核の安全学習とテストを受けたという。人の代わりに動く時の振る舞いとして、ウェブページや文書、ツールの出力に隠された指示に乗っ取られないか、影響の大きい操作の前に人の確認を求めるかも評価したと書いている。
出典と、今回確かめていないこと
- 出典:Meta研究ブログ「Introducing Our Smallest, Most Efficient Model: Muse Ember」(2026年11月9日)/Meta「Muse Ember Evaluation Methodology」(PDF・4ページ)/Meta開発者ページ「Muse Ember」/Artificial Analysis公式X(2026年11月9日18:07 UTC)/OpenRouterのモデル一覧API(日本時間11月10日3時5分取得)
- Claude Haiku 5.5とGPT-6 Lunaの単価は、OpenRouterの掲載とArtificial Analysisの記載で確かめた。AnthropicとOpenAIの公式の料金ページは開いていない。キャッシュした入力の単価と、長い入力の単価は比べていない
- 開発者ページの料金表は、20万トークン超の行の列が「キャッシュ0.30ドル・入力0.012ドル・出力1.50ドル」の並びで載っている。20万トークン以下の行(キャッシュ0.004ドル・入力0.10ドル・出力0.50ドル)と比べると、どれも3倍にあたる
- Metaのブログは、グラフの説明でMuse Emberの費用を「提案中の価格での見積もり」と書き、グラフの注では「定価での費用」と書いている
- 日本時間11月10日3時台に確認した範囲では、OpenRouterにMuse Emberは載っておらず、Artificial AnalysisのMuse Emberのモデルページも開けなかった(404)。Hugging FaceのMetaの公開先(meta-models)にもMuse Emberは無く、公式ブログも重みの配布には触れていない
- 手元でMuse Emberを動かしてはいない。速さや費用はMetaと各社、Artificial Analysisの数字だ
関連記事:Meta Muse Wonder公開/Meta Muse Spark Open公開/Claude Haiku 5.5公開
この記事でよく聞かれること
- Muse Emberとは何ですか?
- Metaが2026年11月9日(米国時間)に公開したモデルで、Metaは同社で最も小さく効率のよいモデルとしています。エージェントがくり返すツールの呼び出し・コーディングの小さな作業・振り分け・情報の抜き出し・長い文書の読み取り向けで、文章・画像・音声・動画を入力できます。文脈は100万トークン、出力は最大512Kトークン。Metaによると、Muse Wonder Fullを使って学習させた最初のモデルです。
- Claude Haiku 5.5やGPT-6 Lunaより強いのですか?
- Metaの比較表(10項目・すべて最大の推論設定)では、Haiku 5.5を8項目で上回り、FrontierCode 2.0の1項目で下回り、Artificial Analysisの総合指数は36で同点でした。GPT-6 Lunaには9項目で上回り、GDP.pdfは同点です。外部のArtificial Analysisの総合指数ではHaiku 5.5と同じ36、GPT-6 Lunaは28です。Artificial Analysisが自分で測った項目では、Terminal-Bench 4.0やGDP.pdfはMuse Emberが上、FrontierCode 2.0・AA-Briefcase・知識の正答率はHaiku 5.5が上でした。
- 値段はHaiku 5.5より安いのですか?
- 100万トークンあたりの単価は、Muse Ember・Claude Haiku 5.5・GPT-6 Lunaとも入力0.10ドル・出力0.50ドルで同じです(Muse EmberはMeta公式、Haiku 5.5とGPT-6 LunaはOpenRouterの掲載とArtificial Analysisの記載)。違うのは1作業あたりの費用で、Metaのグラフでは最大設定のMuse Emberが0.136ドル、Haiku 5.5が0.411ドルでした。入力が20万トークンを超えると、Muse Emberの単価は3倍になります。
- どこで使えますか? 重みは公開されていますか?
- Metaの公式ブログによると、Meta Model API(モデル名muse-ember-1.0)とMuse Codeで使えます。Responses APIにも対応しています。日本時間11月10日3時台に確認した範囲では、OpenRouterには載っておらず、Hugging FaceのMetaの公開先(meta-models)にもMuse Emberは無く、公式ブログも重みの配布には触れていませんでした。
出典・参照資料
- 一次資料Introducing Our Smallest, Most Efficient Model: Muse Ember — Meta AI Research公式ブログ ↗
- 一次資料Muse Ember Evaluation Methodology — Meta ↗
- 一次資料Muse Ember — Meta 開発者ページ(料金表) ↗
- 一次資料Mark Zuckerberg(@finkd)の発表ポスト ↗
- 一次資料Artificial Analysis 公式Xの評価(2026年11月9日) ↗
- 一次資料OpenRouter モデル一覧API(Claude Haiku 5.5・GPT-6 Lunaの単価) ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
Meta「Muse Wonder(ミューズ ワンダー)」発表 公式の比較表14項目中7項目でFable 5.1・Astra・Opus 5.5を上回る、APIはOpus 5.5と同じ入力4ドル・出力20ドル
Meta「Muse Wonder(ミューズ ワンダー)」発表公式の比較表14項目中7項目でFable 5.1・Astra・Opus 5.5を上回る、APIはOpus 5.5と同じ入力4ドル・出力20ドル
 動画
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開 公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く
 動画
Claude Haiku 5.5が登場 値段はGPT-6 Lunaと1セント単位で同じ、公式の表ではLunaが載る6項目すべてで上回る
Claude Haiku 5.5が登場値段はGPT-6 Lunaと1セント単位で同じ、公式の表ではLunaが載る6項目すべてで上回る
 動画
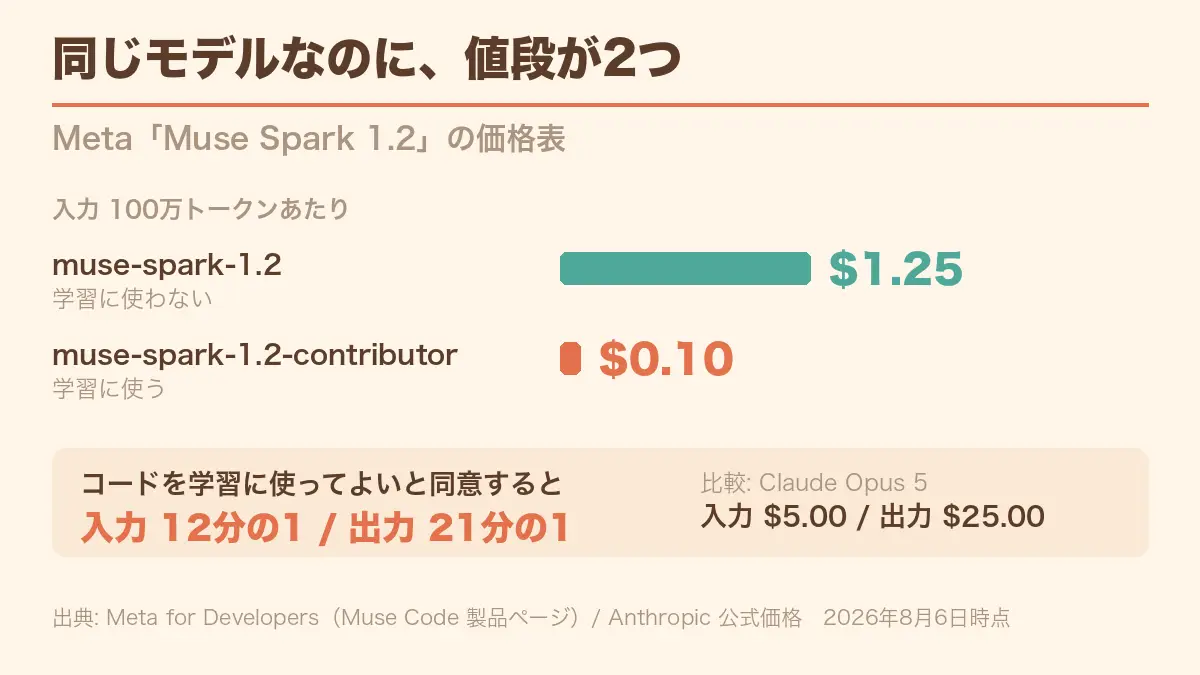
Metaが「Muse Code」を公開 Muse Spark 1.2はOpus 5の4分の1、データを渡せばさらに12分の1
Metaが「Muse Code」を公開Muse Spark 1.2はOpus 5の4分の1、データを渡せばさらに12分の1
 動画
MiniMax(ミニマックス)、新モデル「M3.1 Flash」を提供開始 入力$0.15・出力$0.60(100万トークン)、エージェント用途のコストは前世代比70%減と同社
MiniMax(ミニマックス)、新モデル「M3.1 Flash」を提供開始入力$0.15・出力$0.60(100万トークン)、エージェント用途のコストは前世代比70%減と同社
Perplexity(パープレキシティ)、Decisions API(ディシジョンズ)に27Bの「pplx-decider-v1.2」と4Bの「flash-v1.2」 入力100万トークン$0.02と$0.01、旧指定はv1.2に自動で切り替わる
Perplexity(パープレキシティ)、Decisions API(ディシジョンズ)に27Bの「pplx-decider-v1.2」と4Bの「flash-v1.2」入力100万トークン$0.02と$0.01、旧指定はv1.2に自動で切り替わる
 動画
XiaomiがMiMo-V2.6を公開 1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
XiaomiがMiMo-V2.6を公開1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
 動画