
大規模言語モデル(LLM)の記事
「大規模言語モデル(LLM)」に関連するAIニュースと解説、114本。新しい順に並べています。
大規模言語モデル(LLM) の記事:114件
【リーク】Claude Sonnet 5.5、Anthropicがステルステスト中と投稿 提携先には2つ目のチェックポイント、公開は「来週」
【リーク】Claude Sonnet 5.5、Anthropicがステルステスト中と投稿提携先には2つ目のチェックポイント、公開は「来週」
モデル
【リーク】Gemini 4 Pro、Google社内でチェックポイント「argon」が出回り始めたと投稿 出力の上限は25万6,000トークン、新しい版「barium-b」の投稿も
【リーク】Gemini 4 Pro、Google社内でチェックポイント「argon」が出回り始めたと投稿出力の上限は25万6,000トークン、新しい版「barium-b」の投稿も
モデル
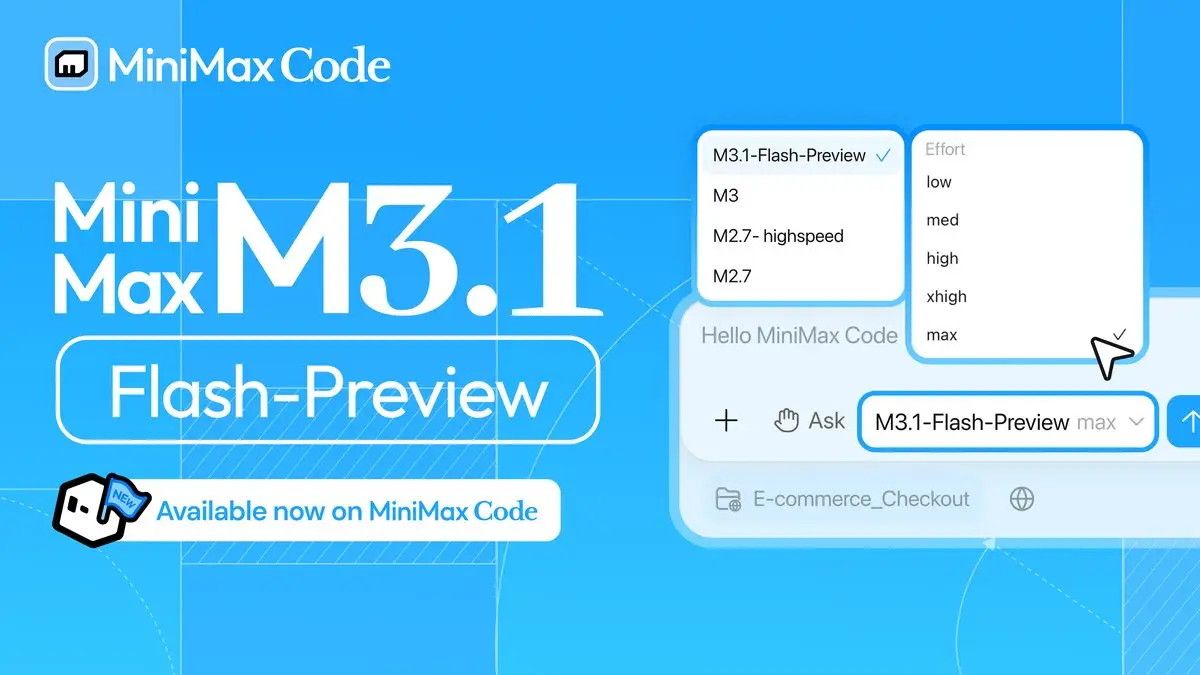
MiniMax、新モデル「M3.1-Flash-Preview」をMiniMax Codeで公開 推論の強さは5段階、前日のリークは「来週」と書いていた
MiniMax、新モデル「M3.1-Flash-Preview」をMiniMax Codeで公開推論の強さは5段階、前日のリークは「来週」と書いていた
モデル
Google Research「Retrieve-for-Train」 AI検索の「クエリ分解」を推論時に考えさせない。強化学習で一度だけ良い分解を見つけ、5,390万パラメータの拡散モデルに焼き込んで一発生成。自己回帰の12〜20倍速く、大きなバッチで50秒近くかかる処理が数秒に
Google Research「Retrieve-for-Train」AI検索の「クエリ分解」を推論時に考えさせない。強化学習で一度だけ良い分解を見つけ、5,390万パラメータの拡散モデルに焼き込んで一発生成。自己回帰の12〜20倍速く、大きなバッチで50秒近くかかる処理が数秒に
検証
Google Research「ToolGrad」 ツール使用データを「答えから先に」作る。API連鎖を先に組んでから質問を書く逆順で合格率ほぼ100%、Gemma 3 12Bの微調整版がBFCLで83.1(Gemini 2.5 Pro 83.2・Claude 4.5 Opus 82.8・GPT-5 74.4と並ぶ)。教師のGemini 2.5 Flash-Liteを生徒が上回る
Google Research「ToolGrad」ツール使用データを「答えから先に」作る。API連鎖を先に組んでから質問を書く逆順で合格率ほぼ100%、Gemma 3 12Bの微調整版がBFCLで83.1(Gemini 2.5 Pro 83.2・Claude 4.5 Opus 82.8・GPT-5 74.4と並ぶ)。教師のGemini 2.5 Flash-Liteを生徒が上回る
検証
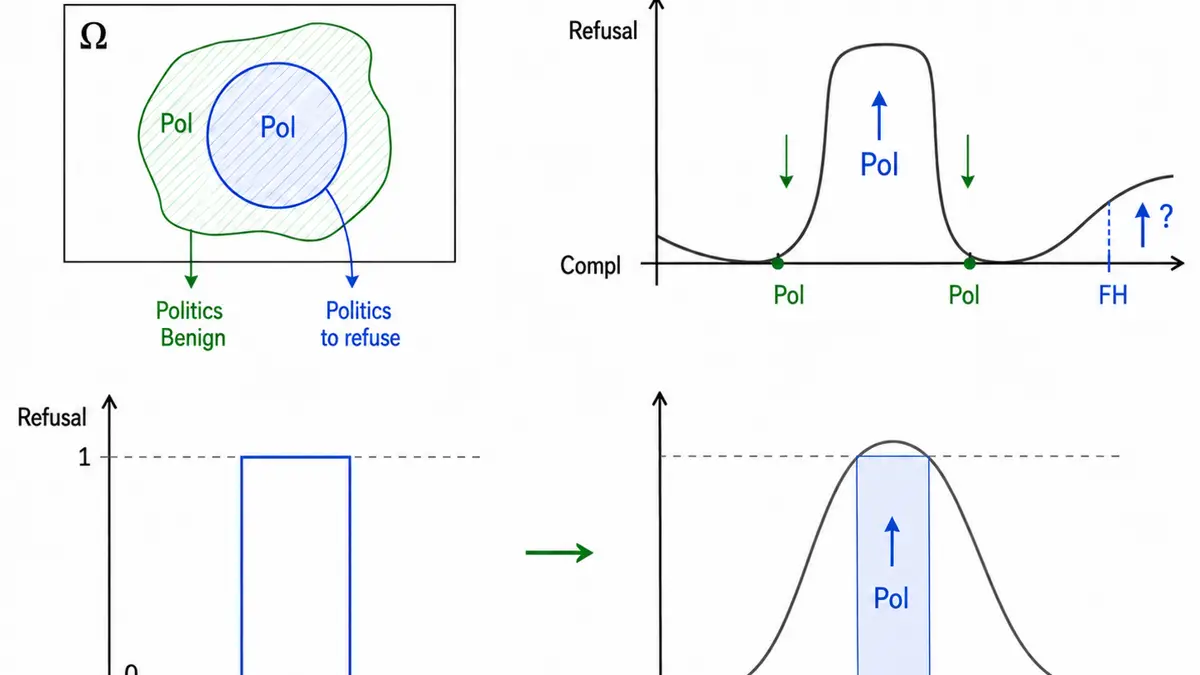
「Safety for Whom?」 安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
「Safety for Whom?」安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
検証
覆面AI「Pixel Canary」、トークン数はQwen3.5以降の語彙と95本すべて一致 名前はGoogle風でもGoogleの辞書とは24本、推論には「You are Qwen」
覆面AI「Pixel Canary」、トークン数はQwen3.5以降の語彙と95本すべて一致名前はGoogle風でもGoogleの辞書とは24本、推論には「You are Qwen」
モデル
Appleの研究「価値観を教え込むとLLMはどう変わるか」 好奇心・共感・誠実さなどの価値を選んで微調整すると、関連する別の価値(時に相反する価値)まで表れ、肯定的な価値は安全性を上げるが、どの価値でも擬人化した言葉遣いが増えて「肯定し、追従する」モデルになる
Appleの研究「価値観を教え込むとLLMはどう変わるか」好奇心・共感・誠実さなどの価値を選んで微調整すると、関連する別の価値(時に相反する価値)まで表れ、肯定的な価値は安全性を上げるが、どの価値でも擬人化した言葉遣いが増えて「肯定し、追従する」モデルになる
研究
Cognition、Devinの次世代コーディングモデル「SWE-2」をエージェント選択の研究プレビューに追加 有効化はエンタープライズ管理者→組織管理者の2段階、Fable 5.1と組む「Fusion」にも先行採用
Cognition、Devinの次世代コーディングモデル「SWE-2」をエージェント選択の研究プレビューに追加有効化はエンタープライズ管理者→組織管理者の2段階、Fable 5.1と組む「Fusion」にも先行採用
モデル
 動画
Claude Opus 5.5は本当に最強か 第三者ベンチマーク2社で総合1位、研究課題で初の人間基準超え。ただしフォールバック込みの数字と、筆者が見た「暴れ馬」の癖
Claude Opus 5.5は本当に最強か第三者ベンチマーク2社で総合1位、研究課題で初の人間基準超え。ただしフォールバック込みの数字と、筆者が見た「暴れ馬」の癖
モデル
GPT-6のプロンプトキャッシュ改善を読む 割引90%・書き込み1.25倍・TTL30分はGPT-5.6と同じ、ダッシュボードと診断ツールは8〜9月に公開済み、発表前日のガイドに無かったのはプリウォーム
GPT-6のプロンプトキャッシュ改善を読む割引90%・書き込み1.25倍・TTL30分はGPT-5.6と同じ、ダッシュボードと診断ツールは8〜9月に公開済み、発表前日のガイドに無かったのはプリウォーム
プロダクト
Sakana AI、社内で育ってきた研究グループ「Frontier Intelligence Group」を公表 Transformer論文共著者のCTO Llion Jones氏が問うポストTransformer
Sakana AI、社内で育ってきた研究グループ「Frontier Intelligence Group」を公表Transformer論文共著者のCTO Llion Jones氏が問うポストTransformer
研究
Qwen Intelligenceとは Alibabaが「AIスマホを作るメーカー向け」に出したエージェント3点セット。スマホ操作は1,000回38元、画像は1枚0.08元から。重みは非公開、リンク先で見えた数字のズレ
Qwen IntelligenceとはAlibabaが「AIスマホを作るメーカー向け」に出したエージェント3点セット。スマホ操作は1,000回38元、画像は1枚0.08元から。重みは非公開、リンク先で見えた数字のズレ
プロダクト
覆面AI「Space Bunny」、トークナイザはMiniMax M3と17対17で一致 なのに天安門を答え、「OpenAI製」と名乗る
覆面AI「Space Bunny」、トークナイザはMiniMax M3と17対17で一致なのに天安門を答え、「OpenAI製」と名乗る
モデル
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
モデル
 動画
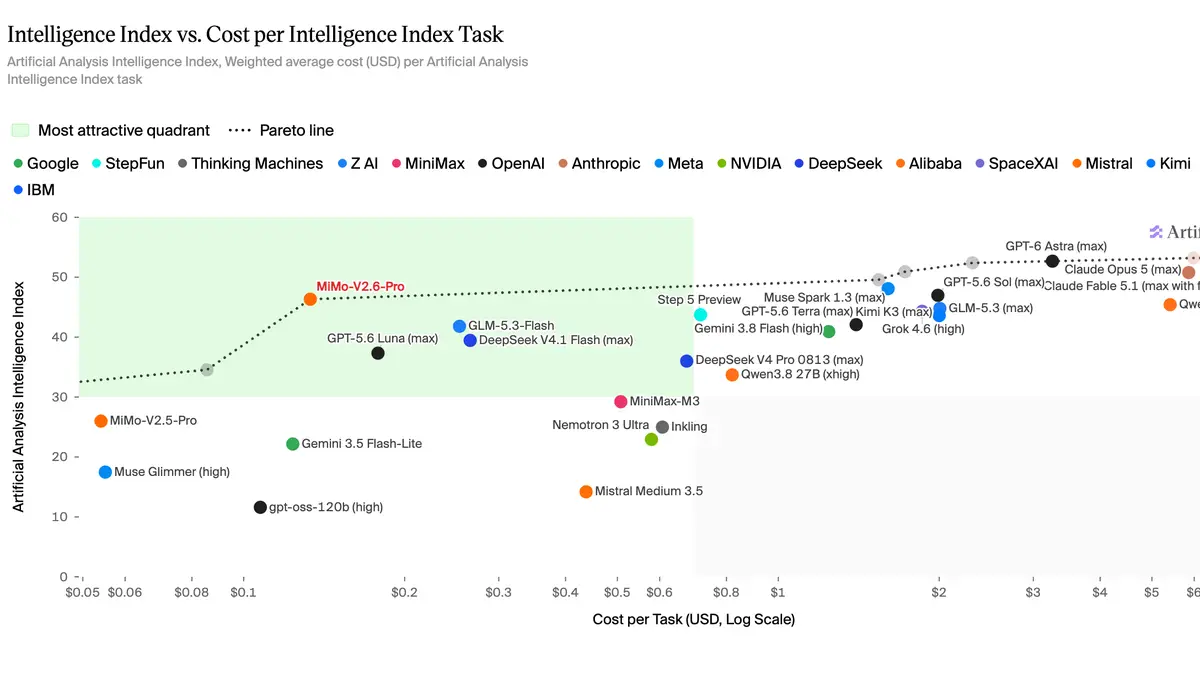
XiaomiがMiMo-V2.6を公開 1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
XiaomiがMiMo-V2.6を公開1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
モデル
 動画
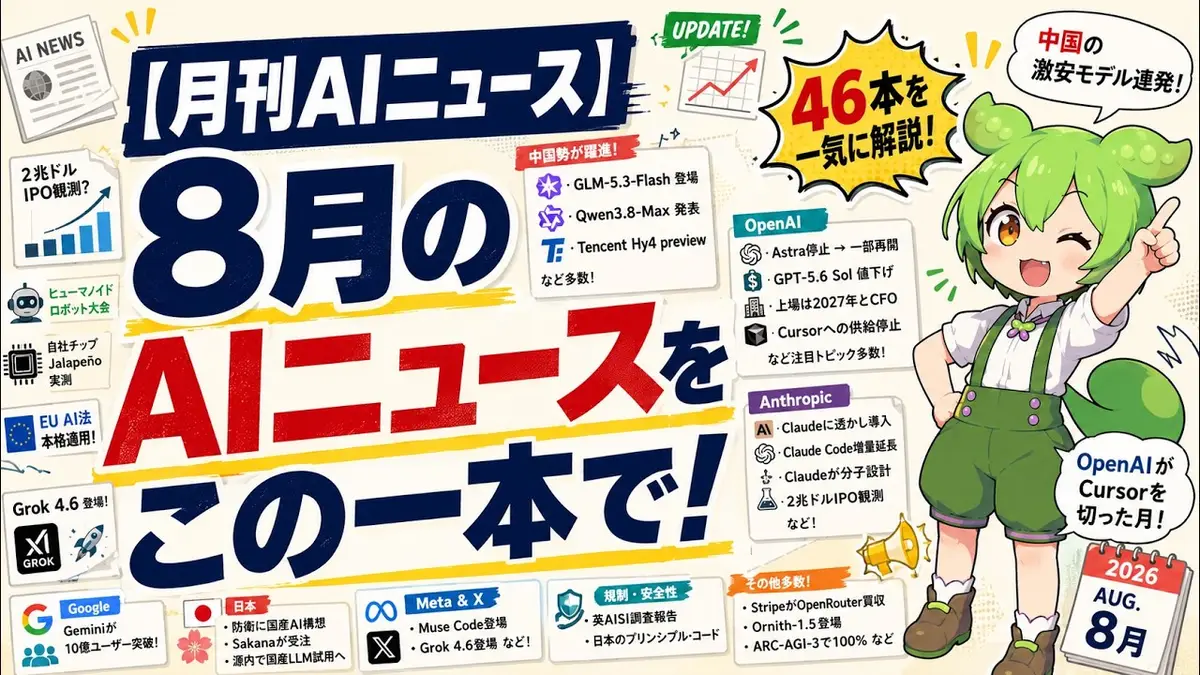
2026年8月のAIニュース46本まとめ 中国勢の激安高性能モデルが月末に集中、米2社は主力モデルなし、OpenAIがCursorを切った月【月刊AIニュース】
2026年8月のAIニュース46本まとめ中国勢の激安高性能モデルが月末に集中、米2社は主力モデルなし、OpenAIがCursorを切った月【月刊AIニュース】
業界
 動画
Alibaba、Qwen3.8-Omni-Flashを発表 音声1時間の入力が1セント未満、会議の文字起こしはDER 88.1→3.4、Gemini 3.8 Flashに音声で上・動画推論で下、重みは非公開
Alibaba、Qwen3.8-Omni-Flashを発表音声1時間の入力が1セント未満、会議の文字起こしはDER 88.1→3.4、Gemini 3.8 Flashに音声で上・動画推論で下、重みは非公開
モデル
Gemini 3.8 Liveと3.8 Live Extended Thinking公開 話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位、音声は1分あたり入力$0.005・出力$0.018
Gemini 3.8 Liveと3.8 Live Extended Thinking公開話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位、音声は1分あたり入力$0.005・出力$0.018
モデル
 動画
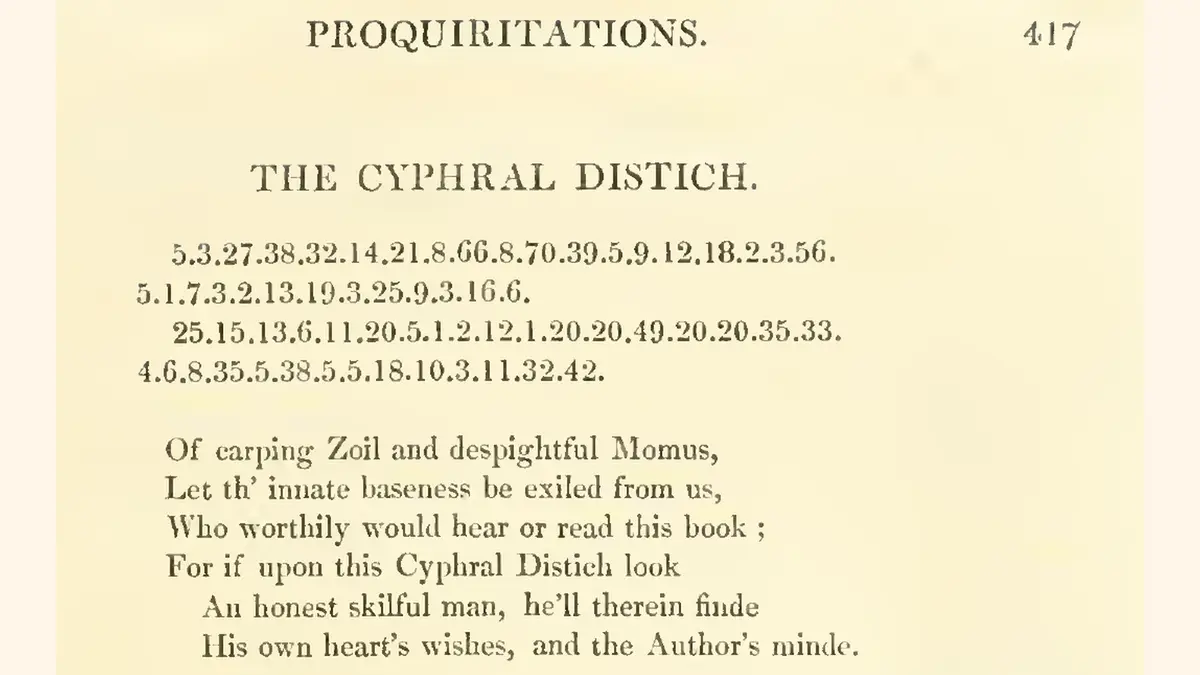
370年間誰も解けなかった暗号をFable 5.1が44分で解いた 「解けていない」という反証が出たので、1834年版の本で自分たちも検算した
370年間誰も解けなかった暗号をFable 5.1が44分で解いた「解けていない」という反証が出たので、1834年版の本で自分たちも検算した
研究実機で検証
 動画
OpenAI、「自動研究インターンに到達」と宣言 研究者1人にエージェント3.1労働日、中央値の研究者が1日600ドル、成功の過半数には人の介入。社内実測の全数字と、同じ日に主席科学者が書いた「減速」
OpenAI、「自動研究インターンに到達」と宣言研究者1人にエージェント3.1労働日、中央値の研究者が1日600ドル、成功の過半数には人の介入。社内実測の全数字と、同じ日に主席科学者が書いた「減速」
研究
 動画
今週のAIニュース(2026年9月第1週) Fable 5.1・GPT-6 Astra・Gemini 3.8 Flash・Muse Spark 1.3、フロンティア4社が同じ週に新モデルを出した7本
今週のAIニュース(2026年9月第1週)Fable 5.1・GPT-6 Astra・Gemini 3.8 Flash・Muse Spark 1.3、フロンティア4社が同じ週に新モデルを出した7本
業界
 動画
今週のAIニュース(2026年9月第2週) OpenAI「研究インターン到達」とナビエ・ストークス「解決」、数学者25人の反発、アモディ「減速」にマスク・アルトマンが同意、Proは新規停止
今週のAIニュース(2026年9月第2週)OpenAI「研究インターン到達」とナビエ・ストークス「解決」、数学者25人の反発、アモディ「減速」にマスク・アルトマンが同意、Proは新規停止
業界
 動画
ChatGPTともClaudeとも作りが違う新モデル「Jev」 文章を書かず判定だけを返すTypeSafe AIの発表を、公式ブログと評価サイトの数字で読む
ChatGPTともClaudeとも作りが違う新モデル「Jev」文章を書かず判定だけを返すTypeSafe AIの発表を、公式ブログと評価サイトの数字で読む
モデル