Liquid AI(リキッドAI)、2B級オープンウェイトのLFM3(エルエフエム・スリー)6モデルを公開LFM3-1.7BはLFM2.5-2.6Bを35%少ないパラメータで上回ると同社
日刊AIニュース10月27日(火)号:前日のAIのニュース12本を短くまとめました(約8分)›
Liquid AIは2026年10月27日、テキスト・画像動画・音声・オムニ・判断用の6モデルからなるLFM3をHugging Faceで公開した。LFM3-1.7Bは4bitで約1GB、文脈256Kトークン。LFM2.5-2.6Bより35%少ないパラメータで上回ると同社は説明している。
目次
Liquid AI(リキッドAI)は2026年10月27日(米国時間)、新世代の小型オープンウェイトモデル群「LFM3(エルエフエム・スリー)」をHugging Faceで公開した。公式ブログの公開は日本時間10月28日午前2時台。テキスト、画像・動画、音声、オムニ(画像・動画・音声の入力と音声の出力)、判断用の計6モデルで、いずれも2B(20億)パラメータ級。同社によると、テキスト版のLFM3-1.7Bは、前世代のLFM2.5-2.6Bを35%少ないパラメータで上回る。
3行まとめ
- Liquid AIがLFM3の6モデル(LFM3-1.7B/LFM3-VL-2B/LFM3-Audio-2B/LFM3-Omni-2B/d1-2B/d1-omni-2B)をHugging Faceで公開。すべてLFM3-1.7B-Baseから派生
- LFM3-1.7Bは4bitで約1GB・文脈256Kトークン。WebArena-Verifiedは38.42(LFM2.5-2.6Bは3.02)と同社
- LFM3-VL-2Bは62の画像系ベンチ平均が57.6から71.4に(同社測定)。ライセンスは「LFM Open License v1.0」で、条件の中身は今回の出典に記載なし
本記事の内容は、日本時間10月28日2時台に公式ページで確認したものです。
何が公開されたのか
公式ブログは、LFM3を「専門特化した知能の出発点」とする新世代のLiquid Foundation Models(LFM)と説明している。テキスト、画像、音声、オムニ、判断のモデルを共通の骨格(バックボーン)に載せ、すべて2Bクラスに収めたという。公式ブログによる6モデルの構成は次のとおり。
| モデル | 入力 | 出力 | 土台 |
|---|---|---|---|
| LFM3-1.7B | テキスト | テキスト | LFM3-1.7B-Base |
| LFM3-VL-2B | テキスト、画像、動画 | テキスト | LFM3骨格+視覚エンコーダ |
| LFM3-Audio-2B | テキスト、音声 | テキスト、音声 | LFM3骨格+音声エンコーダ・デコーダ・LiquidCodec |
| LFM3-Omni-2B | テキスト、画像、動画、音声 | テキスト、音声 | LFM3骨格+視覚・音声エンコーダ+音声デコーダ |
| d1-2B | テキスト、画像、動画 | 確率つきの回答 | LFM3-VL-2B |
| d1-omni-2B | テキスト、画像、動画、音声 | 確率つきの回答 | LFM3-Omni-2B |
ブログは、LFM3-Omni-2Bを同社初のオムニモデル、LFM3-VL-2Bを同社のVLモデルで初めて動画入力に対応したモデルと説明している。重みを配布する先は、Hugging Faceの「LFM3」コレクションで、事後学習前のLFM3-1.7B-Baseも含む。ブログは「今日から利用可能」としている。
前の世代と何が違うのか
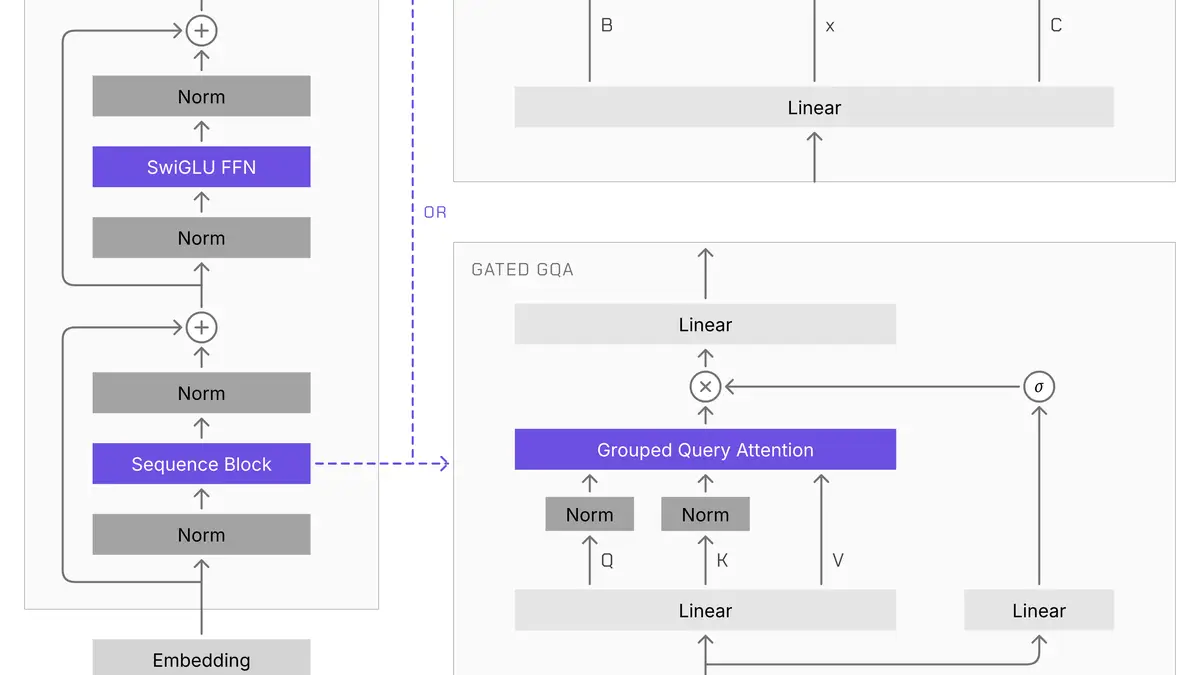
Liquid AIの説明では、LFM2は「短い畳み込みとアテンションのハイブリッド」で、端末上でも品質を落とさず速く動くことを示したモデルだった。LFM3ではその構造を、エージェント用途(少ないパラメータで高い能力、長い文脈での高速な推論)向けに作り直したという。ブログとモデルカードが挙げる変更点は次のとおり。
- 層の構成: 24層のうち、ゲート付き短い畳み込みが13層、窓幅256トークンのスライディングウィンドウ・アテンションが5層、全体を見るグローバル・アテンションが6層。畳み込みのカーネルサイズはLFM2の3から7に
- そのほかの変更: ヘッドごとのゲート付きアテンション、部分的なRoPE、各ブロックの入力と出力の両方を正規化するサンドイッチ・ノルム
- 学習: LFM3-1.7B-Baseは22兆トークンで事前学習。最後の3.5兆トークンは、エージェントのやり取りやツール呼び出しを多めにした厳選データでの中間学習で、文脈を256Kトークンまで延ばしたという
- 設計の探索: 端末とバックエンドの14通りの組み合わせ(スマートフォン、Raspberry Pi 5、ノートPC、クラウドCPU、GPU、Qualcomm Hexagon NPUなど)を対象に、実機を含めた探索で構造を決めたと説明している
速度については、パラメータあたりで見るとLFM3-1.7Bは短いプロンプトではLFM2-1.2Bと同等で、8Kトークンの文脈では約25%速い、とブログは書いている。
各モデルで同社が示した数字
以下はすべてLiquid AIの公表値で、第三者の再現は確認していない。
LFM3-1.7B(テキスト)
- パラメータは1.73B。ブログによると、LFM2.5-2.6Bを35%少ないパラメータで上回り、差が大きいのはエージェント系のタスク
- WebArena-Verifiedは38.42で、LFM2.5-2.6Bの3.02を上回る。ブラウザや業務アプリでの長いタスクではQwen3.5-9Bも上回ると書いている
- 4bit精度で約1GB。ローカルのエージェント、ツール呼び出し、構造化出力、ドメイン特化の微調整向け。Hermes Agent、Pi、OpenClawといったエージェント実行環境向けに事後学習したという
- モデルカードは、知識を多く要するタスクには検索や取得を併用するよう勧め、コーディングのエージェントや複雑な多段推論は「小さいため推奨しない」としている
LFM3-VL-2B(画像・動画)
- 1.92B(言語モデル1.73B、視覚エンコーダ164M、プロジェクタ25M)。LFM2.5-VL-3B(3.1B)より少ない1.9Bで、62の画像系ベンチマークの平均を57.6から71.4に上げ、Gemma 4 12Bと同等とブログは書いている
- 答える前に段階的に推論し、物体を見つけて配置関係を推論する。ロボット向けの基盤になるとしている
- モデルカードは、コーディング、複数ターンの会話、複雑な推論には推奨しないとしている
- 同社独自の視覚エンコーダは、同社の従来のVLモデルが使っていたSigLIP2エンコーダより計算量が3分の1とのこと
LFM3-Audio-2B(音声)
- 音声チャット、音声認識、音声合成、翻訳を18言語で扱う(ブログ記載)。英語の音声合成の品質指標UTMOSv2は3.83で、LFM2.5-Audio-1.5Bの3.22を上回る
- 音声エンコーダは完全に因果的で、話している間に先読み処理ができ、最初のトークンまでの時間は最短50ミリ秒とのこと
- 音声トークナイザーのLiquidCodecは、Apple M4 Maxの1CPUスレッドで実時間の約87倍の速さで音声に変換し、ストリーミングでの復号に対応する
LFM3-Omni-2B(オムニ)
- 2.17B。ブログによると、音声認識用モデル、VLモデル、LLM、音声合成用モデルを別々に動かす代わりに、1つで置き換えられる
- 映像と音声を同時に使うDaily-Omni、WorldSense、AV-SpeakerBenchで、Qwen2.5-Omni-7Bなど最大10.7Bのモデルを上回ったと書いている
- モデルカードでは文脈長は32Kトークンで、推論モード(enable_thinking=True)は非対応
d1-2B/d1-omni-2B(判断)
- 文章ではなく判断を返すモデル。状況(サポートチケット、請求書、アプリの画面、写真、音声メモなど)と質問の一覧を渡すと、1回の順伝播で全質問に、較正された確率つきで答える
- ブログによると、d1-2Bは前のd1-3Bよりパラメータが3分の1少なく、4つの判断ベンチマークすべてで上回る。例としてImajevBenchは64.0から75.5
- 筆者は、d1の2つのモデルカードは今回取得していない。d1については公式ブログの記述だけに基づく
誰がいつから使えるのか・日本では
公開は10月27日(米国時間)で、Hugging Faceから重みをダウンロードできる。対応する推論環境は、LFM3-1.7Bのモデルカードによると、BF16がvLLM・SGLang・Transformers、GGUFがllama.cpp・Ollama・LM Studio、Apple Silicon向けの4bit量子化がMLX、ほかにFP8、NVFP4、ONNXなど。ブログのコード例は、LFM3-1.7Bが pip install -U transformers、VLは transformers>=5.21.0、AudioとOmniは transformers>=5.20.2、d1は transformers>=5.19 を指定している。
日本語は、LFM3-1.7B、VL、Omniのモデルカードに、テキストの対応言語として載っている(英語、アラビア語、中国語、フランス語、ドイツ語、イタリア語、日本語、韓国語、ポルトガル語、スペイン語、ベトナム語、タイ語、インドネシア語、ヒンディー語、ロシア語、ポーランド語の16言語)。OmniとAudioの音声言語の一覧にも日本語が載っている。AudioとOmniのモデルカードにある多言語音声認識の数字(FLEURS、AudioはWER/CER 6.03)は、日本語を含む9言語の平均だ。一方、今回取得した6ページには、日本語だけに限った性能の数字は見当たらなかった。
料金については、今回取得した公式ブログとモデルカード4件に、価格や利用料の記載は見当たらなかった(「price」「cost」などで検索して確認)。ライセンスは4つのモデルカードとも「LFM Open License v1.0」。商用利用の可否や条件は、取得したページに本文が載っていなかったため、この記事では判断できない。
微調整とロボットの例
ブログは「LFM3は特化させるために作った」と書き、すべてのモデルが1枚のGPUで微調整できるとしている。手順はColabのノートブックで、テキストでは構造化JSONの抽出(SFT)、検索結果に基づく回答か辞退か(DPO)、108個のツールを持つスマホアプリでのツール選択(GRPO)、トルコ語の継続事前学習(CPT)が並ぶ。VLはレシート写真のJSON化と数式画像のLaTeX化、AudioとOmniは音声指示のスマートホーム関数呼び出しなど。
ロボットの例も出ている。LFM3-VL-2Bを調整して、オーケストレーション、ナビゲーション、操作の3モデルを作ったという。操作用のVLAは、15種類の機体で共同学習し、LIBEROの4スイート平均成功率96.2%、RoboCasa-GR1の卓上タスク45.7%。Jetson AGX OrinのTensorRT FP16で、行動のまとまりを50ミリ秒未満で生成すると書いている。これらも同社の数字だ。
公開直後のコレクションで見えたこと
日本時間10月28日2時21分から2時22分にかけて公式ページを取得した時点の観測を書いておく。
- LFM3コレクションの更新表示は「20分前」で、各モデルの更新は「約1時間前」から「約13時間前」。LFM3-1.7Bのダウンロード数は6.31k(モデルページのデータでは6,311)、LFM3-VL-2Bは255、LFM3-Omni-2Bは83だった。公開から数時間の数字で、評価の材料にはならない
- Audioの対応言語は、ブログが「18言語」と書く一方、モデルカードの一覧は19項目だった。数え方の違いだと思われるが、一覧には英語が英国と米国の2つに分かれて載っている。ここは筆者の推測で、公式の説明は取得したページに無い
- 筆者はLFM3を実際には動かしていない。速度、品質、メモリ量はすべて公式の記述の紹介にとどまる
数字を読むときの注意
- ベンチマークの値(WebArena-Verified、62の画像系ベンチ、UTMOSv2、Daily-Omniなど)は、Liquid AIが自社で測ったものとして公開している。比較相手の設定や評価条件の詳細は、取得したページの範囲では確認しきれていない
- 「Qwen3.5-9Bを上回る」「Gemma 4 12Bと同等」は、ブログの文言のとおり。どのタスクで、という限定がつく
- d1の2つのモデルカードは今回の取得対象外。d1の説明はブログに依拠している
- 公式ブログ末尾の引用例には「www.liquid.ai/blog/lfm3」がある。このページは今回取得していない
同社は10月13日にLFM2.5-24B-A2Bも公開している。前世代の動きはLFM2.5-24B-A2Bの記事にまとめた。
取得した6ページ
- Build specialized multimodal models with LFM3(Hugging Face公式ブログ)
- LiquidAI/LFM3-1.7B
- LiquidAI/LFM3-VL-2B
- LiquidAI/LFM3-Omni-2B
- LiquidAI/LFM3-Audio-2B
- LFM3コレクション
確認した時刻は、日本時間2026年10月28日2時21分〜2時22分です。本記事は続報があり次第更新します。
この記事でよく聞かれること
- LFM3とは何ですか?
- Liquid AIが2026年10月27日に公開した、2B(20億)パラメータ級のオープンウェイトモデル群です。公式ブログによると、テキストのLFM3-1.7B、画像・動画入力のLFM3-VL-2B、音声のLFM3-Audio-2B、画像・動画・音声入力で音声も出せるLFM3-Omni-2B、判断用のd1-2Bとd1-omni-2Bの計6モデルで、すべてLFM3-1.7B-Baseから派生しています。
- LFM3-1.7Bはどのくらいのメモリで動きますか?
- モデルカードによると、4bit精度で約1GBのメモリを使い、スマートフォンやノートPCに収まるとされています。文脈長は入力と出力の合計で256Kトークンです。ただしこれはLiquid AIの説明で、筆者は実機で動かしていません。
- LFM3は日本語に対応していますか?
- テキストモデルLFM3-1.7Bのモデルカードには、対応言語として日本語を含む16言語が載っています。LFM3-Omni-2BとLFM3-Audio-2Bの音声言語にも日本語が載っています。音声認識の多言語ベンチマーク(FLEURS)の平均には日本語を含む9言語が入っていますが、日本語だけの数字は、今回取得したページには見当たりませんでした。
- LFM3は商用で使えますか?
- 4つのモデルカードのライセンス欄は「LFM Open License v1.0」です。ただし、商用利用の可否や条件の中身は、今回取得したページには書かれていませんでした。使う前にライセンス本文の確認が必要です。
出典・参照資料
- 一次資料Build specialized multimodal models with LFM3 — Liquid AI(Hugging Face公式ブログ) ↗
- 一次資料LiquidAI/LFM3-1.7B — Liquid AI公式モデルカード ↗
- 一次資料LiquidAI/LFM3-VL-2B — Liquid AI公式モデルカード ↗
- 一次資料LiquidAI/LFM3-Omni-2B — Liquid AI公式モデルカード ↗
- 一次資料LiquidAI/LFM3-Audio-2B — Liquid AI公式モデルカード ↗
- 一次資料LFM3 コレクション — Liquid AI(Hugging Face) ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開 8Bと30B、VRAMは基本モデルとほぼ同じと説明
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開8Bと30B、VRAMは基本モデルとほぼ同じと説明
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開 LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
 動画
ドイツ製AI「Kolibri」を手元のMacで動かした 78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
ドイツ製AI「Kolibri」を手元のMacで動かした78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
Hugging Face、Swift向けAnyLanguageModel(エニーランゲージモデル)1.0を公開 importを差し替えるだけで端末内モデルとOpenAI・Anthropic・Geminiを切り替え、swift-huggingface・swift-xetも1.0に
Hugging Face、Swift向けAnyLanguageModel(エニーランゲージモデル)1.0を公開importを差し替えるだけで端末内モデルとOpenAI・Anthropic・Geminiを切り替え、swift-huggingface・swift-xetも1.0に
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開 MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6