
ローカルAIの記事
「ローカルAI」に関連するAIニュースと解説、32本。新しい順に並べています。
ローカルAI の記事:32件
Google「EmbeddingGemma 2」公開 文字・画像・動画・音声を1つのベクトルにする7.4億パラメータのオープンモデル、手元のMacで日本語の検索を試した
Google「EmbeddingGemma 2」公開文字・画像・動画・音声を1つのベクトルにする7.4億パラメータのオープンモデル、手元のMacで日本語の検索を試した
モデル
 動画
ドイツ製AI「Kolibri」を手元のMacで動かした 78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
ドイツ製AI「Kolibri」を手元のMacで動かした78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
モデル実機で検証
Gemma 4 12BをMacのローカルで「エージェント用の土台」にする Google AI Edgeの手順。LiteRT-LM CLIの新コマンド`serve`でOpenAI互換のローカルサーバーを立て、OpenClaw・Hermes・OpenCode・Aiderをそのまま向ける。AI Edge GalleryのmacOS版はPythonを書いて実行、Eloquentは音声で書き換え
Gemma 4 12BをMacのローカルで「エージェント用の土台」にするGoogle AI Edgeの手順。LiteRT-LM CLIの新コマンド`serve`でOpenAI互換のローカルサーバーを立て、OpenClaw・Hermes・OpenCode・Aiderをそのまま向ける。AI Edge GalleryのmacOS版はPythonを書いて実行、Eloquentは音声で書き換え
検証
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
検証
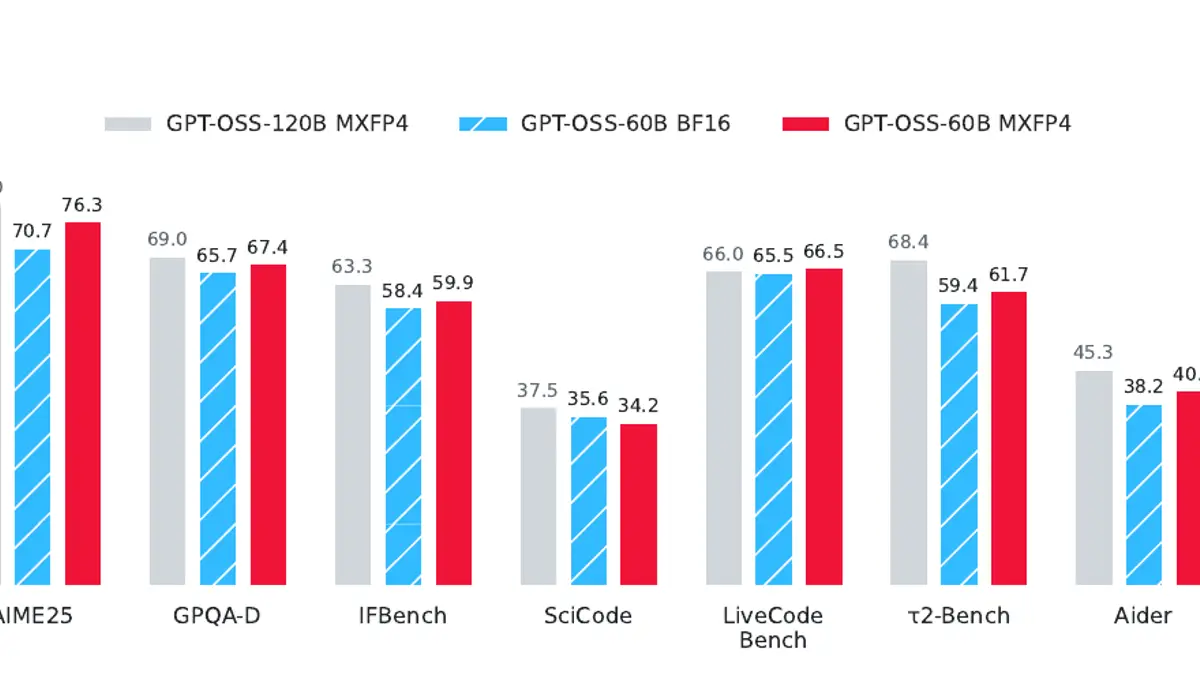
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
検証
Hugging Face「funes」 Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
Hugging Face「funes」Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
検証
Hugging Face「@huggingface/kernels」 ブラウザ推論の土台として、207本のWebGPUカーネルを1本ずつ版つきリポジトリ(契約・WGSLテンプレート・正当性テスト・ベンチマーク)としてHubで公開(Apache 2.0)。`getKernel`でHubから直接読み込み、「Fleet」で来訪者のGPUでの正当性と速度の証拠を同意のうえで集める
Hugging Face「@huggingface/kernels」ブラウザ推論の土台として、207本のWebGPUカーネルを1本ずつ版つきリポジトリ(契約・WGSLテンプレート・正当性テスト・ベンチマーク)としてHubで公開(Apache 2.0)。`getKernel`でHubから直接読み込み、「Fleet」で来訪者のGPUでの正当性と速度の証拠を同意のうえで集める
検証
NVIDIA「Magpie TTS Multilingual」 3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
NVIDIA「Magpie TTS Multilingual」3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
検証
ClaudeがAppleの「Foundation Modelsフレームワーク」に対応 Swiftパッケージで、端末内モデルで済む要約・抽出はAppleのモデル、多段の推論・コード生成・Web検索・コード実行はClaudeへ引き渡し、@Generableの型付き出力をそのまま渡してSwiftUIの同じ画面にストリーミング。iOS 27・macOS 27・visionOS 27・watchOS 27
ClaudeがAppleの「Foundation Modelsフレームワーク」に対応Swiftパッケージで、端末内モデルで済む要約・抽出はAppleのモデル、多段の推論・コード生成・Web検索・コード実行はClaudeへ引き渡し、@Generableの型付き出力をそのまま渡してSwiftUIの同じ画面にストリーミング。iOS 27・macOS 27・visionOS 27・watchOS 27
検証
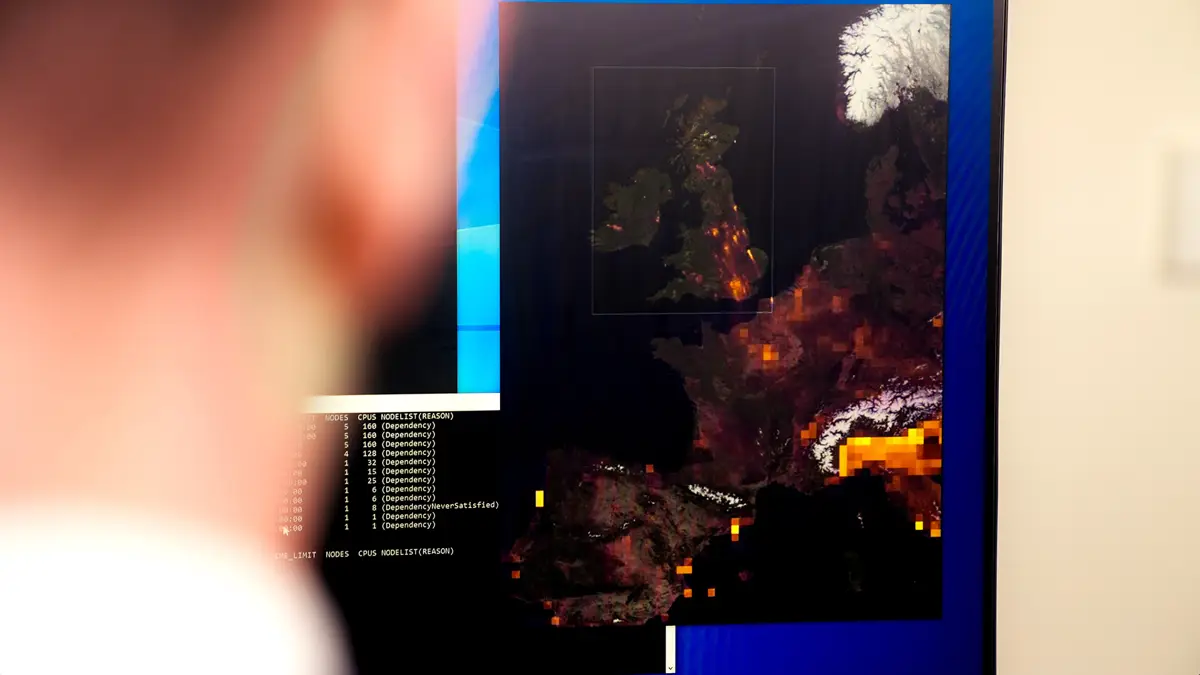
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル 天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
検証
NVIDIA、IFA 2026でローカルAIの4本 Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
NVIDIA、IFA 2026でローカルAIの4本Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
検証
Raspberry Pi 5でGemma 4 E2Bをオフライン実行 LiteRT-LMでプリフィル99トークン/秒・デコード9トークン/秒・ピークメモリ1,432MB、生成は約300語/分(人の会話の2倍)。GPUにYOLOの物体検出を逃がし、CPUでMoonshineの音声認識・Gemma・TTSを回すReachy Miniロボットの構成。pip install litert-cliで開始
Raspberry Pi 5でGemma 4 E2Bをオフライン実行LiteRT-LMでプリフィル99トークン/秒・デコード9トークン/秒・ピークメモリ1,432MB、生成は約300語/分(人の会話の2倍)。GPUにYOLOの物体検出を逃がし、CPUでMoonshineの音声認識・Gemma・TTSを回すReachy Miniロボットの構成。pip install litert-cliで開始
検証
Google「LiteRT.js」 .tfliteモデルをブラウザで動かすJavaScript版LiteRT。TensorFlow.jsのJSカーネルでなくネイティブのランタイムをWebAssemblyで提供し、CPU(XNNPACK)・GPU(WebGPU)・NPU(WebNN)を使い分け。他のWebランタイム比で最大3倍、CPU比でGPU/NPUは5〜60倍
Google「LiteRT.js」.tfliteモデルをブラウザで動かすJavaScript版LiteRT。TensorFlow.jsのJSカーネルでなくネイティブのランタイムをWebAssemblyで提供し、CPU(XNNPACK)・GPU(WebGPU)・NPU(WebNN)を使い分け。他のWebランタイム比で最大3倍、CPU比でGPU/NPUは5〜60倍
検証
Google「ADK for Kotlin 1.0」が正式版 Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
Google「ADK for Kotlin 1.0」が正式版Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
検証
Perplexityのローカル版エージェント「Portable Computer」がWindowsに RTX/RTX PROのVRAM 24GB以上で、Qwen3.8-27Bをローカルで動かして多段階の仕事をこなし、機密データは端末に残しクレジットも消費しない。クラウドに送るときは許可を求める
Perplexityのローカル版エージェント「Portable Computer」がWindowsにRTX/RTX PROのVRAM 24GB以上で、Qwen3.8-27Bをローカルで動かして多段階の仕事をこなし、機密データは端末に残しクレジットも消費しない。クラウドに送るときは許可を求める
プロダクト
 動画
Alibaba、Qwen-Image-2.1の重みを公開 絵を描く部分は7B、自社ベンチで29モデル中7位(Nano Banana 2.0より上)、透明PNGと参照10枚の編集を1モデルで。ライセンスは研究限定
Alibaba、Qwen-Image-2.1の重みを公開絵を描く部分は7B、自社ベンチで29モデル中7位(Nano Banana 2.0より上)、透明PNGと参照10枚の編集を1モデルで。ライセンスは研究限定
モデル
Qwen3.8-27Bが公開 1枚のGPUに収まる密モデルで動画も読める、ダウンロード330万回・likes 1.3万で中国勢8月最多
Qwen3.8-27Bが公開1枚のGPUに収まる密モデルで動画も読める、ダウンロード330万回・likes 1.3万で中国勢8月最多
モデル
手元のメモリを99.998%まで使い切る量子化ツール「shoehorn」 プリセットGGUFをやめる発想
手元のメモリを99.998%まで使い切る量子化ツール「shoehorn」プリセットGGUFをやめる発想
検証
Metaが「Muse Glimmer」を公開 Muse Sparkを30Bに蒸留、Apache 2.0でローカル実行専用
Metaが「Muse Glimmer」を公開Muse Sparkを30Bに蒸留、Apache 2.0でローカル実行専用
モデル
Ollamaユーザー向けのデスクトップアプリ「ChatOSS」 ローカルモデルでコード・カンバン・独自アプリを1画面にまとめる
Ollamaユーザー向けのデスクトップアプリ「ChatOSS」ローカルモデルでコード・カンバン・独自アプリを1画面にまとめる
検証
Mac Studio M5 Ultra、512GBモデルは10月下旬発送 「284BのDeepSeekが動く」は誰も実測していない
Mac Studio M5 Ultra、512GBモデルは10月下旬発送「284BのDeepSeekが動く」は誰も実測していない
プロダクト
壊れたツール呼び出しを自動修復する Unsloth Desktopの「Self-healing tool calling」を公式の実測データで読む
壊れたツール呼び出しを自動修復するUnsloth Desktopの「Self-healing tool calling」を公式の実測データで読む
検証
話し言葉を整った文章に変換するGoogleの新AI「Eloquent」 サブスクなし・オフライン動作の音声入力アプリ
話し言葉を整った文章に変換するGoogleの新AI「Eloquent」サブスクなし・オフライン動作の音声入力アプリ
プロダクト
巨大MoEモデルを「誰も全部持たない」まま動かす P2Pスワーム推論エンジンLumabri
巨大MoEモデルを「誰も全部持たない」まま動かすP2Pスワーム推論エンジンLumabri
検証