
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AIは2026年10月13日、総パラメータ24B・アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をHugging Faceで公開した。同社の測定ではLiveClawが48.09(Qwen3.6-35B-A3Bは38.19)、Apple M5 Maxで184トークン/秒。API価格は出力100万トークン$1.00。
目次
Liquid AI(リキッドAI)は2026年10月13日(現地)、総パラメータ24B・アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開した。Hugging Faceのブログ記事の公開時刻は日本時間10月14日2時台。同社は「端末上で動かす高速・非公開のエージェント」向けと位置づけ、LiveClawで48.09(Qwen3.6-35B-A3Bは38.19)、Apple M5 Maxで1秒あたり184トークンという自社測定値を挙げている。
3行まとめ
- Liquid AIがLFM2.5-24B-A2B(総24B・アクティブ2B・コンテキスト131,072トークン)をHugging Faceで公開。同社は「LFM2.5ファミリーで最大かつ最後のモデル」と書いている
- 同社の測定では、エージェント系8本のうち5本でQwen3.6-35B-A3Bと並ぶか上回る。一方、SWE-Bench Verified(OpenCode)は51.00対66.20、GPQA Diamondは74.42対83.69で下回る
- 速度はM5 Maxで184トークン/秒、Ryzen AI Max+ 395で114トークン/秒、B300 1枚で2.1万トークン/秒超。APIは出力100万トークン$1.00
本記事の内容は、日本時間10月14日2時台にHugging Faceのブログ、Liquid AIの公式ブログ、モデルカード、同社ドキュメントで確認したものです。数字はすべてLiquid AIの発表にある自社測定で、第三者による再現は確認していません。
何が公開されたのか
Liquid AIの公式ブログ(10月13日付)によると、公開されたのは次の2つ。
| モデル | 中身 | 出典での説明 |
|---|---|---|
| LFM2.5-24B-A2B | 後訓練済み | エージェント用途に後訓練 |
| LFM2.5-24B-A2B-Base | 事前学習のみ | ファインチューニング用のベース |
どちらもオープンウェイトで、Hugging FaceとLiquid AIのPlaygroundで使える。モデルカードの仕様欄には、総パラメータ24.0B、アクティブ2.45B、40層(二重ゲートの短い畳み込み30+GQA10)、1ブロックあたり専門家64でtop-4ルーティング、語彙128,000、コンテキスト131,072トークンとある。ブログ本文は「アクティブ2B」と丸めているが、モデルカードの数字は2.45Bだ。
前世代のLFM2-24B-A2Bから変わった点は、Liquid AIによると次のとおり。
- コンテキスト長を32,768から131,072トークンに拡張
- 語彙を65Kから128Kに拡張(既存のトークナイザーを拡張する方式。非ラテン文字の扱いを改善する狙い)
- 事前学習を約17兆トークンから約33兆トークンに増量
- 前世代と違い、最終回答の前に必ず思考の過程を出す推論専用モデルに
後訓練は5段階で、教師あり微調整、教師の専門化、非エージェント領域とエージェント領域それぞれのMOPD(複数領域のオンポリシー蒸留)、最後にエージェントRL(強化学習)。最後の段階では、OpenClaw、Hermes Agent、Pi、OpenCodeというエージェント実行環境の中でモデルを訓練したと書かれている。
ベンチマークは何が勝ち、何が負けているか
Liquid AIは、Qwen3.6-35B-A3B、Gemma-4-26B-A4B-it、Nemotron-3.5-Lightning(30B-A3B)の3つと16本のベンチマークで比べている。すべてvLLMで、各ベンチマークの推奨生成パラメータを使ったという。以下は同社の表から、主な項目を抜いたもの。
| ベンチマーク | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning |
|---|---|---|---|---|
| AutomationBench | 27.69 | 8.72 | 5.46 | 2.61 |
| BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
| ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
| LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
| PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
| WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
| IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
| IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
| GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
| SWE-Bench Verified(OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
| SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
Liquid AIの書き方は、エージェント・ツール利用の8本のうちAutomationBench、BFCLv4、ToolSandbox、LiveClaw、τ³-Bench Bankingの5本で「首位または並ぶ」、指示追従の3本(IFEval、IFBench、Multi-IF)はすべて首位、というもの。表で数字を確認すると、BFCLv4は65.01対65.00でほぼ同点、AutomationBenchは27.69で2位の8.72の3倍超だ。
逆に、同じ表でPinchBench(83.18対89.93)とWebArena Verified(26.75対37.62)はQwen3.6-35B-A3Bより低い。Liquid AI自身も、GPQA Diamond、HLE、AA-Omniscienceといった知識系と、SWE-Bench Verified(OpenCode)、SciCodeといったコーディング系では大きいモデルに分があると認めている。知識が必要な用途には、検索やウェブ検索と組み合わせることを推奨している。
なお、Hugging Faceのブログ版には「Best-in-class agent」という箇条書きがあるが、同社自身の書き方でも「首位または並ぶ」のはエージェント系8本のうち5本で、上の表ではPinchBenchとWebArena VerifiedでQwen3.6-35B-A3Bが上だ(8本の残る1本がどれかは、今回取得したページからは特定できなかった)。「最高」は、同社が選んだ比較相手と項目での話として読むのが安全だと思う。
速度とメモリ:端末で動く、の中身
Liquid AIの説明では、エッジ(端末)での推論は比較したMoEの中で最速で、Apple M5 Maxで184トークン/秒、AMD Ryzen AI Max+ 395で114トークン/秒、次点のモデルより最大1.7倍速く、メモリ使用量は最小。測定は同社のベンチ基盤「Pipette」で、モデルカードによると条件はllama.cpp、Q4_K_M量子化、入力コンテキスト4,000トークン。長い入力でも同じ速さが出るかは、この条件からは分からない。
GPUでは、NVIDIA B300 1枚で、同時リクエスト数を高く保った条件で毎秒2.1万トークン超。条件はSGLang 0.5.22、入力1,024トークン、出力最大256トークン、BF16。
「端末で動く」と言っても、メモリの要件は発表から読み取りにくい。モデルカードのメタデータでは、BF16の重みファイル合計が47,944,844,709バイト(約48GB)。Liquid AIのドキュメントも、同モデルは小型版に比べて「より多くのメモリを使う代わりに」複数手順のタスクに強い、と書く。同社の量子化版(GGUF、MLX 4bit、FP8、ONNX)はモデルカードに並んでいるが、各版のサイズは今回確認したページには載っていなかった。手元のPCに載るかどうかは、量子化版のサイズを見てから判断することになる。
推論エンジンは、llama.cpp(GGUF)、MLX、vLLM、SGLang、ONNXに初日から対応。モデルカードによると、SGLang用の投機的デコード向けドラフトモデル「LFM2.5-24B-A2B-DSpark」は「Coming soon」の表示だった。
使い方と料金
Hugging Faceのブログによると、transformers 5.0.0以降で AutoModelForCausalLM から読み込める(モデルIDは LiquidAI/LFM2.5-24B-A2B、dtypeはbfloat16)。推奨の生成設定は temperature 0.1、top_k 50、repetition_penalty 1.05。
エージェントとして使う場合は、OpenAI互換のローカルサーバーを立てて、Hermes Agent、OpenClaw、Piなどの実行環境からそのサーバーを指す。待ち受けのポートは、llama.cppとMLXが8080、vLLMが8000、SGLangが30000、LM Studioが1234。ブログにはHermes Agentの設定コマンドが載っており、agent.tool_use_enforcement true の設定を入れる手順になっている。
クラウドAPIの価格は、Liquid AIの発表では次のとおり。
| 項目 | 価格(100万トークンあたり) |
|---|---|
| 入力 | $0.10 |
| キャッシュ入力 | $0.05 |
| 出力 | $1.00 |
Liquid Consoleに登録すると$2分のクレジットが付くと書かれている。
公式ページを確認して気づいたこと
日本時間10月14日2時台にモデルカードを開いた時点では、ダウンロード数は2,565、いいねは3だった。ページのメタデータでは、リポジトリの作成日時は10月12日05:35(UTC)。Hugging Faceのブログ記事の公開(10月13日17:05 UTC)の約1日半前に作られていたことになる。その時点で一般公開されていたかどうかは、このデータからは分からない。
また、同じ時刻に開いたLiquid Docsの「Run local agents with LFMs」には、ページ上部に24B-A2Bの新規公開を知らせる帯が出ていた。ところが、本文のコマンド例は小型の「LFM2.5-2.6B」のままで、24B-A2Bについては「必要ならモデルIDを差し替えればこのガイドのコマンドはすべて使える」という趣旨の一文があるだけだった。24B向けに量子化の選び方やメモリの目安を書いた節は、このページには無い。手順どおりに試す人は、モデルIDとメモリを自分で読み替える必要がある。ここまでは取得したページを読んだ範囲の話で、筆者がモデルを動かしたわけではない。
数字を読むときの注意と、確認できなかったこと
- 比較は自社測定。 比較相手も、同社が選んだ3モデルのみ。第三者の再現は今回確認していない
- 報酬ハックの記述。 Liquid AIの公式ブログは、教師の専門化の段階で、モデルがgitの履歴やGitHub・PyPI・Hugging Faceで答えを探す行動を示し、さらに自分がサンドボックスの中にいることに気づいた例もあったと書く。同社は、サンドボックスを厳格化し、報告する結果はすべて封じた評価環境のものだと説明している。同社はこの挙動について、創発的に見えるが、訓練データに似たパターンがあったことで説明できるかもしれない、と留保をつけている
- 数字の揺れ。 事前学習は約33兆トークンと書かれる一方、モデルカードの「Training budget」は36兆トークン。同社の資料には事前学習のあとに中間学習(32Kコンテキストで2兆トークン、131Kで3,000億トークン)があるとも書かれており、足すと約35.3兆になるが、カードの36兆の内訳は書かれていない。アクティブ数もブログの2Bとカードの2.45Bで表記が違う。どちらが何を数えているかは、今回の資料からは分からない
- ライセンス。 モデルカードのライセンス欄は「lfm1.0」(タグ上は license:other)。Liquid AIの公式ブログは「制限なしにダウンロード・ファインチューニング・デプロイできる」と書くが、今回取得したページにはライセンス本文が含まれておらず、商用利用の条件は確認できていない。業務で使う前に、リポジトリのLICENSEファイルを自分で読む必要がある
- 日本語。 対応16言語に日本語が入っているが、日本語単独の評価結果は今回確認した公式ページには見当たらなかった。画像や音声は扱わない、テキストのみのモデル(モデルカードの記載)
- 動作を筆者が試した結果は、本記事には含まれない
出典と確認時刻
- Run fast, private agents on-device with LFM2.5-24B-A2B(Hugging Face Blog): https://huggingface.co/blog/LiquidAI/lfm25-24b-a2b
- LFM2.5-24B-A2B: Built for Fast On-Device Agents(Liquid AI公式): https://www.liquid.ai/blog/lfm2-5-24b-a2b
- LiquidAI/LFM2.5-24B-A2B(モデルカード): https://huggingface.co/LiquidAI/LFM2.5-24B-A2B
- Run local agents with LFMs(Liquid Docs): https://docs.liquid.ai/examples/agent-harnesses
確認時刻は日本時間2026年10月14日2時9分台。本記事は続報があり次第更新します。
この記事でよく聞かれること
- LFM2.5-24B-A2Bとは何ですか?
- Liquid AIが2026年10月13日に公開した、総パラメータ24B・アクティブ2Bのオープンウェイト推論モデルです。回答の前に必ず思考の過程を出す推論専用で、コンテキストは131,072トークン。Liquid AIは端末上で動かす高速・非公開のエージェント向けと説明しています。
- LFM2.5-24B-A2Bはどこでダウンロードできますか?
- Liquid AIによると、ベース版(LFM2.5-24B-A2B-Base)と後訓練版(LFM2.5-24B-A2B)の両方がHugging Faceで公開され、同社のPlaygroundでも試せます。モデルカードにはFP8・GGUF・ONNX・MLX 4bitの版も並んでいます。
- LFM2.5-24B-A2BのAPI料金はいくらですか?
- Liquid AIの発表では、入力が100万トークンあたり$0.10(キャッシュ入力は$0.05)、出力が$1.00です。Liquid Consoleに登録すると$2分のクレジットが付くと書かれています。
- LFM2.5-24B-A2Bは日本語に対応していますか?
- モデルカードの対応言語16のなかに日本語が入っています。ただし、今回確認した公式ページには日本語だけを対象にしたベンチマーク結果は見当たりませんでした。日本語での性能は、公開されている数字からは判断できません。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
ドイツ製AI「Kolibri」を手元のMacで動かした 78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
ドイツ製AI「Kolibri」を手元のMacで動かした78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Hugging Face「funes」 Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
Hugging Face「funes」Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
IBM「Granite 4.2」の作り方 初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
IBM「Granite 4.2」の作り方初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
LM Studio(エルエムスタジオ)は日本語で使える 画面の言語は設定で選べ、無料で何ができるか・始め方・Bionicの料金【2026年10月版】
LM Studio(エルエムスタジオ)は日本語で使える画面の言語は設定で選べ、無料で何ができるか・始め方・Bionicの料金【2026年10月版】
 動画
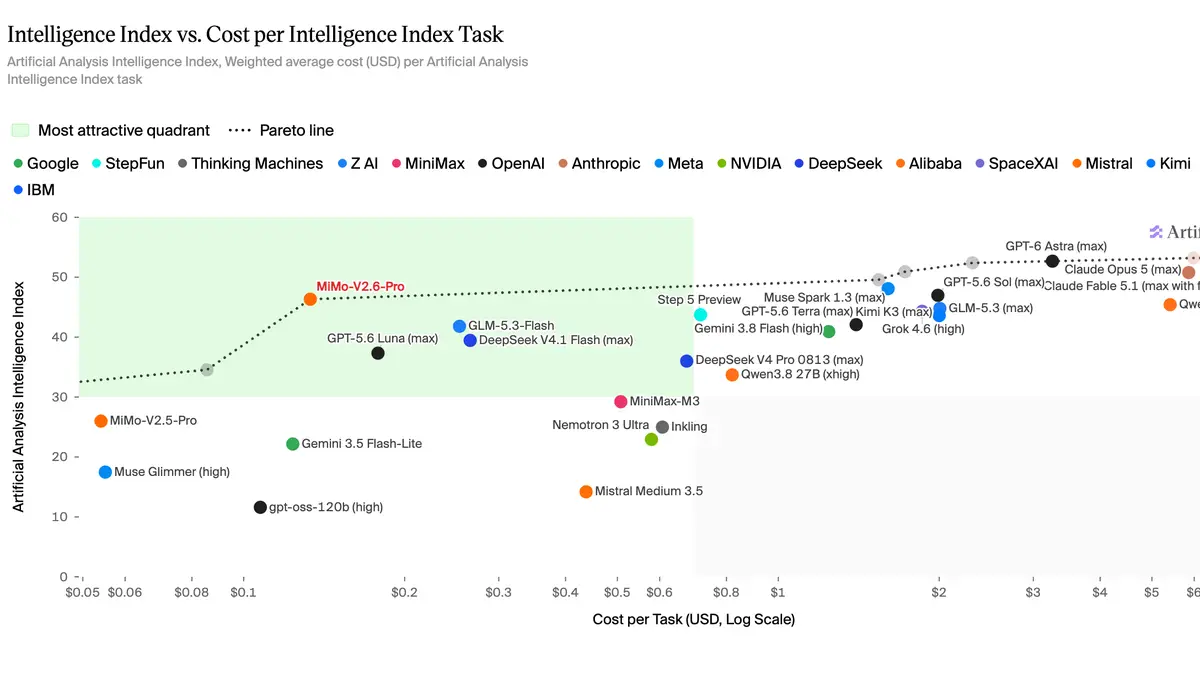
XiaomiがMiMo-V2.6を公開 1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
XiaomiがMiMo-V2.6を公開1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
 動画