Hugging Face、Swift向けAnyLanguageModel(エニーランゲージモデル)1.0を公開importを差し替えるだけで端末内モデルとOpenAI・Anthropic・Geminiを切り替え、swift-huggingface・swift-xetも1.0に
日刊AIニュース10月20日(火)号:前日のAIのニュース12本を短くまとめました(約8分)›
Hugging Faceは2026年10月20日の公式ブログで、Apple の Foundation Models と互換のSwiftライブラリ AnyLanguageModel の1.0を発表した。swift-huggingface 1.0、swift-xet 1.0もあわせて正式版となり(GitHubのリリース表示は10月6〜13日)、いずれも破壊的変更を含む。
目次
Hugging Face(ハギングフェイス)は2026年10月20日付の公式ブログで、Swift向けライブラリ「AnyLanguageModel(エニーランゲージモデル)」の1.0を発表した(GitHubのリリース自体は10月13日の表示)。Appleの Foundation Models フレームワークと互換のAPIで、import FoundationModels を import AnyLanguageModel に変えると、同じコードのまま端末内のオープンウェイトモデルとホスト型モデルを切り替えられる。公式ブログによると、関連する「swift-huggingface」と「swift-xet」もあわせて1.0になった。
3行まとめ
- Hugging Faceが2026年10月20日の公式ブログで、AnyLanguageModel 1.0・swift-huggingface 1.0・swift-xet 1.0を発表した(GitHubのリリース表示は10月6〜13日)。
- llama.cpp・MLX・Core MLの端末内モデルと、OpenAI・Anthropic・Gemini・Ollama などのホスト型を、同じセッションのコードで使える。
- 3つとも破壊的変更を含み、更新時は各リリースノートの移行手順を確認する必要がある。ライセンスはApache-2.0と表示されている。
本記事の内容は、日本時間2026年10月20日21時台に公式ページで確認したものです。
AnyLanguageModelで何ができるのか
公式ブログは、中心の考え方は昨年から変わらないと説明している。Foundation Models のAPIを使いつつ、アプリが使うモデルと提供元を自分で選べるというものだ。2025年11月20日の発表記事では、ローカルモデル用のCore MLやMLX、クラウド用のOpenAIやAnthropic、システムモデルのFoundation Modelsで、APIも組み込み方もばらばらになる点を課題に挙げていた。
今回のブログによると、この1年で追加された主な機能は次の3つ。
- ツール呼び出し(tool calling)が、すべてのプロバイダーで動く
- ガイド付き生成(guided generation)も、入れ子の
@Generable型とその配列を含めて、すべてのプロバイダーで動く - 画像入力。Foundation Models 27 の書き方でプロンプトに画像を添付でき、iOS・macOS・visionOS 27 のシステムモデルでも使える
OS 27 では、Foundation Models の LanguageModel プロトコルに準拠する任意のモデル(Core AI のモデルを含む)でも動くと書かれている。
対応するホスト型モデルと端末内モデル
ブログの一覧にある対応先は次のとおり。
| 区分 | 対応先(公式ブログの記載) |
|---|---|
| 端末内 | システムモデル、llama.cpp、MLX、Core ML |
| ホスト型 | OpenAI の Chat Completions と Responses API、Open Responses(互換エンドポイントを持つ任意の提供元)、Anthropic の Messages API(adaptive thinking と effort オプション付き)、Google の Gemini API、Ollama、OS 27 の Private Cloud Compute |
| 経由先 | Hugging Face Inference Providers、およびカスタム base URL で使う OpenRouter などの OpenAI 互換エンドポイント |
ブログによると、ホスト型にもローカルと同じ機能(ガイド付き生成、ストリーミング付きのツール呼び出し、応答のトークン使用量)がある。推論(reasoning)もトランスクリプトの一部になり、提供元を切り替えたときに新しい提供元が再生できない推論ブロックは、リクエストから自動で外される。APIキーは文字列ではなくクロージャで渡す形になり、自社サーバーから短期トークンを取得する使い方ができる。READMEには、利用者に自分のキーを持ち込ませる方式と、自社のプロキシ経由にする方式の、それぞれの安全面と注意点が書かれている。Linuxでも動くので、同じコードをサーバーで使える。
端末内で動かすモデルはどれくらいの大きさか
ブログは、Hub でよくダウンロードされているモデルとして次の3つを挙げ、サイズも書いている。
- Google の Gemma 4 E2B(GGUF、Q4_0 で約3.4GB)
- Liquid AI の LFM2.5 2.6B(GGUF、Q4_K_M で約1.7GB)
- Alibaba の Qwen3.8 27B(MLX、4ビットで約16GB)
ブログは、前の2つはiPhoneに収まり、Qwen3.8 27B は32GB以上のメモリを積んだMacで動くと説明している。MLXモデルの指定は MLXLanguageModel(modelId: "mlx-community/Qwen3.8-27B-4bit") の1行で済む。BF16で約1.5TBになるZ.aiのGLM-5.3については「最大構成のMac Studioが4台あれば」と冗談めかしたうえで、それ以外の人は Inference Providers 経由で使える、と書かれている。いずれも公式ブログの記載で、筆者が動かして確かめたものではない。
1.0で何が壊れるのか
swift-huggingface と swift-xet のリリースノートは、1.0で公開APIを確定させると書いている。3つとも、リリースノートの冒頭に破壊的変更が並ぶ。
| ライブラリ | リリース表示日 | 破壊的変更(リリースノートの記載) |
|---|---|---|
| AnyLanguageModel 1.0.0 | 10月13日 | JSONValue が独自の型になった(description・文字列補間・isCompatible(with:strict:) は無い)。@Generable が値付きenumをFoundation Modelsと同じ形で生成する形になり、以前のバージョンで生成した内容は読み込めない。swift-huggingface 1.0が必須 |
| swift-huggingface 1.0.0 | 10月9日 | swift-xet 1.0が必須。HTTPClientError・Provider・Capability・Bucket.Region が構造体に。bucketInfo(_:) は getBucket(_:) に改名。偶然 public だった補助機能の一部が internal に |
| swift-xet 1.0.0 | 10月6日 | XetDownloaderError が code を持つ構造体に。Xorb・LZ4・BG4 などが internal に。Multipath TCP が既定でオフに。設定名の変更 |
swift-huggingface のリリースノートによると、Provider と Capability を構造体にしたのは、1.x で新しい提供元や機能を追加しても既存コードを壊さないためで、網羅的な switch には default が必要になる。このリリースではBucketからのファイルのダウンロード(進捗表示付き)も加わった。更新手順は、公式ブログが3つのリリースノートの移行ガイダンスを参照するよう案内している。
日本の開発者は、いつから何で使えるのか
READMEの要件欄は、Swift 6.3以上(Xcode 26.4以上)、iOS 17.0以上・macOS 14.0以上・visionOS 1.0以上・Linux。依存の追加は from: "1.0.0" で、重いバックエンドは Swift のパッケージトレイト(CoreML・MLX・Llama)で選ぶ。トレイトを有効にすると依存解決が失敗することがあるという SwiftPM の不具合も、READMEに注意書きがある。READMEの記載では、システムモデルの利用に macOS・iOS・visionOS 26 以上が、Private Cloud Compute の利用に macOS・iOS 27 以上と専用の entitlement が必要。ライセンスはApache-2.0と表示されている。
料金は、ライブラリ自体について今回確認したページに有料プランの記載はなかった。ただしOpenAIなどホスト型を使う場合の利用料は各提供元の料金体系による。日本向けの提供条件や日本語ドキュメントについては、今回取得したページに記載を見つけられなかった(「日本」「Japan」「日本語」で検索した)。
観測──ブログより1週間早いタグ
日本時間21時台に公式ページを開いたところ、ブログの公開日は10月20日だったが、GitHubのリリースページの表示は swift-xet が10月6日、swift-huggingface が10月9日、AnyLanguageModel が10月13日だった(各ページの時刻表示のまま。タイムゾーンは表記がなかった)。Swift プロジェクトで from: "1.0.0" と書く開発者は、ブログの公開より前から1.0を取り込めた計算になる。READMEの導入例はすでに1.0.0に更新されている。
筆者が動かしていない部分と、まだ出ていない話
- 本記事は公式ブログとGitHubのページを読んだもので、AnyLanguageModelを実際に組み込んだり動かしたりはしていない。ブログのサイズや対応の記述は同社の説明である。
- 公式ブログの「What's next」は「Coming soon: models that decide, and models that listen」とだけ書いており、時期や仕様は今回確認したページに無い。
- 前の発表記事(2025年11月)は「pre-1.0」と書き、今後の課題として全プロバイダーでのツール呼び出しやガイド付き生成を挙げていた。画像については、Foundation Models 自体が画像の送信に対応しておらず、Appleが「将来のリリース(iOS 27かも?)」で加えるだろうと見ていた。今回のブログは、これらが入ったと説明している。
読んだ6ページ
日本時間2026年10月20日21時46〜47分に取得したページです。
- AnyLanguageModel 1.0: One Year of Local Models on Apple Platforms(Hugging Face公式ブログ)
- AnyLanguageModel 1.0.0 リリースノート
- swift-huggingface 1.0.0 リリースノート
- swift-xet 1.0.0 リリースノート
- AnyLanguageModel README
- Introducing AnyLanguageModel(2025年11月20日の発表)
本記事は続報があり次第更新します。
この記事でよく聞かれること
- AnyLanguageModelとは何ですか?
- Hugging Faceが公開しているSwift向けのライブラリで、AppleのFoundation Modelsフレームワークと互換のAPIを持ちます。公式ブログによると、import FoundationModels を import AnyLanguageModel に変えると、同じセッションのコードでシステムモデル、llama.cpp・MLX・Core MLのオープンウェイトモデル、ホスト型のモデルを使えます。
- AnyLanguageModel 1.0はどのプラットフォームで動きますか?
- GitHubのREADMEの要件欄には、Swift 6.3以上(Xcode 26.4以上)、iOS 17.0以上・macOS 14.0以上・visionOS 1.0以上・Linuxと書かれています。ライセンスはApache-2.0と表示されています。
- 1.0で互換性が壊れる変更はありますか?
- あります。AnyLanguageModelのリリースノートは、JSONValueが独自の型になったこと、@Generableが値付きenumをFoundation Modelsと同じ形で生成するようになり以前のバージョンで生成した内容は読み込めないこと、swift-huggingface 1.0が必須になったことを破壊的変更として挙げています。swift-huggingface、swift-xetにも別の破壊的変更があります。
- どのホスト型モデルに対応していますか?
- 公式ブログの一覧では、OpenAIのChat CompletionsとResponses API、Open Responses、AnthropicのMessages API、GoogleのGemini API、Ollama、OS 27のPrivate Cloud Compute、Hugging Face Inference Providers、カスタムbase URLで使うOpenRouterなどのOpenAI互換エンドポイントです。
出典・参照資料
- 一次資料AnyLanguageModel 1.0: One Year of Local Models on Apple Platforms — Hugging Face公式ブログ ↗
- 一次資料Release 1.0.0 · huggingface/AnyLanguageModel — GitHub ↗
- 一次資料Release 1.0.0 · huggingface/swift-huggingface — GitHub ↗
- 一次資料Release 1.0.0 · huggingface/swift-xet — GitHub ↗
- 一次資料huggingface/AnyLanguageModel — GitHub(README) ↗
- 一次資料Introducing AnyLanguageModel — Hugging Face公式ブログ(2025年11月20日) ↗

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開 MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
 動画
ドイツ製AI「Kolibri」を手元のMacで動かした 78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
ドイツ製AI「Kolibri」を手元のMacで動かした78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
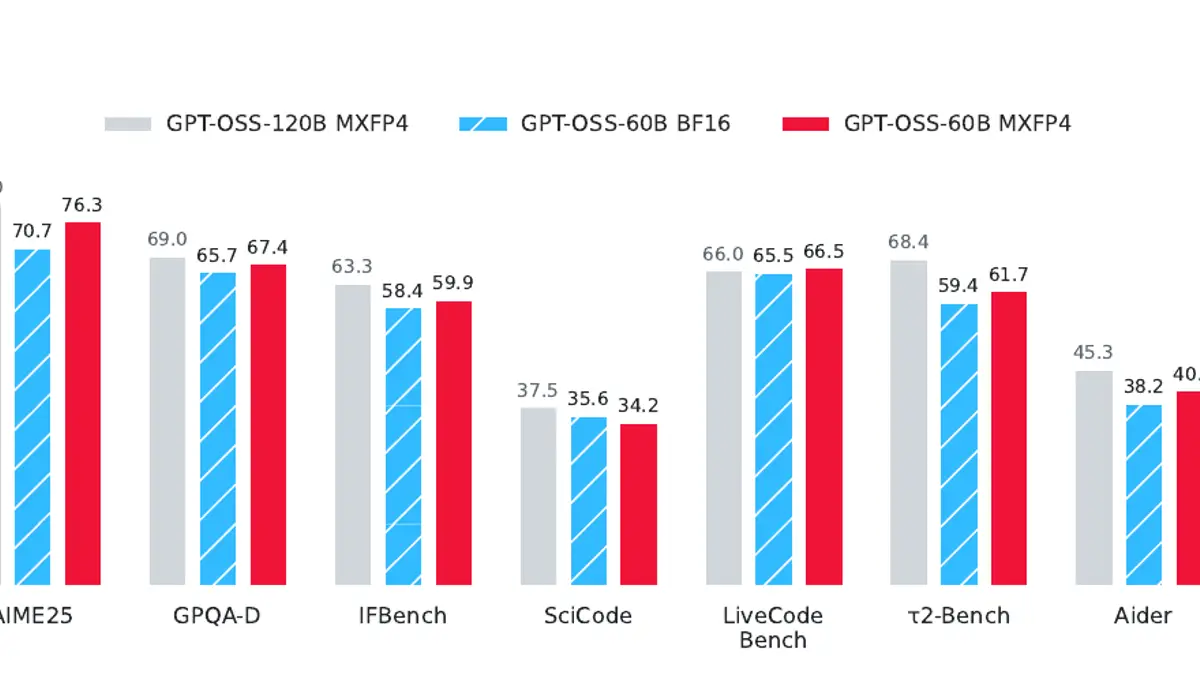
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開 LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
GGUFとMLX、Macで動かすならどっちを選ぶべきか 「ファイル形式」と「フレームワーク」を混同しないための整理
GGUFとMLX、Macで動かすならどっちを選ぶべきか「ファイル形式」と「フレームワーク」を混同しないための整理
Hugging Face「funes」 Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
Hugging Face「funes」Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す