Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
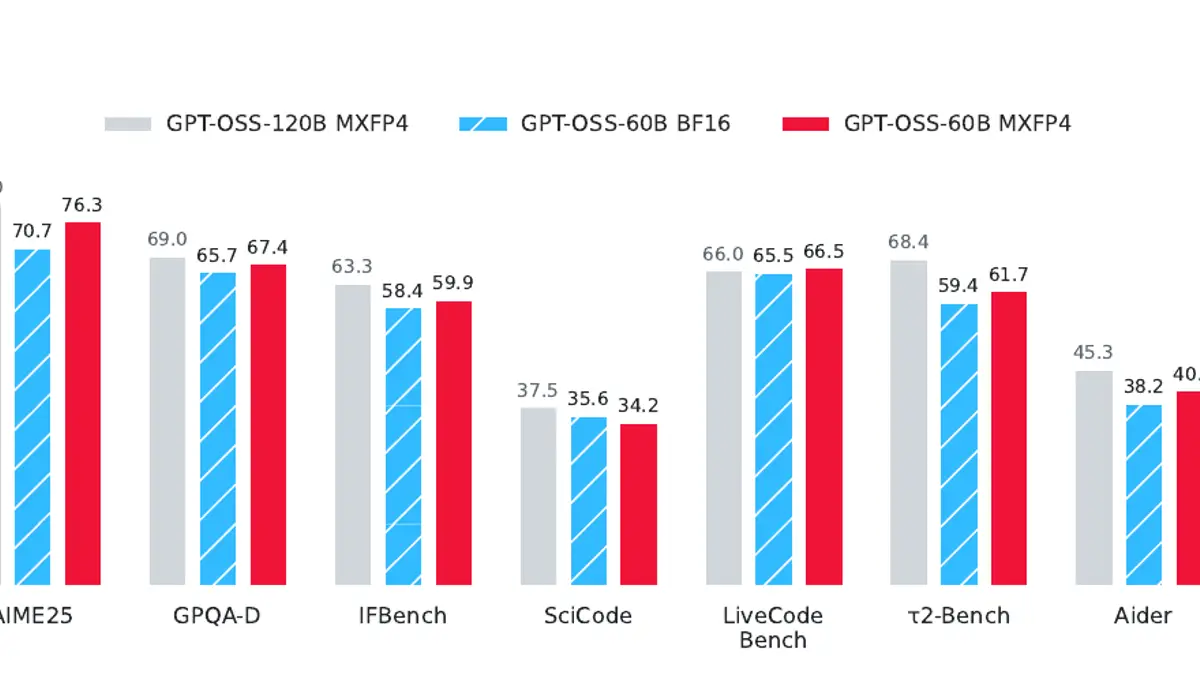
Multiverse Computingは2026年8月25日、論文「Quantization-Aware Healing(QAH)」を解説した。LLMを小さくする標準手順は、構造圧縮→4ビット量子化→劣化を回復する「healing」。回復の主流は量子化認識学習(QAT。高価で長く回すと不安定)と量子化認識蒸留(QAD。構造圧縮後は「回復済みのbf16版」しか教師候補がなく、その天井に縛られる)。QAHは教師を圧縮前の元モデルにし、構造が違っても出力分布は構造に依存しないので蒸留できる、という一手。結果、GPT-OSS 120B→60B・MXFP4のQAHモデルは、同じ60Bのbf16版を9ベンチ中7で上回り(AA-LCR 42.7対35.3、AIME 2025 76.3対70.7、GPQA Diamond 67.4対65.7、LiveCodeBench 66.5対65.5。負けたMMLU-ProとSciCodeは1.5点未満)、120Bの教師に対してもLiveCodeBenchで上回った(66.5対66.0)。9BでのQAT比較では最高点は同等(54.9対54.6)だがQAHは安定。
2026年9月19日・日本時間時点の情報です。 Hugging FaceのMultiverse Computingのブログ(8月25日)を読んだ。当サイトのgpt-ossの解説やVRAMぴったりの量子化で扱ってきた「小さくすると賢さが落ちる」問題に、教師を誰にするかで答えた話で、結果の向きが普通と逆なので残す。
3行まとめ
- 問題。 LLMを小さくする標準手順は、①層・ヘッド・ニューロンを削る構造圧縮、②残った重みを4ビットに量子化、③落ちた能力(推論・数学・コード)を回復するhealing。gpt-oss・NVIDIAのNemotron・同社のHypernova 60Bも圧縮→回復の型を使う。回復の主流は2つ。QAT(量子化認識学習:偽量子化を入れて課題損失で微調整。多段の後訓練をやり直すため高価で、長く回すと最良点を過ぎて不安定)とQAD(量子化認識蒸留:凍結した全精度の教師から出力ロジットのKLで蒸留)。QADは量子化だけなら同じ構造の全精度版が教師になれるが、構造圧縮後は「回復済みのbf16版」しか教師候補がなく、それ自体が元モデルの近似なので、その天井に縛られる。
- QAHの一手。 教師を圧縮前の元モデル(全サイズ・全精度)にする。教師と生徒は構造が違う(生徒は半分の大きさでMXFP4)が、出力分布は構造に依存しないのでKLで蒸留できる。これで量子化段は「回復後の損失のある後処理」でなく「元の教師への2回目の完全な蒸留」になり、bf16版が受けなかった監督を4ビット版が受ける。KLは固定の教師分布に縛るので追いついたら漂わない(交差エントロピーは硬いラベルへ押し続ける)。32kトークンの長文書は、語彙×系列の格子を作らないチャンク化したKL損失で固定GPUメモリに収める。
- 結果。 GPT-OSS 120B→60B・MXFP4のQAHモデルは、同じ60Bのbf16版を9ベンチマーク中7で上回った:AA-LCR(長文脈推論)42.7対35.3(+7.4)、AIME 2025 76.3対70.7(+5.6)、Aider 40.9対38.2、τ²-bench 61.7対59.4、GPQA Diamond 67.4対65.7、IFBench 59.9対58.4、LiveCodeBench 66.5対65.5。負けたのはMMLU-Pro(−0.2)とSciCode(−1.4)で1.5点未満。120Bの教師(MXFP4)に対しても、半分のパラメータ・約4分の1の重みメモリでLiveCodeBenchは上回り(66.5対66.0)、GPQAは1.6点差。最大の差が残るのは長文脈のAA-LCR(50.0対42.7)。9BモデルでQATと条件を揃えた比較では最高到達点は54.9対54.6でほぼ同じだが、QAHは早く到達して安定し、QATは続けると崩れる、と。
4ビット優位の理由と自社測定の注意
- 「4ビット版が16ビット版より良い」は、量子化の魔法ではなく16ビット版の回復が不十分だったことの裏返し。本文も「情報を失った分を補っているのでなく、前の回復段が転移しきれなかった情報を拾っている」と書く
- ローカルで動かす側には、「圧縮+量子化された派生モデルを選ぶとき、何を教師に回復したか」が品質の目安になる、という示唆。ローカルLLMとはの選び方に足す材料
- 数字はMultiverse自身の測定で、9ベンチマークの選定も同社。同社は8月に知識蒸留を安く回す記事、9月にSafety for Whom?を出している
- QAHで作った60Bモデルの重みが公開されているかは本文の範囲では確認できなかった
原文で確認した範囲、論文本文は未読
この記事の下調べで、筆者は9月19日にHugging Faceのブログを取得し、3段の手順・QAT/QADの説明・QAHの定義・9ベンチマークの数値・120Bとの比較・9BでのQAT比較(54.9/54.6)がその原文にあることを確認した。論文本文は開いていない。筆者は再現していない。
公開有無・計算量・他モデルは不明
- QAHの60Bモデルの公開有無とライセンス
- 回復に使ったデータ量と計算量
- gpt-oss以外の系統(Llama・Qwen)での結果
出典はHugging Faceのブログ
- Quantization-Aware Healing: a compressed, 4-bit model that outperforms its full-precision original(Multiverse Computing・2026年8月25日)
関連記事
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
gpt-ossをローカルで動かすと何ができるか 20Bと120Bの違いを整理する
gpt-ossをローカルで動かすと何ができるか20Bと120Bの違いを整理する
手元のメモリを99.998%まで使い切る量子化ツール「shoehorn」 プリセットGGUFをやめる発想
手元のメモリを99.998%まで使い切る量子化ツール「shoehorn」プリセットGGUFをやめる発想
「Safety for Whom?」 安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
「Safety for Whom?」安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
 動画
ローカルLLMとは何か 自分のPCでAIを動かす仕組み・利点・始め方を解説
ローカルLLMとは何か自分のPCでAIを動かす仕組み・利点・始め方を解説
Hugging Face「オープンモデルの現状・2026年夏」 中国ラボの月間最大モデル(754B〜2.78T)がほぼ毎月米国を上回る、米国で最多公開はAMDとNVIDIA、ダウンロード上位25と「いいね」上位25の重なりは1本だけ、Qwenの派生は151,448本で1日180〜210本、Hubを叩くエージェントはClaude Codeが7月44.4%・Codexが20.8%
Hugging Face「オープンモデルの現状・2026年夏」中国ラボの月間最大モデル(754B〜2.78T)がほぼ毎月米国を上回る、米国で最多公開はAMDとNVIDIA、ダウンロード上位25と「いいね」上位25の重なりは1本だけ、Qwenの派生は151,448本で1日180〜210本、Hubを叩くエージェントはClaude Codeが7月44.4%・Codexが20.8%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Ai2「BenchMIRT」 100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
Ai2「BenchMIRT」100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)