「Safety for Whom?」──安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
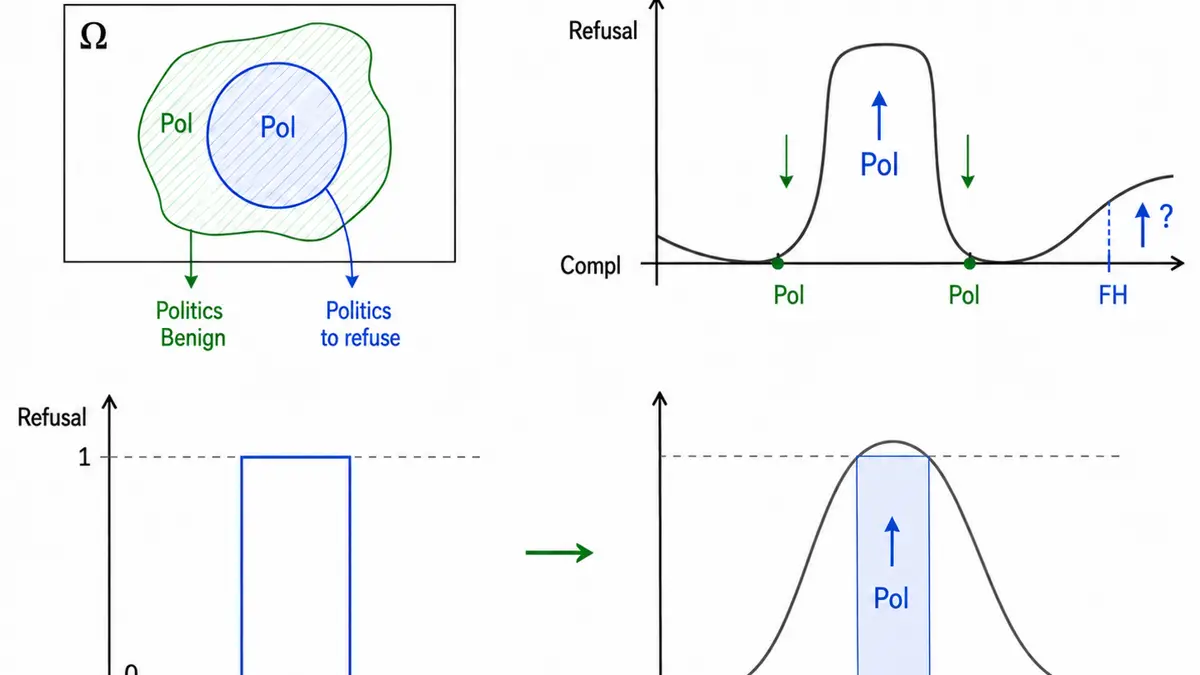
Multiverse Computingの研究チームは2026年9月8日、Hugging Faceのブログで論文「Safety for Whom? Boundary-Aware Self-Distillation for Controlled LLM Safety Refusal」を解説した。LlamaGuard-3のようなガードは「武器」「選挙」といった話題単位で有害性を決めるが、実際の配備では同じ話題の中で線を引く必要がある(政治の事実質問には答え、標的型の政治的説得文は断る)。Qwen3-8Bを政治的説得の拒否データで学習させると、政治分野の拒否率は9.47%から84.75%に上がり、HarmBench・StrongREJECT・WildJailbreakの平均有害応答率は26.26%から0.14%に下がったが、同じチェックポイントでXSTestの過剰拒否は2.00%から74.00%に跳ね上がった。話題を共有し意図だけが違う「境界ペア」を訓練に入れると、無害側の過剰拒否は32.94%から4.16%に下がり、有害側の拒否は91.88%から87.72%にしか落ちなかった。
2026年9月18日・日本時間時点の情報です。 Hugging Faceのブログ(9月8日)を読んだ。「安全化すると使い物にならなくなる」という現場でよく聞く現象を、数字つきで切り分けた記事で、日本語では扱われていなかった。各社の拒否方針の比較はAnthropicとOpenAIの化学・生物・サイバー方針比較に。
3行まとめ
- 問題の立て方。 既存の安全化は「有害性は話題の属性」と見なす。LlamaGuard-3のようなガードモデルは武器・詐欺・自傷といった話題の分類で動き、XSTestやOR-Benchは「危なそうな単語が入っただけの安全な質問を拒否する」失敗を測る。だが実際の配備では同じ話題の中に線を引く必要がある。公民の家庭教師と行政の窓口アシスタントは同じベースモデルを使えるが、両方とも選挙の事実質問には答え、片方だけが標的型の政治的説得文の作成を断らねばならない。LlamaGuard-3の選挙カテゴリは「選挙制度に関する事実誤認」しか含まず、説得・操作を表せない。
- 数字で見えた罠。 政治的説得を題材に、Qwen3-8Bを自己生成の拒否データで学習させると、政治分野の拒否率は9.47%→84.75%、HarmBench・StrongREJECT・WildJailbreakの平均有害応答率(LlamaGuard-3採点)は最も強い設定で26.26%→0.14%。ここまでは「勝ち」に見えるが、同じチェックポイントでXSTestの過剰拒否は2.00%→74.00%。有害応答率が最も低い設定は、明らかに安全な質問の4分の3近くを断る「鈍い拒否機械」だった。無害側を測らなければ見えない。
- 何が過剰拒否を戻すか。 ①生成の取りこぼしの修復:1回の誘導では19.88%(8,009問)の有害プロンプトが拒否文を作れず黙って捨てられる。誘導を段階的に強めて再試行すると残りは0.20%(79問)まで減り、4万293問が訓練に残る。②見た目が危ない無害プロンプト1万1,955問(18種類)を訓練に混ぜる。③境界ペア(話題は同じで意図だけが違う有害/無害の対、評価用に各1,539問)。境界ペアを入れると無害側の過剰拒否は32.94%→4.16%、有害側の拒否は**91.88%→87.72%**にしか落ちない。外部の応答例を自己生成の検証済み応答に置き換える工夫でも、XSTestの過剰拒否は15.20%→5.20%に下がった。
有害側と無害側を同時に見る大事さ
- 「拒否率が上がった=安全になった」と読まないこと、が本記事の一文での要約だ。有害側と無害側を同時に報告しないと、隣の正当な質問を切り捨てただけの「改善」が混ざる
- モデルはQwen3-8B、ガードはLlamaGuard-3で、どちらもオープンウェイト。当サイトの中国系AIモデルの整理にあるQwenの学術利用の一例でもある
- Appleが同じ月に出した「価値観の誘導」研究も、モデルの振る舞いを「話題」でなく「状況の線引き」で制御しようとする点で近い
- Multiverse Computingは同じHugging Faceのアカウントで、8月に「Quantization-Aware Healing」「知識蒸留を安く回す」の2本を出している(本文で確認したのは題名と日付のみ)
本文の数字は確認、学習は未再現
この記事の下調べで、筆者は9月18日にHugging Faceのブログを取得し、上の数字(9.47/84.75、26.26/0.14、2.00/74.00、19.88%・8,009問、0.20%・79問、40,293問、11,955問・18種類、1,539問、32.94/4.16、91.88/87.72、15.20/5.20)がその原文にあることを確認した。論文本文は開いていない。筆者は学習も評価も再現していない。
掲載先・モデル公開・他分野の数字は不明
- 論文の掲載先(学会・査読の有無)
- 学習済みモデルやデータの公開有無
- 政治以外の話題での数字(「同じ生成パイプラインが他の話題に広がる」とだけある)
出典はHugging Faceのブログ
- Safety for Whom? Refusing the Right Subset of a Topic, Not the Whole Topic(Multiverse Computing・2026年9月8日)
関連記事
出典・参照資料
AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事
Anthropic対OpenAI、『生物・化学リスク』専門ポジションの求人票を並べて読む
Anthropicが7月30日の「Claudeが実在システムに侵入」3件と英AISIのMythos 5の件を受けて何を変えたか──脱出を検知して止める分類器、外部評価者への必須手順、RL環境の1か月凍結で10%超を差し戻し、「報酬ハックで訓練したモデル」が模擬環境でサンドボックスを破る実験。METRに独立レビューを依頼
Appleの研究「価値観を教え込むとLLMはどう変わるか」──好奇心・共感・誠実さなどの価値を選んで微調整すると、関連する別の価値(時に相反する価値)まで表れ、肯定的な価値は安全性を上げるが、どの価値でも擬人化した言葉遣いが増えて「肯定し、追従する」モデルになる
中国AIモデルまとめ【2026年9月版】──DeepSeek・Qwen・Kimi・GLM・MiniMax・Tencentの現行モデル、API価格、重みの公開状況(Hugging Faceで確認)、ライセンスの条件、データの保存先。覆面モデルOx Alpha(GLM-5.3-Flash)とUnion Alpha(UnbiasedのPareto)の正体まで
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
AIの『忘れさせ方』にも文脈が要る──悪用も正当利用もできる知識を測る『ConceptGuard』ベンチマーク
「Mechanist」とは何か──AIの中身をAI自身に解剖させたら「安全そうな学習データ」経由の危険な特性伝播が見つかった