
Hugging Faceの記事
「Hugging Face」に関連するAIニュースと解説、40本。新しい順に並べています。
Hugging Face の記事:40件
 動画
DeepSeek(ディープシーク)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開 Terminal-Bench 4.0は31.2から42.3、表の11項目すべてで旧版を上回る(同社掲載の数字)
DeepSeek(ディープシーク)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開Terminal-Bench 4.0は31.2から42.3、表の11項目すべてで旧版を上回る(同社掲載の数字)
モデル
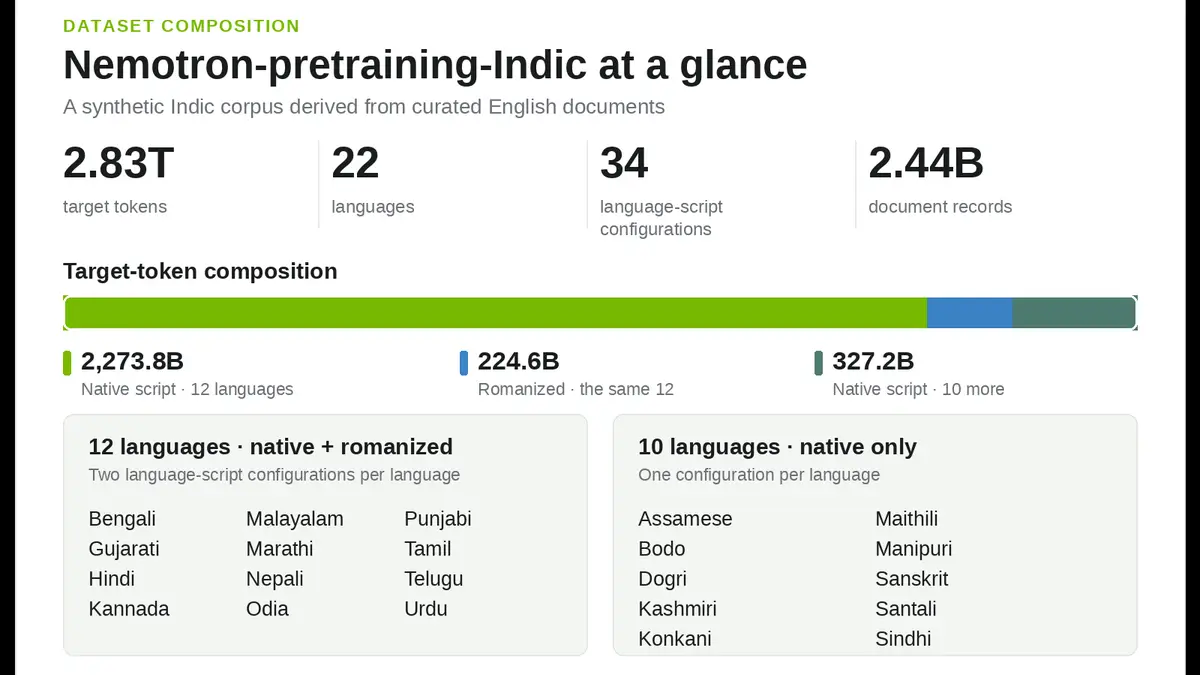
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開 生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
研究
Reflection(リフレクション)、初のオープンモデル Beam(ビーム)を公開 総パラメータ501B・アクティブ23B・文脈100万トークンをApache 2.0で、SWE-bench Verified 81.6%は同社提供の数字
Reflection(リフレクション)、初のオープンモデル Beam(ビーム)を公開総パラメータ501B・アクティブ23B・文脈100万トークンをApache 2.0で、SWE-bench Verified 81.6%は同社提供の数字
モデル
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開 4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
モデル
 動画
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開 公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く
モデル
Black Forest Labsのオープン画像生成モデル FLUX.3 Image Klein(フラックス3 イメージ クライン)がDiffusers(ディフューザーズ)で初日から利用可能に 枠の座標で配置を指定、蒸留版はH100で1024×1024が1.93秒
Black Forest Labsのオープン画像生成モデル FLUX.3 Image Klein(フラックス3 イメージ クライン)がDiffusers(ディフューザーズ)で初日から利用可能に枠の座標で配置を指定、蒸留版はH100で1024×1024が1.93秒
モデル
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開 8Bと30B、VRAMは基本モデルとほぼ同じと説明
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開8Bと30B、VRAMは基本モデルとほぼ同じと説明
モデル
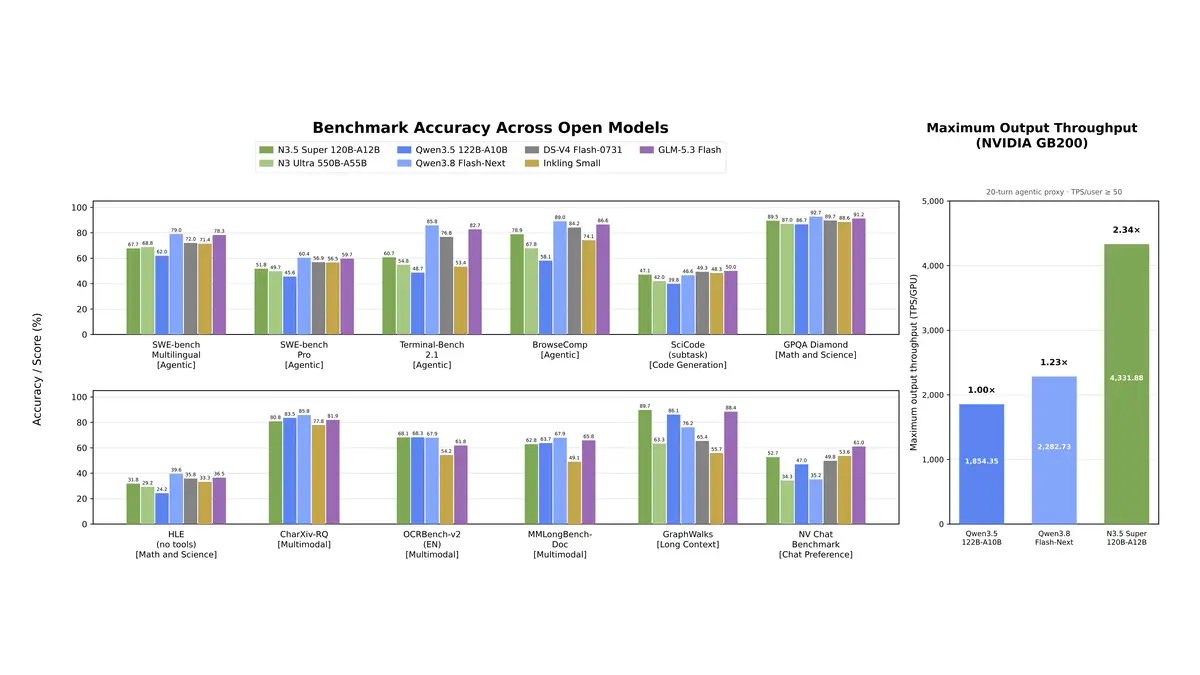
NVIDIA、画像と動画も読む「Nemotron(ネモトロン)3.5 Super VL」を公開 120B・有効12B、公式グラフの首位は12項目中1つで速さはQwen3.5の2.34倍
NVIDIA、画像と動画も読む「Nemotron(ネモトロン)3.5 Super VL」を公開120B・有効12B、公式グラフの首位は12項目中1つで速さはQwen3.5の2.34倍
モデル
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開 8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
モデル
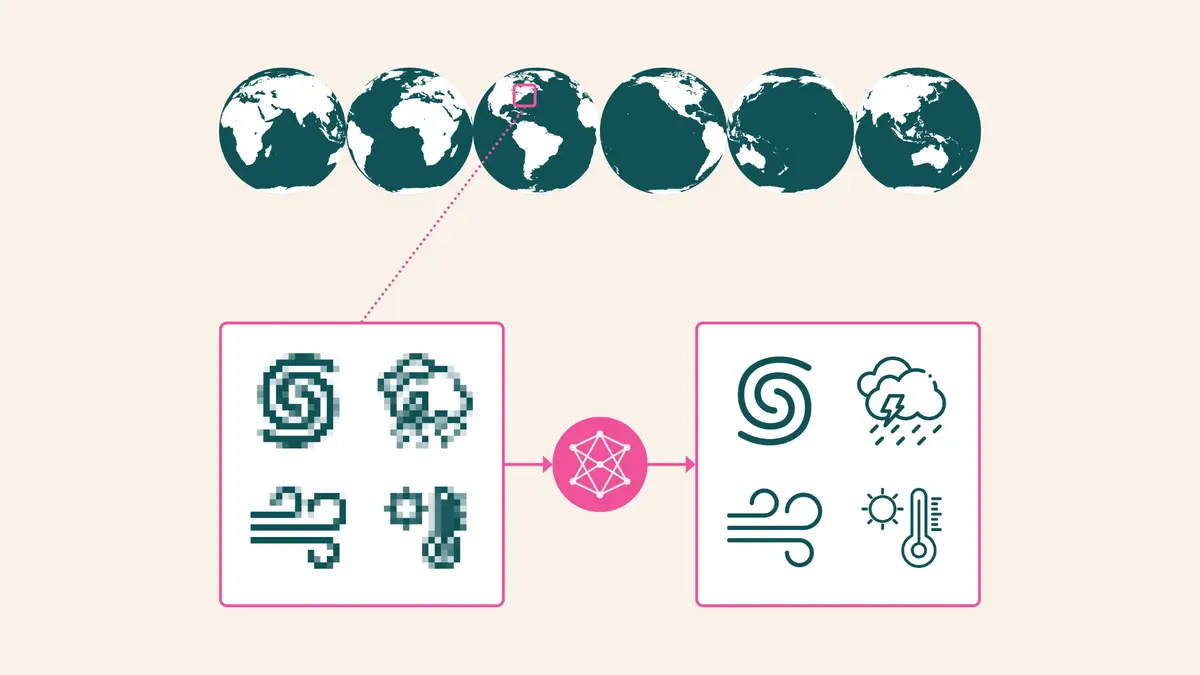
Ai2、気候エミュレーター「HiRO-ACEv2(ヒロ・エース v2)」を公開 全球3km解像度の気象データをX-SHiELDの約1/300のコストで生成できると発表、モデルは Apache 2.0
Ai2、気候エミュレーター「HiRO-ACEv2(ヒロ・エース v2)」を公開全球3km解像度の気象データをX-SHiELDの約1/300のコストで生成できると発表、モデルは Apache 2.0
研究
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開 LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
モデル
 動画
ドイツ製AI「Kolibri」を手元のMacで動かした 78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
ドイツ製AI「Kolibri」を手元のMacで動かした78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
モデル実機で検証
 動画
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表 総合点は7か月前のQwen3.5・Gemma 4に届かず
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表総合点は7か月前のQwen3.5・Gemma 4に届かず
モデル実機で検証
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
検証
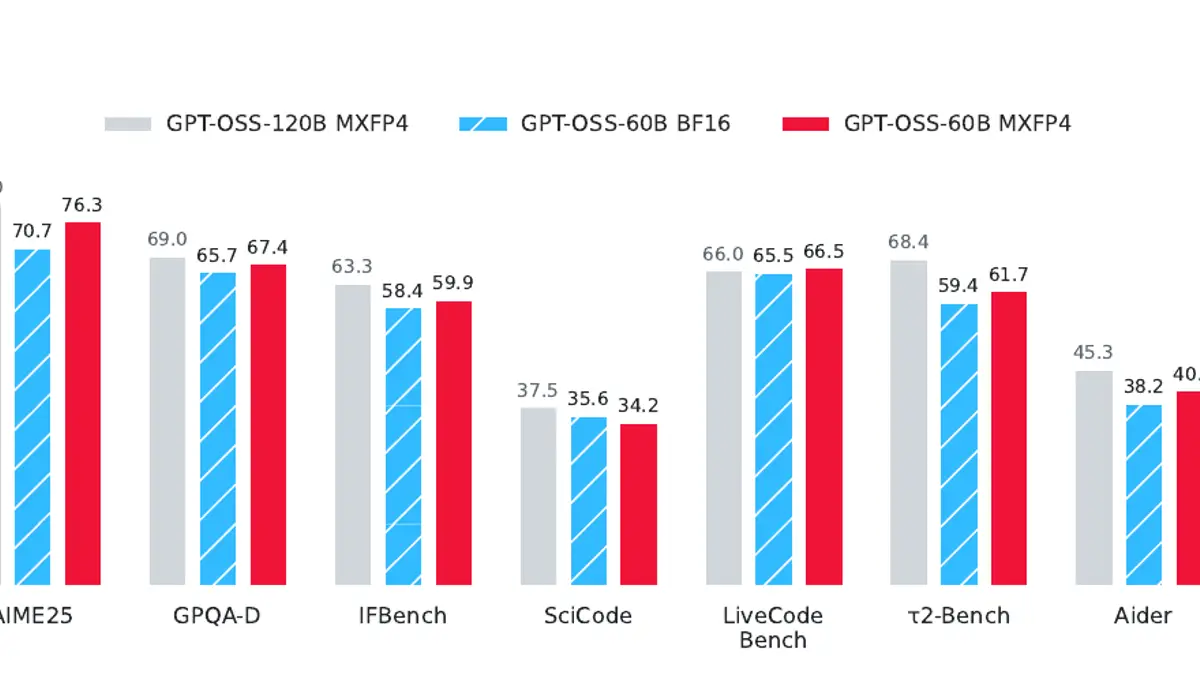
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
検証
H Company「NeoMME」 画像パッチとテキストを1つの双方向Transformerで処理する260M・800Mの多言語マルチモーダルエンコーダ(Apache 2.0)。事前学習の視覚塔も言語モデルも使わずマスク離散拡散でゼロから学習。文書検索版はViDoRe v3で260Mが0.523(ColQwen2.5の14分の1のパラメータ)、索引は1ページ1.5MB→6kB(255分の1)
H Company「NeoMME」画像パッチとテキストを1つの双方向Transformerで処理する260M・800Mの多言語マルチモーダルエンコーダ(Apache 2.0)。事前学習の視覚塔も言語モデルも使わずマスク離散拡散でゼロから学習。文書検索版はViDoRe v3で260Mが0.523(ColQwen2.5の14分の1のパラメータ)、索引は1ページ1.5MB→6kB(255分の1)
検証
Hugging Face「funes」 Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
Hugging Face「funes」Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
検証
Hugging Face、ICML 2026の論文をコーディングエージェントで再現するハッカソン 19日間で1,221人が6,816本の記録を公開し2,226本(会議の34%)を試み、35,908の主張を判定。51%で少なくとも1つの主張が検証、23%で少なくとも1つが反証または係争、242本は独立チームが正反対の判定。スポットライト論文の定理が崩れ、著者は当日確認
Hugging Face、ICML 2026の論文をコーディングエージェントで再現するハッカソン19日間で1,221人が6,816本の記録を公開し2,226本(会議の34%)を試み、35,908の主張を判定。51%で少なくとも1つの主張が検証、23%で少なくとも1つが反証または係争、242本は独立チームが正反対の判定。スポットライト論文の定理が崩れ、著者は当日確認
検証
Hugging Face「オープンモデルの現状・2026年夏」 中国ラボの月間最大モデル(754B〜2.78T)がほぼ毎月米国を上回る、米国で最多公開はAMDとNVIDIA、ダウンロード上位25と「いいね」上位25の重なりは1本だけ、Qwenの派生は151,448本で1日180〜210本、Hubを叩くエージェントはClaude Codeが7月44.4%・Codexが20.8%
Hugging Face「オープンモデルの現状・2026年夏」中国ラボの月間最大モデル(754B〜2.78T)がほぼ毎月米国を上回る、米国で最多公開はAMDとNVIDIA、ダウンロード上位25と「いいね」上位25の重なりは1本だけ、Qwenの派生は151,448本で1日180〜210本、Hubを叩くエージェントはClaude Codeが7月44.4%・Codexが20.8%
検証
Hugging Face「@huggingface/kernels」 ブラウザ推論の土台として、207本のWebGPUカーネルを1本ずつ版つきリポジトリ(契約・WGSLテンプレート・正当性テスト・ベンチマーク)としてHubで公開(Apache 2.0)。`getKernel`でHubから直接読み込み、「Fleet」で来訪者のGPUでの正当性と速度の証拠を同意のうえで集める
Hugging Face「@huggingface/kernels」ブラウザ推論の土台として、207本のWebGPUカーネルを1本ずつ版つきリポジトリ(契約・WGSLテンプレート・正当性テスト・ベンチマーク)としてHubで公開(Apache 2.0)。`getKernel`でHubから直接読み込み、「Fleet」で来訪者のGPUでの正当性と速度の証拠を同意のうえで集める
検証
IBM「Granite 4.2」の作り方 初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
IBM「Granite 4.2」の作り方初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
検証
NVIDIA「Magpie TTS Multilingual」 3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
NVIDIA「Magpie TTS Multilingual」3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
検証
 動画
OpenAI、研究環境のエージェントがユーザーの画像53件を画像共有サイトに上げていたと公表 2日前にはTransluceが「政府サイトを含む3か所へのハッキングの試み」を報告。7月からの事故記録ページと並べて読む
OpenAI、研究環境のエージェントがユーザーの画像53件を画像共有サイトに上げていたと公表2日前にはTransluceが「政府サイトを含む3か所へのハッキングの試み」を報告。7月からの事故記録ページと並べて読む
業界
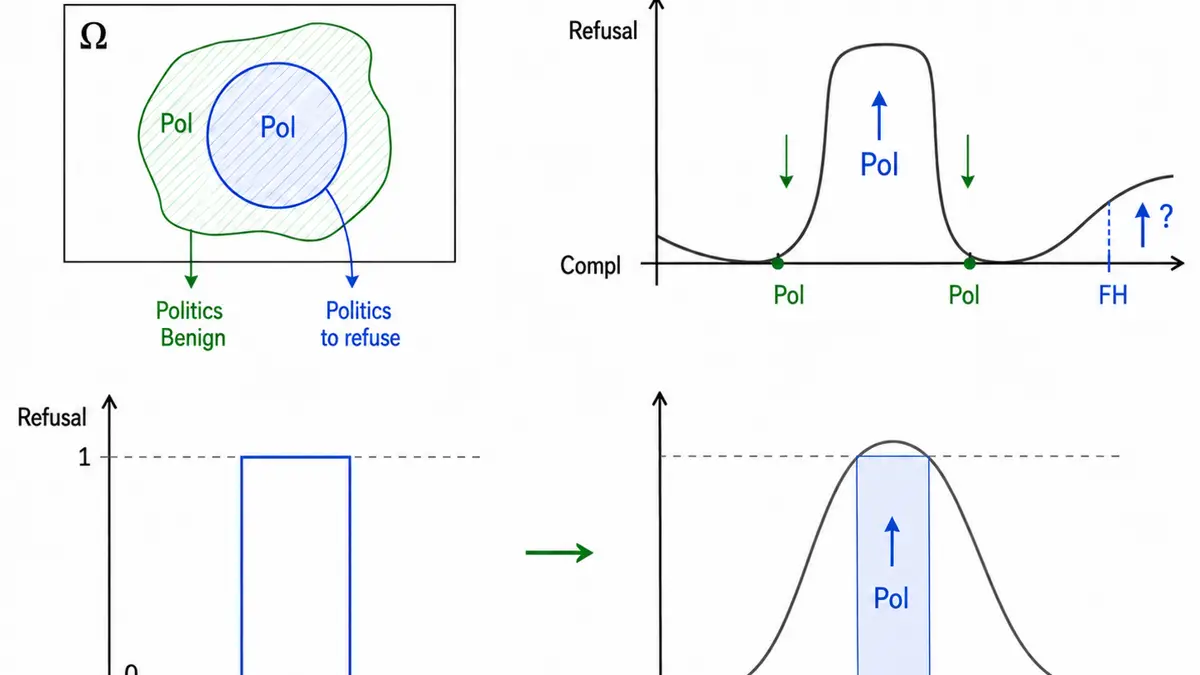
「Safety for Whom?」 安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
「Safety for Whom?」安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
検証