NVIDIA、タンパク質設計のオープンモデルRFD4-Proteina(アールエフディーフォー・プロテイナ)をブラウザで試せるHugging Face Spacesで公開11月4日まで専用GPUが無料
日刊AIニュース10月21日(水)号:前日のAIのニュース18本を短くまとめました(約11分)›
NVIDIAは2026年10月21日、ワシントン大学IPDと共同開発したタンパク質設計モデルRFD4-ProteinaをHugging Face Spacesで試せると発表した。11月4日まで専用GPU(RTX PRO 6000)の利用が無料で、24ターゲットの比較では同社ブログは1GPU時間あたり76.40件対13.24件と説明している。
目次
NVIDIAは2026年10月21日(協定世界時12:39、日本時間21:39にブログが公開)、ワシントン大学のInstitute for Protein Design(IPD)と共同開発したタンパク質設計のオープンモデル RFD4-Proteina(アールエフディーフォー・プロテイナ)を、ブラウザだけで試せる Hugging Face Spaces で公開したと発表した。10月21日から11月4日まで、NVIDIA RTX PRO 6000で動く専用Spaceの利用をNVIDIAが負担して無料にする。
3行まとめ
- NVIDIAとワシントン大学IPDのRFD4-Proteinaは、配列と全原子構造を1つのモデルで生成し、ブラウザ上のHugging Face Spaceで試せる
- 専用GPU(RTX PRO 6000)のSpaceは10月21日〜11月4日が無料。以降はZeroGPU Spaceが、アカウントの上限内で無料のまま
- 24ターゲットの比較で、ブログは1GPU時間あたり76.40件(次点Proteina-Complexaは13.24件)と説明。ただしモデルカードは同じ項目を71.60件と書いている
本記事の内容は、日本時間10月21日21時台に公式ページで確認したものです。
RFD4-Proteinaは何ができるモデルか
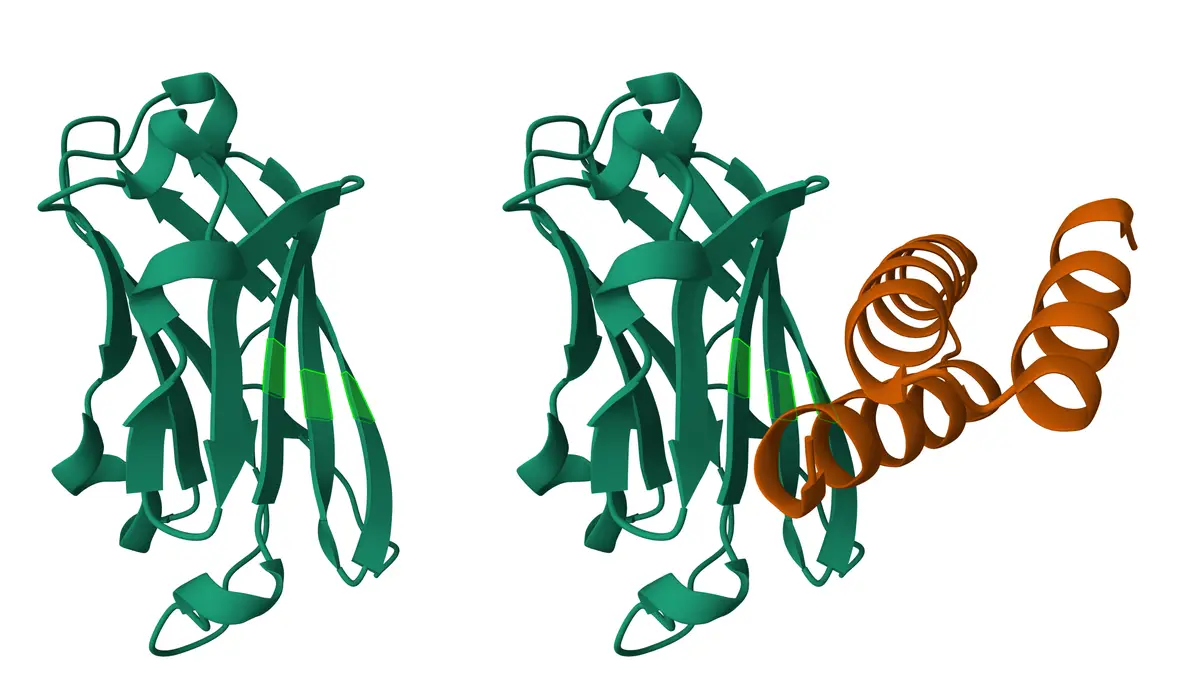
NVIDIAのブログによると、RFD4-Proteinaは BioNeMo のオープンモデルで、タンパク質の配列と全原子の立体構造を1つのモデルで生成する。ブログは、従来は骨格・配列・全原子構造を別々のモデルで扱い、受け渡しのたびに情報が失われてきたと説明し、それを減らすのが狙いとしている。
設計の対象として、ブログは次の分子を含む環境を挙げている。
- 他のタンパク質
- 低分子
- 核酸
- 糖鎖
- 金属イオン
- 修飾アミノ酸(例: 標的タンパク質のリン酸化残基)
仕組みについてブログは、フローマッチングのモデルとオートエンコーダーを組み合わせたものだと書いている。各アミノ酸(修飾アミノ酸を含む)・糖・DNA/RNAのヌクレオチドを「アンカー原子の座標(アミノ酸ならα炭素)+化学的な素性と周辺の形を学習した潜在ベクトル」で表し、それをフローモデルが同時に生成し、デコーダーが全原子の3D構造と配列に展開する。結合させたい標的や、含めたい触媒モチーフを条件として与えて設計する。
ドキュメントのページには、リリース済みのチェックポイントが対応する課題として、無条件生成、モチーフのスキャフォールディング、酵素設計、低分子バインダー設計、タンパク質バインダー設計、DNAバインダー設計の6つが「Supported」と並んでいる(酵素設計には「実例付き」と添えられている)。
ブラウザでの使い方は
ブログによると、手順は次のとおり。
- 専用のRFD4-Proteina Space(または共有容量のZeroGPU Space)を開く
- 用意された例(組み込みのPD-L1の例など)を選ぶ。どちらのSpaceも、ブラウザ上の分子ビューア兼注釈エディターAtomWorks Studioで動く
- 標的の構造、結合させたい領域、狙う残基(ホットスポット)を確認し、既定の設定で1件生成する
- 生成物を3Dビューアで見て、設計したタンパク質が標的のホットスポットに触れているか確認する
- 設計物・注釈付きの標的・複合体をCIF形式でダウンロードする
そのうえでシード値を変えると、同じ入力から別の設計が出る。ブログは、シード番号を控えておき、最初の1件との比較の基準にするよう勧めている。
「thinking」設定(low・medium[既定]・high)は、生成中に各設計をどれだけ磨き込むかを決める。ブログによると、磨き込みを増やすと計算上のフィルターを通る良い設計の可能性が上がるが、1件あたりの計算量も増える。モデルカードの表では、トランクの再循環回数が low は120、medium は180、high は300になっている。
誰が・いつまで・いくらで使えるか
| 項目 | ブログ・モデルカードの記載 |
|---|---|
| 専用Space | 10月21日〜11月4日はNVIDIAの負担で無料。NVIDIA RTX PRO 6000で動く |
| 11月4日以降の専用Space | 無料ではなくなる(金額の記載は今回確認したページに見当たらない) |
| ZeroGPU Space | 共有容量で、Hugging Faceアカウントの上限の範囲で無料のまま |
| モデルと重みのライセンス | BSD 3-Clause(著作権表示はワシントン大学IPD) |
| 重みの大きさ | model.safetensorsが1.74 GB(FP32)。パラメータは約4.36億 |
| ローカル実行の条件 | Linux x86_64、Python 3.12、対応するNVIDIA GPU、CUDA 13対応ドライバー |
日本からの利用について、今回取得した公式ページには、地域の制限も日本向けの案内も書かれていなかった。モデルカードが明記している利用条件は、ZeroGPU側がHugging Faceアカウントの上限内であること、どちらのSpaceも入力と設計をSecureDNAで検査しフラグが立った依頼を拒否することの2点で、そのほかの条件は今回確認したページからは読み取れなかった。
自分の環境で動かす場合、ブログはGitHub(RosettaCommons/RFD4-Proteina)からの導入、pip install での導入、Diffusersの3通りを示している。Diffusers版(RFD4ProteinaPipeline)は、モデルカードによると10月20日にDiffusersへ統合されたが次のリリースに入る予定で、それまではGitHubから入れる必要がある。ブログはさらに、CUDA 13ビルドはCUDA 12のドライバーでも導入自体は通るのに最初のGPU呼び出しで失敗するので、先に nvidia-smi で確認するよう注意している。CUDA 12向けのビルドも別に用意されている。
ブログとモデルカードで食い違う数字
ブログは、24個のタンパク質結合ターゲットでの設計ベンチマークで、RFD4-Proteina(high thinking)は計算上の基準を満たす構造的に異なる設計を1GPU時間あたり76.40件出し、2番手のProteina-Complexaは13.24件だったと書いている。基準は、構造予測による再折りたたみで、バインダーのpTMが0.80以上、界面の最小PAEが1.5 Å以下、標的に合わせたバインダー骨格のRMSDが2.5 Å以下。
一方、モデルカードの表では、同じ24ターゲットのタンパク質バインダーの欄でRFD4-Proteinaは71.60、Proteina-Complexaは13.24となっている。比較相手の13.24は一致するが、RFD4-Proteina側が76.40と71.60で異なる。
モデルカードは、この表の数字は「前のリリースの組」で、2026年10月9日に固めたプロジェクトのベンチマークで測ったもので、現行チェックポイントより前のものであり、現行版では再測定していないと明記している。ブログの76.40がどの版で測ったものかは、今回確認したページには書かれていない。比較に引用するときは、どちらの数字かを明示したほうがよい。
モデルカードの同じ表には、ほかのベンチマークも載っている(いずれもRFD4-Proteinaはhigh thinking、前のリリースの組での値)。
| ベンチマーク | ターゲット数 | RFD4-Proteina | 比較対象の最良 |
|---|---|---|---|
| タンパク質バインダー | 24 | 71.60 | Proteina-Complexa 13.24 |
| 低分子バインダー | 77 | 112.25 | BoltzGen 15.48 |
| 原子モチーフ酵素(Atomic Motif Enzyme) | 37 | 91.18 | AlphaProtein-novo(Codesign)26.02 |
| DNAバインダー | 3 | 41.97 | BoltzGen(DNA固定)9.46 |
モデルカードはこの指標を「ターゲットごとの、構造的に異なる計算上の合格設計数のGPU時間あたりの平均」と説明し、GPU時間には生成と共通のAF3評価を含め、1ターゲットあたり200回の試行(失敗した試行も時間を消費する)を数え、準備・コンパイル・CPU採点・待機時間は除くとしている。数値はターゲットごとの率の平均で、全体を合算した値や1設計あたりの所要時間ではないとも書いている。手法ごとに条件づけの方法が違う点(タンパク質バインダーの比較はRFD4が骨格条件、複数の比較対象は全原子条件)、DNAは3ターゲットのみという点も、モデルカード側が断っている。「計算上の合格は実験での活性を示さない」という注記もある。
前の発表との関係
RFD4-Proteina自体は、当サイトのNVIDIAの欧州向けオープンモデル一括発表の記事でも7系統の1つとして触れた。今回のブログはそのモデル単独の使い方と、ブラウザで試せるSpaceに焦点を当てている。モデルカードでは、現行のチェックポイントは2026年10月19日のリリースで、10月15日の組を置き換えたと書かれている。オートエンコーダーが「タンパク質・核酸・低分子を1つで扱う統合型」になり、残基の語彙は33クラスから147クラス、潜在次元は16から32に変わった。前の版とは部品の互換性がない。
安全面とコンペ連動
ブログによると、Hugging Face上のRFD4-Proteinaは、入力と、モデルが返す全ての設計に対してSecureDNAのバイオセキュリティ・スクリーニングを実行する。配列はSpaceのコンテナ内でハッシュ化・暗号化されてから処理され、配列そのものは外に送られないと説明している。モデルカードは、フラグが立った依頼は拒否されると書いている。
ブログはまた、Anthropic(アンスロピック)とAdaptyvが共同スポンサーのタンパク質設計コンペ(Anthropic × Adaptyv Protein Design Competition)で、開いているチャレンジ向けの候補バインダーを作る使い方を挙げている。Proteinbaseのコンペページによると、オープントラックはどの設計手法でも参加でき、参加は無料、選ばれた設計はAdaptyvの自動化ラボで実験される。各チャレンジの締め切りは最終日の23:59(AoE、UTC−12)で、ページには次の日程がある。
| チャレンジ | 標的 | 期間 |
|---|---|---|
| 3 | GLP1R(アゴニスト) | 10月12日〜25日 |
| 4 | TfR1(条件付きバインダー) | 10月19日〜11月1日 |
| 5 | 未発表 | 10月26日〜11月8日 |
実験に回る設計の選定はClaudeを使った流れで行われ、全部が試験されるわけではないとページに書かれている。オープントラックには試験枠の保証はない。ブログも「参加と実験対象の選定は別」と書いている。試験された設計と結果は、コンペ規約に基づいて公開される。
公式ページを確認した時点で気づいたこと
日本時間21時42分に公式ページを順に開いた時点で、ブログの公開(日本時間21:39ごろ)から数分後だった。モデルカードにはブログについて「3 minutes ago」と表示され、「Downloads last month 314」とも出ていたが、公開直後のため、この数字が利用の広がりを示すかどうかは判断できない。専用SpaceのページはHugging Face上で「Running on RTX PRO 6000」と表示されていた(アプリ本体は読み込み中の表示で、画面から操作内容までは確認できていない)。筆者は実際にSpaceで設計を生成しておらず、生成の質や待ち時間は確かめていない。
今回確認できていないこと
- ブログの76.40がどのチェックポイントで測った値か、モデルカードの71.60との差の理由は、今回の公式ページには書かれていない
- ブログ、モデルカードとも、ベンチマークはいずれも計算上の指標で、実験での結合や活性は示していないと自ら注記している。ブログの図のキャプションも「実験で結合を確かめる必要がある」と書いている
- 11月4日以降の専用Spaceの料金は、今回確認したページには載っていない
- 筆者は日本語のヘルプや日本向けの案内の有無を網羅的には調べておらず、取得したページに日本の記載がなかったという範囲の話にとどまる
出典と確認時刻
- Protein Design with RFD4-Proteina and Hugging Face Spaces(NVIDIA、Hugging Face Blog)
- nvidia/RFD4-Proteina(モデルカード)
- RFD4-Proteina Space
- Anthropic × Adaptyv Protein Design Competition(Proteinbase)
- RFD4-Proteina documentation
確認時刻は日本時間2026年10月21日21時42分(5ページとも21時42分台に取得)。本記事は続報があり次第更新します。
この記事でよく聞かれること
- RFD4-Proteinaとは何ですか?
- NVIDIAとワシントン大学のInstitute for Protein Designが共同開発した、タンパク質の配列と全原子構造を1つのモデルで一緒に生成するオープンモデルです。NVIDIAのブログによると、タンパク質のほか低分子、核酸、糖鎖、金属イオン、修飾アミノ酸を含む環境でも設計できます。
- 無料で試せますか?
- NVIDIAのブログによると、2026年10月21日から11月4日まで、専用GPU(NVIDIA RTX PRO 6000)で動くSpaceをNVIDIAが提供して無料で使えます。11月4日以降は専用Spaceは無料ではなくなりますが、共有容量で動くZeroGPU SpaceはHugging Faceアカウントの上限の範囲で無料のままとされています。
- 商用利用はできますか?
- モデルカードによると、モデルと重みのライセンスはBSD 3-Clauseです。ただし同梱の任意のAlphaFold2・OpenFold3関連のコンテナイメージなどは別の上流ライセンスのままで、商用利用や再配布に制限があるものを含むと書かれています。利用前に各ライセンスの確認が必要です。
- ブログの76.40とモデルカードの71.60はなぜ違うのですか?
- ブログは24ターゲットで76.40件と書き、モデルカードは同じ24ターゲットのタンパク質バインダーで71.60件と書いています。モデルカードによると、表の数字は旧リリースの組で2026年10月9日に測ったもので、現行版では再測定していません。筆者は食い違いの理由を確認できていません。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開 生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIA、画像と文章を横断検索できる Nemotron 3.5 Embed/Rerank/Parse(ネモトロン)をオープンで公開 ViDoRe v3.1のdense検索で首位、Rerank追加でエージェントのトークン費用は約14%減と同社
NVIDIA、画像と文章を横断検索できる Nemotron 3.5 Embed/Rerank/Parse(ネモトロン)をオープンで公開ViDoRe v3.1のdense検索で首位、Rerank追加でエージェントのトークン費用は約14%減と同社
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開 4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開 8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
NVIDIA、ロボット開発基盤Isaac(アイザック)を拡充 Isaac Lab 3.0は一般提供、参照用ヒューマノイドAgile ONE SNは2027年初頭の提供予定
NVIDIA、ロボット開発基盤Isaac(アイザック)を拡充Isaac Lab 3.0は一般提供、参照用ヒューマノイドAgile ONE SNは2027年初頭の提供予定
NVIDIA、シミュレーション対応の3Dアセット2,000点超を集めた「SimReady Central(シムレディ・セントラル)」をHugging Faceで公開 無料・ゲートなし、Vertiv・FANUCなどの名前も
NVIDIA、シミュレーション対応の3Dアセット2,000点超を集めた「SimReady Central(シムレディ・セントラル)」をHugging Faceで公開無料・ゲートなし、Vertiv・FANUCなどの名前も
Ai2、LLMの公平性を「説得されたときの変わりやすさ」で測るFairStress(フェアストレス)を公開 300場面・1,300万件超、データとコードも配布
Ai2、LLMの公平性を「説得されたときの変わりやすさ」で測るFairStress(フェアストレス)を公開300場面・1,300万件超、データとコードも配布