NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIAは2026年10月16日、IIT Madras・AI4Bharatと作った約2.8兆トークン・インド22言語の合成事前学習データ「Nemotron-pretraining-Indic-v1」を近く公開すると発表した。生成パイプラインも公開し、Nemotron 3.5 Super VLでは5つのIndic指標が4.98〜9.82ポイント上がったと説明している。
目次
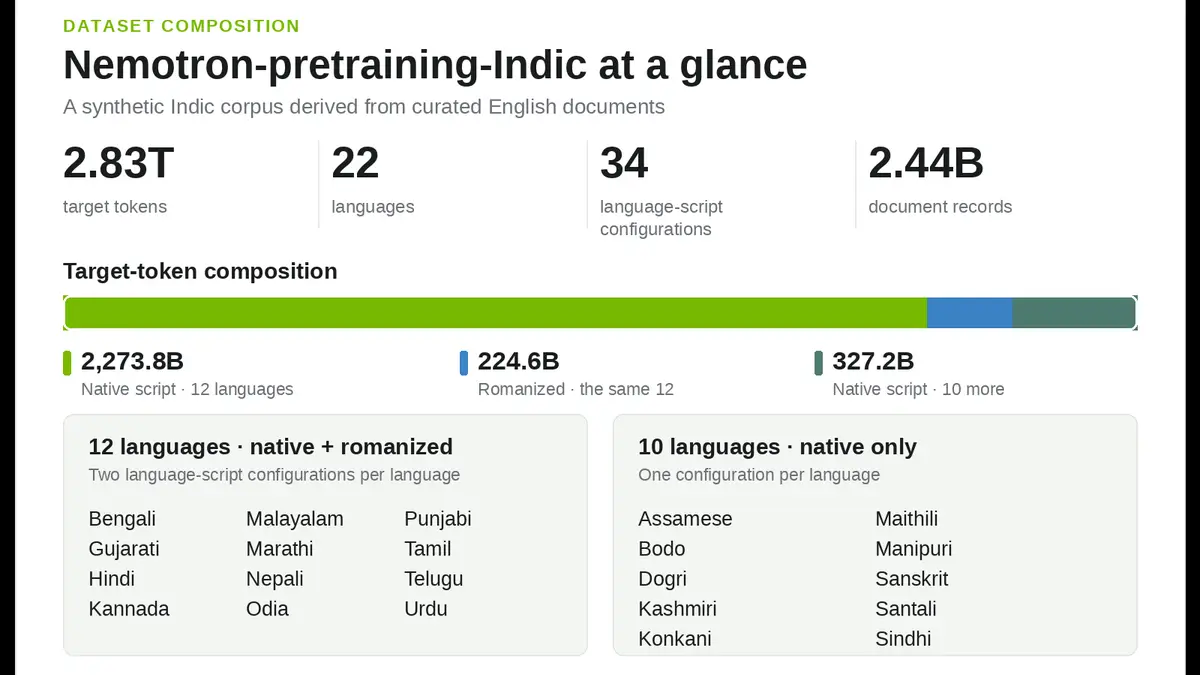
NVIDIAは2026年10月16日(日本時間10時台に公式ブログを確認)、IIT Madras(インド工科大学マドラス校)とそのAI4Bharat研究室と共同で作った、インドの22言語にわたる約2.8兆トークンの合成事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開すると発表した。同じデータを作った「GPU対応のオープンな生成パイプライン」も一緒に公開するという。NVIDIAによると、このデータを一部使った継続事前学習で、Nemotron 3.5 Super VLのIndic(インド系言語)向け5指標がすべて4.98〜9.82ポイント上がった。
3行まとめ
- NVIDIAがIIT Madras・AI4Bharatと、インド22言語・約2.8兆トークンの事前学習データNemotron-pretraining-Indic-v1と生成パイプラインを「近く公開」と発表(2026年10月16日)
- 12言語は現地文字とローマ字の両方、10言語は現地文字のみの計34構成。元は英語の15サブセットを翻訳し、100点満点で75点以上の出力だけを残した
- Nemotron 3.5 Super VLでは、継続事前学習100Bトークンのうち10Bをインド系言語に充て、5指標が4.98〜9.82ポイント上昇。ただし合成データ単独の効果は切り分けていない(NVIDIA)
本記事の内容は、日本時間10月16日10時台に公式ページで確認したものです。
何が公開されるのか
NVIDIAのブログによると、公開予定のものは2つある。1つは約2.8兆トークンのコーパス(データ集)、もう1つはそれを作った生成パイプラインだ。パイプラインにはプロンプト(指示文)、LLMのワークフロー、品質チェックまでの作り方一式が入り、開発者は自分の元文書に合わせて作り直して、必要なだけデータを増やせるとしている。
対象の22言語は、インド憲法に載る言語だ。ブログは、これらが人口の97%、2011年国勢調査で約12億人にとっての第一言語だと書いている。
内訳はブログの図1の説明に出ている。
| 区分 | トークン数 | 備考 |
|---|---|---|
| 現地文字(native-script) | 2,601.0B(約2.6兆) | 22言語 |
| ローマ字(romanized) | 224.6B | 12言語 |
| 言語・文字の構成 | 34 | 現地文字22+ローマ字12 |
トークン数はGemma-4のtokenizerで数えた値で、翻訳や文字違いの版を含むため、ユニークな英語文書の数ではないと書かれている。また、これはコーパスの在庫を示す数字で、学習1回あたりのトークン予算とは別に読むよう、NVIDIAは注意している。
どうやって作ったのか
元になるのは、NVIDIAの英語データNemotron-CC-v2の15サブセットだ。ウェブテキスト、質問応答、数学、コードなどが含まれる。NVIDIAのオープンソースのデータ生成基盤「NeMo Data Designer」で、翻訳、品質評価、修復を回した。出力ごとに元文書のIDを残してあり、元に遡れるのが特徴だと説明している。
12言語の流れ
ブログによると、12言語(現地文字とローマ字の両方があるもの)は次の4段階だ。
- 英語の文書を丸ごと翻訳する。段落や表、数式をまたいだ文脈を使うため。翻訳にはGemma-4-31B-itを使った
- 同じモデルで、英語の元文書と見比べて採点する。MQM(翻訳エラーを種類と重さで分類する枠組み)に着想を得た基準で、意味、流暢さ、用語、文体、書式を見る
- 100点満点で75点未満の出力は、採点の指摘をもとに直して再採点する。この修復で438.4Bトークンを回収し、総数に含まれているという
- 合格した現地文字の翻訳の一部をラテン文字に変換し、元の現地文字と照合する
NVIDIAは、英語から直接ローマ字を作るより、翻訳とローマ字変換を分けた方が、最初の人手比較で作り話の追加や英語の残りが少なかったと書いている。
10言語の流れ
残りの10言語は、IIT Madras発の非営利組織Bodhan AIの翻訳モデル「Indic Translate」で翻訳し、Gemma-4-31B-itで採点する。75点以上だけを残す点は同じだが、採点に基づく書き直しはせず、現地文字のデータだけを作る。長いサンタル語の文書は重なりのある窓で訳して復元し、マニプリ語はベンガル文字に訳してから固有のMeitei Mayek文字に変換したという。
Nemotron 3.5 Super VLで何が変わったのか
ブログは、Nemotron 3.5 Super VLの技術報告書の表2を引いて、インド系言語の継続事前学習(CPT)の前後を比べている。設定した予算は100Bトークンで、10%の10Bトークンを合成データと自然なインド系言語の文章に割り当て、残り90%は直前の学習配合の比率を保った。10Bトークンは、このコーパスの12言語分と自然な文章から取ったという。
MILU、Indic MMLU-Pro、Indic ARC-Challenge、Indic ARC-Easy、Indic GSM8Kの5つの指標すべてで点が上がり、上がり幅は4.98〜9.82ポイントだった。ただしNVIDIA自身が、この比較は合成データと自然データを合わせた段階の効果であり、合成コーパス単独の貢献を切り分けたものではないと書いている。GSM8KはOdiaを除く。評価が配信側の文脈長の上限を超えたためだ。
公開済みのモデルとしての比較も載っている。前世代のNemotron 3 Superと比べ、示された6つのタスク指標のうち5つで上回り、IFEval 1.5の指示追従は2.04ポイント下がった。SarvamのIndiVibe(アシスタント型プロンプトのベンチマーク)の4項目はすべて改善したが、暫定値でヘッドトゥヘッドの勝率ではないと断っている。これらの数字はすべてNVIDIAの報告に基づくもので、本記事では再計算していない。
モデル自体について、モデルカードは120Bの総パラメータ(アクティブ12B)で、文脈長は最大1Mトークンと説明している。
使い方はどう案内されているか
ブログには、Hugging Faceのdatasetsでストリーミング読み込みするコード例がある。言語・文字・地域のタグで構成を選び、例えばhi-Deva-INはデーヴァナーガリー文字のヒンディー語、hi-Latn-INはローマ字のヒンディー語を指す。ただしコード例はリポジトリIDを入力させる形で、Hugging Face上のリポジトリIDは本文に書かれていない。ブログは、学習の前にデータセットカードとライセンスを確認するよう勧めているが、ライセンスの種類は本文に書かれていない。
パイプライン側は「Nemotron Bharat translation plugin」としてNeMo Data Designer向けに公開される。翻訳と評価のプロンプト、任意で使えるフィードバックに基づく書き直し、文書の窓分割、文字の変換が入っている。
私が公式ページで確認できたこと
日本時間10時46分前後に、ブログと関連ページを取得して見た。ブログ本文は「releasing soon」で、公開の日付は書かれていない。NVIDIAの「Nemotron-Pre-Training-Datasets」コレクションページには、取得した本文にIndicの語が一つも出てこなかった。コレクションは約6時間前に更新されたと表示されていたが、取得した本文に並んでいたデータセットにこのデータは見当たらなかった。また、ブログが「open generation recipe」として張っているGitHubのプラグインのページは、取得時にHTTP 404だった。これらは「近く公開」という発表と矛盾するものではない。ただ、取得した範囲では、データもプラグインもまだ入手先として確認できなかった。なお、筆者はこのデータ自体を試していない。
この発表の限界と、日本の読者にとっての意味
翻訳データであること。 NVIDIAは、翻訳は元からインド系言語で書かれた文章の代わりにならず、現地の知識や文化を網羅する保証もないと書いている。自然な現地語のテキストと組み合わせ、使う目的に合わせて評価するよう勧めている。
品質評価は主に自動であること。 人の確認は抜き取りで、範囲は言語ごとに違う。12言語の流れでは翻訳したモデルが採点も担当している。10言語の流れには、現地話者によるより広い確認が必要だとも書かれている。元文書IDによる重複の除去は処理上の重複を消すもので、似た内容の意味的な重複排除ではない。
評価の範囲。 別の技術報告書は、12言語の最初の合格データで配合や規模を調べており、回収した書き直しや残り10言語を含む全体での評価は「次の段階」と書かれている。
日本との関係。 22言語に日本語は入っていない。今回取得した公式ページには、日本での提供や日本語向けの話は出てこない。日本の読者にとっては、「大規模な合成事前学習データを、翻訳・採点・修復の手順ごと公開する」という作り方の事例として読むのが近い。
同じくNVIDIAのオープンモデルについては、Nemotron 3.5 Super VLの公開の記事も参照してほしい。
出典と確認時刻
- Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline(NVIDIA、Hugging Face ブログ):日本時間2026年10月16日10時45分に取得
- Nemotron-Pre-Training-Datasets(NVIDIA、Hugging Face コレクション):同10時46分に取得
- NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4(モデルカード):同10時台に取得
ブログが挙げる技術報告書(Nemotron 3.5 Super VL and Lightning の報告書、Scaling Synthetic Pre-training Data and Evaluation for Indic LLMs)の本文は、今回は確認していません。本記事は続報があり次第更新します。
この記事でよく聞かれること
- Nemotron-pretraining-Indic-v1 とは何ですか?
- NVIDIAがIIT Madras、同大のAI4Bharatと開発した、インドの22言語にわたる約2.8兆トークンの合成事前学習データです。英語の元文書を翻訳して作り、12言語にはラテン文字に書き直したローマ字版も含みます。NVIDIAは2026年10月16日のブログで、データを生成パイプラインとともに近く公開すると発表しました。
- もう使えますか?
- NVIDIAのブログは「releasing soon(近く公開)」と書いています。日本時間2026年10月16日10時台に確認した時点で、NVIDIAのNemotron事前学習データのコレクションページを取得した範囲では、このデータは見当たりませんでした。公開の日付はブログに書かれていません。
- どんな言語が入っていますか?
- インド憲法に載る22言語です。ベンガル語、グジャラート語、ヒンディー語、カンナダ語、マラヤーラム語、マラーティー語、ネパール語、オディア語、パンジャブ語、タミル語、テルグ語、ウルドゥー語の12言語は現地文字とローマ字の両方、アッサム語、ボド語、ドグリ語、カシミール語、コンカニ語、マイティリー語、マニプリ語、サンスクリット語、サンタル語、シンド語の10言語は現地文字のみです。日本語は含まれません。
- データの質に限界はありますか?
- NVIDIAは、翻訳は現地語で書かれた文章の代わりにならず、品質評価は主に自動で人の確認は言語ごとに範囲が違うと書いています。12言語の流れでは翻訳したモデルが採点も担当し、10言語の流れには現地話者による追加の確認が要るとしています。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
NVIDIAとプリンストン大Dao AI Lab、ハイブリッドモデルの推論を速める「ReplaySSM(リプレイSSM)」を公開 SSMカーネル1.46〜1.80倍、投機的デコードはvLLM比1.85〜2.10倍
NVIDIAとプリンストン大Dao AI Lab、ハイブリッドモデルの推論を速める「ReplaySSM(リプレイSSM)」を公開SSMカーネル1.46〜1.80倍、投機的デコードはvLLM比1.85〜2.10倍
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開 8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
LoRAとは──元の重みを凍結し、小さな行列2つだけを学習する仕組み。原論文はGPT-3 175Bで「学習パラメータ1万分の1・GPUメモリ3分の1」、QLoRAは「65Bを48GB未満」。画像生成での使われ方と作り方の流れ
LoRAとは──元の重みを凍結し、小さな行列2つだけを学習する仕組み。原論文はGPT-3 175Bで「学習パラメータ1万分の1・GPUメモリ3分の1」、QLoRAは「65Bを48GB未満」。画像生成での使われ方と作り方の流れ
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Ai2、気候エミュレーター「HiRO-ACEv2(ヒロ・エース v2)」を公開 全球3km解像度の気象データをX-SHiELDの約1/300のコストで生成できると発表、モデルは Apache 2.0
Ai2、気候エミュレーター「HiRO-ACEv2(ヒロ・エース v2)」を公開全球3km解像度の気象データをX-SHiELDの約1/300のコストで生成できると発表、モデルは Apache 2.0
NCCLに頼らないallreduce SGLangがBlackwell世代のFlashInfer MNNVLワークスペースを使い回す最適化
NCCLに頼らないallreduceSGLangがBlackwell世代のFlashInfer MNNVLワークスペースを使い回す最適化