Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
Tencent Hunyuanが、外部メモリ枠組みMem0・MemOSなどで「何を覚えるか」を担う長期記憶ライターHy-Memory-30B-A3B(総30B・アクティブ約3B、Apache 2.0表記)をHugging Faceに公開。4枠組みの平均は55.49で、Claude Opus 5の54.62を上回ると同社が測定した(20%サブセット)。
目次
Tencent(テンセント)のHunyuanチームが、AIの長期記憶の「書き込み」だけを担う専用モデル「Hy-Memory-30B-A3B」を、Hugging Faceのモデルページに載せた。リポジトリの作成日時は2026年10月15日9時52分(UTC。日本時間では同日18時52分)。モデルカードによると、総パラメータは約30B、稼働は約3Bで、Mem0、MemOS、Hy-Memoryといった外部メモリ枠組みの中で汎用LLMの代わりに入る。同社の測定では、4つの枠組みの平均が55.49で、同じ条件で試したClaude(クロード)Opus 5の54.62をわずかに上回った。
3行まとめ
- Tencent Hunyuanが「Hy-Memory-30B-A3B」(総30B・アクティブ約3B、ライセンス表記はApache 2.0)をHugging Faceに公開。2026年10月15日9時52分UTC作成、書き込み専用。
- 同社測定(各ベンチの固定20%サブセット)で、4枠組み平均は55.49。Claude Opus 5は54.62、DeepSeek V4.1 Flashは53.64。
- 差は枠組みごとに0.01〜2.85点で、Hy-MemoryとMemOSでは0.02点以下。リポジトリは連絡先の共有に同意しないと中身に入れない設定で、取得時点のダウンロード数は「-」表示(データ上は0)。
本記事の内容は、日本時間2026年10月16日17時台に公式ページで確認したものです。
Hy-Memory-30B-A3Bは何をするモデルか
モデルカードは、このモデルを「外部メモリ枠組みの書き込み経路(write path)を実行する、コンパクトな長期記憶ライター」と説明している。会話や作業の記録から、何を残すか、どれだけ正確に表すか、新しい情報で保存済みの記憶をどう更新するかを決める役だ。モデルカードの評価でも、質問に答えるモデルは別に固定されている。
置き換えの対象は、Mem0、MemOS、Hy-Memory(Chat・Working・Codingの各場面を含む)の内部にある汎用LLMとされている。学習は2段階で、まずMemory On-Policy Distillation(OPD)、続いてAttributed Memory Reinforcement Learning(帰属つき記憶の強化学習)を行ったという。学習に使っていない枠組み、たとえばEverMemOSにもそのまま移せる、とも書かれている。
論文はモデルカード上で「Hy-Memory-30B-A3B: Attributed Reinforcement Learning for Long-Term Memory Writing」(arXiv 2610.22196)とされている。本記事では論文本体は取得しておらず、以下の数字はすべてモデルカードの表から引いている。
性能は? 4枠組みの平均で55.49、差は小さい
モデルカードの評価は、記憶を書くモデルだけを入れ替える設計だ。枠組みのバージョン、プロンプト、検索設定、回答モデル、採点モデルは固定し、各ライターは空の状態から自分で記憶を作る。計算量を抑えるため、主な評価は各ベンチマークの固定20%サブセットで行っている。1つの枠組みの点数は、LoCoMo Judge、LongMemEval、PersonaMem-v2、Travel SPS、Shopping PS、Code Memory Bench(CMB)の6指標の単純平均で、全体は4枠組みの単純平均である。
Table 1(同社測定)は次のとおり。
| 書き込みモデル | Mem0 | Hy-Memory | MemOS | EverMemOS | 平均 |
|---|---|---|---|---|---|
| Hy-Memory-30B-A3B | 54.02 | 60.55 | 50.51 | 56.89 | 55.49 |
| Claude Opus 5 | 53.43 | 60.53 | 50.50 | 54.04 | 54.62 |
| DeepSeek V4.1 Flash | 49.73 | 60.20 | 49.17 | 55.47 | 53.64 |
| Hy3 | 45.99 | 58.06 | 50.19 | 52.30 | 51.63 |
| Qwen3.6-35B-A3B | 47.51 | 55.87 | 47.36 | 50.75 | 50.37 |
| Hy3-A3B Base | 40.20 | 50.39 | 49.05 | 50.98 | 47.66 |
| Qwen3-30B-A3B | 39.81 | 45.67 | 45.44 | 46.57 | 44.37 |
モデルカードによると、表中の「DeepSeek Flash」はDeepSeek V4.1 Flashのことだ。
Claude Opus 5との差を枠組み別に引き算すると、次のようになる(表の数字からの計算)。
| 枠組み | 差(Hy-Memory-30B-A3B − Claude Opus 5) |
|---|---|
| Mem0 | +0.59 |
| Hy-Memory | +0.02 |
| MemOS | +0.01 |
| EverMemOS | +2.85 |
| 平均 | +0.87 |
平均の差0.87点のうち、大きな部分はEverMemOSでの2.85点だ。モデルカードはEverMemOSを学習に使っていない「保留(held-out)」の枠組みとしている。一方、Hy-MemoryとMemOSでは、小数第2位までの表示で差は0.02点と0.01点にとどまる。モデルカードにはサブセットの抽出方法の詳細や、点数のばらつきを示す数字は載っていない(取得したページの範囲)。この差を「上回った」と読むか「並んだ」と読むかは、読者の判断に委ねられる。
指標ごとに見ると勝ち負けが分かれる
Table 2〜5には6指標ごとの点数がある。平均が近くても、中身は一様ではない。
- Mem0の枠組み: LongMemEvalはHy-Memory-30B-A3Bが73.00、Claude Opus 5が66.00。Travelは54.51対42.98。一方、LoCoMoは59.54対69.47、CMBは67.13対70.74で、Opus 5が上。
- EverMemOS(保留): CMBは63.19対49.53と開きがある。LongMemEvalは76.00対80.41でOpus 5が上。DeepSeek V4.1 FlashはTravelで59.47と、Hy-Memory-30B-A3Bの56.56より高い。
- Shopping PS: 4つの枠組みのどこでも、どのモデルも14〜24点の範囲に収まり、全体に点数が低い。
平均だけで「Opus 5を超えた」と受け取ると、この凹凸が見えなくなる。記憶のライターに何を期待するかで、見るべき列は変わる。
手元で動かすには? 配布条件と手順
Hugging Faceの表示から読み取れる範囲を並べる。
| 項目 | モデルカード・ページの記載 |
|---|---|
| 作成日時 | 2026年10月15日9時52分UTC |
| 最終更新 | 2026年10月16日8時12分UTC |
| ライセンス | apache-2.0(タグとライセンス欄) |
| 規模 | 約30B。モデルカードは「約3B active」と説明 |
| 精度・容量 | BF16、ファイル合計は約60GB(60,133,351,909バイト) |
| 対応言語 | 英語・中国語(タグ) |
| 配布の条件 | 連絡先情報の共有への同意が必要(gated: manual) |
| 推論サービス | 取得時点では、どのInference Providerにも載っていない |
| 参照先 | コードと評価ツール=GitHubのTencent-Hunyuan/Hy-Memory、技術報告=arXiv 2610.22196 |
モデルカードのクイックスタートは、vLLM(v0.31.0で確認)で --served-model-name hy-memory として立ち上げ、OpenAI互換APIを呼ぶ形だ。例では、システムプロンプトで「明示された事実と好みだけを抜き出し、推測や創作をしない。memories のリストを持つJSONだけを返す」と指示し、名前・居住地・職業・好み・食事制限を含む短い自己紹介から記憶を作っている。reasoning_effort は no_think を指定している。
日本時間17時台に確認して見えたこと
取得した時点(日本時間2026年10月16日17時49分)のページには、モデルカードの本文と評価表が表示されていた。一方で、ページ上部には「このモデルにアクセスするには連絡先情報の共有に同意する必要がある」という表示があり、ファイルの中身を見るにはHugging Faceにログインして条件を承諾する形になっていた。「リポジトリは公開されているが、ファイルと内容にアクセスするには条件への同意が必要」という文言だ。ダウンロード数は「-」表示(ページ内のデータ上は0)、いいねは0、リポジトリ作成から約23時間という状態だった。
ライセンス欄はApache 2.0だが、重みの取得に同意操作が入る点は、導入前に自社の規定と照らす材料になる。私は同意操作もダウンロードも実行しておらず、モデルを動かして試してもいない。以上は取得したページに表示されていた範囲の話だ。
この発表からは分からないこと
- 第三者の再現: 数字はTencent Hunyuanの自社測定で、20%サブセット上のもの。取得したページには、外部機関による検証の記載は見当たらなかった。
- 論文の中身: 論文(arXiv 2610.22196)とGitHubは、今回取得していない。サブセットの作り方や学習データの詳細は未確認。
- 日本語での記憶: 対応言語のタグは英語と中国語。日本語の会話を記憶させたときの性能について、取得したページに記載は見当たらなかった。
- 運用コスト: 稼働約3Bとはいえ、重みは総30B分(約60GB)ある。推論に必要なGPUメモリの目安は、今回のページには書かれていなかった。
- 料金: 重みはHugging Faceで配布される形で、取得したページに料金表はない。推論サービスについては、どの提供事業者にも載っていないという表示だった。
オープンウェイト公開の別の例としては、Metaのオープンウェイト「Muse Spark Open」の記事がある。
出典と確認時刻
- tencent/Hy-Memory-30B-A3B · Hugging Face(Tencent Hunyuan公式): https://huggingface.co/tencent/Hy-Memory-30B-A3B
- 確認時刻: 日本時間2026年10月16日17時49分
ページ内のGitHub(Tencent-Hunyuan/Hy-Memory)とarXiv(2610.22196)は、リンクの存在を確認しただけで、中身は取得していません。
本記事は続報があり次第更新します。
この記事でよく聞かれること
- Hy-Memory-30B-A3Bとは何ですか?
- Tencent Hunyuanが公開した、長期記憶の書き込み用モデルです。モデルカードによると、Mem0・MemOS・Hy-Memoryといった外部メモリ枠組みの中で、何を残し、どれだけ正確に表し、新しい情報で記憶をどう更新するかを決める部分を担います。稼働パラメータは約3Bです。
- Claude Opus 5より高性能なのですか?
- モデルカードの表では、4つの枠組みの平均がHy-Memory-30B-A3Bで55.49、Claude Opus 5で54.62です。ただしTencent Hunyuan自身が、各ベンチマークの固定20%サブセットで測った値です。枠組み別に見ると、差が大きいのはEverMemOSの2.85点で、Hy-Memoryは0.02点、MemOSは0.01点しかありません。
- ライセンスと入手条件は?
- モデルカードのライセンス欄はApache 2.0です。一方、Hugging Face上のリポジトリには「連絡先情報の共有に同意しないとファイルと内容にアクセスできない」という表示があります(取得時点)。重みはBF16で、ファイルの合計は約60GBと表示されています。
- どうやって動かしますか?
- モデルカードはvLLM(v0.31.0で確認とのこと)で配信し、OpenAI互換APIから呼び出す手順を載せています。サービング名は hy-memory で、例では推論を切る no_think モードでユーザーの事実や好みを抜き出しています。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開 8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
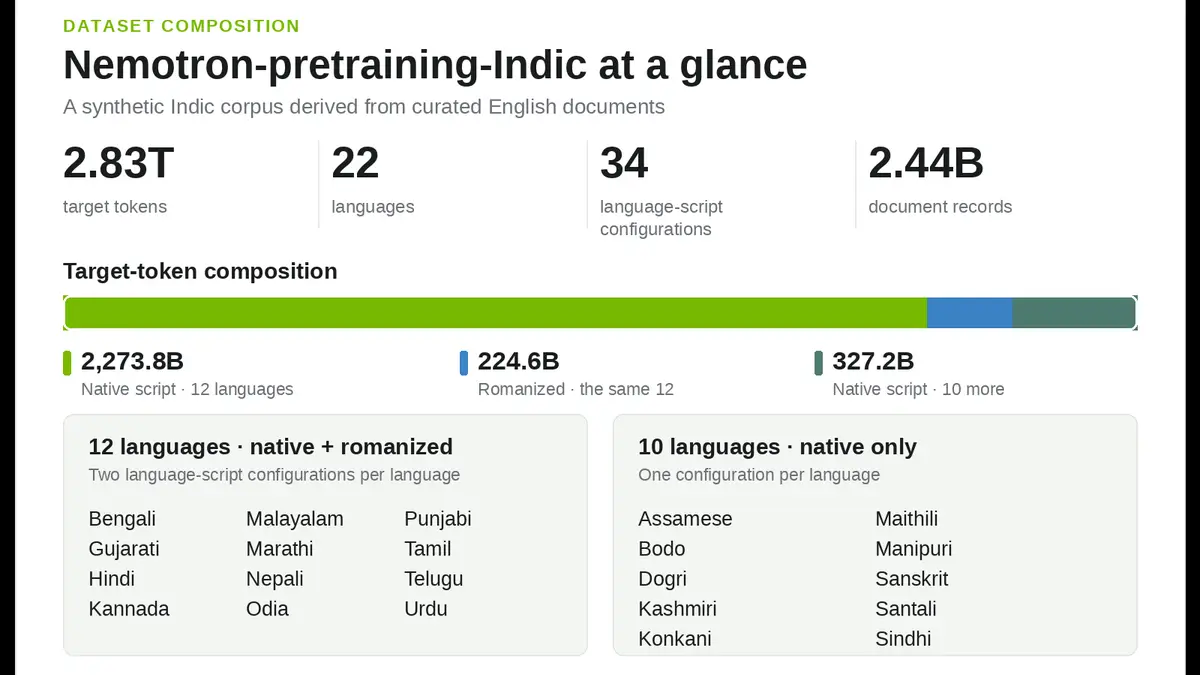
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開 生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
LoRAとは──元の重みを凍結し、小さな行列2つだけを学習する仕組み。原論文はGPT-3 175Bで「学習パラメータ1万分の1・GPUメモリ3分の1」、QLoRAは「65Bを48GB未満」。画像生成での使われ方と作り方の流れ
LoRAとは──元の重みを凍結し、小さな行列2つだけを学習する仕組み。原論文はGPT-3 175Bで「学習パラメータ1万分の1・GPUメモリ3分の1」、QLoRAは「65Bを48GB未満」。画像生成での使われ方と作り方の流れ
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開 8Bと30B、VRAMは基本モデルとほぼ同じと説明
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開8Bと30B、VRAMは基本モデルとほぼ同じと説明
 動画
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開 公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く