
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
Swiss AI Initiativeは2026年10月15日、オープンモデルApertus 1.5(8Bと70B)のリリースノートをHugging Faceで公開した。画像・音声の理解、思考モード、262,144トークンの文脈長を備え、重みは7月24日からApache 2.0で配布済み。技術報告書はarXivに10月11日付で提出されている。
目次
Swiss AI Initiativeは2026年10月15日(UTC 9時台、日本時間では同日18時台)、完全オープンの言語モデル「Apertus(アペルトゥス)1.5」のリリースノートをHugging Faceで公開した。Apertus 1.0の8Bと70Bを拡張し、画像・音声の理解、任意で切り替える思考モード、従来の4倍にあたる262,144トークンの文脈長、指示追従とツール利用の改善を加えたとしている。重みは2026年7月24日にApache 2.0で公開済みで、今回は詳細を技術報告書(arXiv:2610.15542)とあわせてまとめた形だ。
3行まとめ
- Swiss AI Initiativeが、Apertus 1.5(8B・70B)のリリースノートを2026年10月15日に公開。重みは7月24日からApache 2.0で配布済み
- 画像・音声の入力、思考モード、262,144トークンの文脈長に対応(出力はテキストのみ)。8Bは追加4兆、70Bは追加2兆トークンを学習(同プロジェクト発表)
- 評価は「最前線のオープンウェイトには届かない」と同プロジェクト自身が書く。日本語に触れた記述は、今回確認したページには見当たらない
本記事の内容は、日本時間10月15日22時台に公式ページで確認したものです。
何が新しくなったのか
リリースノートが挙げる主な変更点は次の6つだ。以下はすべてSwiss AI Initiative側の説明である。
| 項目 | 内容 |
|---|---|
| 画像・音声の理解 | 文書・図・写真を入力できる。音声も扱えるが「実験的」とされる |
| 思考モード | 回答の前に推論させるモード。推論問題の性能が上がるという |
| 文脈長 | 262,144トークン(Apertus 1.0の4倍) |
| 指示追従 | 1.0より指示に沿った応答になるという |
| ツール利用 | 外部ツール・APIの利用を学習で強化 |
| 価値観(Open Values) | 「Apertus Charter」への準拠を強めた |
モデルは画像と音声を理解するが、生成するのはテキストだけだと書かれている。画像や音声を出力する機能ではない。
思考モードは別モデルではなく、チャットテンプレートのフラグで切り替える。論文の要旨は、思考モードで8Bの数学の推論が最大20ポイント上がると説明している。8Bモデルカードによると、思考はデフォルトでオフだ。vLLMでの起動手順には「思考モードではツール呼び出しは非対応のため、組み合わせは推奨しない」との注記がある。
どう作られたのか:画像と音声を「トークン」として同じ列に入れる
リリースノートによると、Apertus 1.5はApertus 1.0の継続事前学習で作られた。追加した学習データは8Bが4兆トークン、70Bが2兆トークンで、累計はそれぞれ19兆と17兆トークンになる。
マルチモーダルの入れ方は、別の画像エンコーダーを足す方式ではない。画像はEmu3.5のトークナイザーで、音声はWavTokenizerで離散トークンにし、テキストと同じ列に並べる「アーリーフュージョン」方式だ。512×512の画像は1,024トークン、音声は1秒あたり40トークンになる。語彙を拡張しただけでアーキテクチャは変えておらず、学習はテキストのみと同じ速度で回ったという。学習トークンの半分超はテキストのみのデータだとも書かれている。
事後学習は、SFT(3.7Mのテキストサンプルに画像・音声データを加えたもの)、長文脈SFT、検証可能な報酬による強化学習(約35万プロンプト)、DPO、そして憲章に合わせるSDPOの5段階だ。SDPOを経た最終版は8Bのみで、70Bの最終版はDPO段階のモデルである。
学習データについてプロジェクトは、公開されていて許諾が寛容なものに限り、robots.txtのオプトアウトは後から遡って尊重したと説明している。出典の一覧は「apertus-data-transparency」に載せているという。
性能はどのくらいか:「最前線には届かない」と自己評価
以下はリリースノートが書いている評価で、本記事が数字を再現したものではない。最後の項目(スイスの法律タスクと翻訳)は、リリースノートが協力者・外部評価者による結果として紹介しているものだ。記述を並べると次のとおり。
- 「最前線のオープンウェイトモデルには引き続き後れを取る」としたうえで、コーディングと指示追従は大きく改善したと書く
- 8Bは、同程度のサイズのオープンウェイトモデルを指示追従と多言語タスクで上回ると書く
- 思考モードは、AIMEのような推論中心のベンチマークをさらに押し上げる
- マルチモーダルは「Gemma 4 12Bなど現行のオープンウェイトモデルに近い」。空間理解ではオープンウェイトの中で競争力があり、文書・図表の理解ではオープンソースの中で競争力があるとする
- スイスの法律タスクでは、主要なオープンウェイトモデルと同等。Last Translation Benchmarkでは、8Bの機械翻訳がGPT-OSS-20Bと並び、Claude Haiku 4.5やGoogle翻訳を上回ると書く
論文の要旨はもう少し慎重で、画像・音声では「特化した視覚・音声モデルが、英語などリソースの多い言語の知覚・文字起こしでは先を行く」と認めている。強いのは文書理解と、長尺・低リソース言語の音声認識だという。
評価結果はEvalEval Coalitionの「Every Eval Ever」形式でも公開されていて、テキストの評価は誰でも同じ設定で再実行して比べられる、とリリースノートは書く。
どこで使えるのか:入手先とAPI提供元
重みはHugging Faceの「Apertus v1.5」コレクションにある。最終版のほか、ベース、SFT、RLVR、DPOの中間チェックポイントも置かれている。リリースノートは、各段階でモデルの振る舞いがどう変わるかを研究者が調べられるようにするためだと説明する。
アプリでは、Proton LumoとInfomaniak Euriaが最近Apertus 1.5を組み込んだという。開発者向けのAPIは、Swisscom、Infomaniak、Phoeniqsなどが提供を発表している。2026年9月17日付のApertus AI公式記事には、提供元の一覧がある。
| 提供元 | モデル | データセンター | 従量課金 |
|---|---|---|---|
| Swisscom | 70B | スイス | あり |
| Infomaniak | 70B | スイス | あり |
| PHOENIQS | 70B | スイス | あり |
| Safe Swiss Cloud | 70B | スイス | あり |
| OnPrem.ai | 70B | スイス | 記載なし |
| stepping stone | 8B | スイス | 記載なし |
| Public AI | 8B・70B | 世界各地 | あり(無料デモも) |
| Featherless | 70B | 世界各地 | あり |
同記事の情報は2026年9月時点のものだ。AWS SageMaker、Microsoft Azure、Google Vertex AI、Exoscaleでの展開手順も案内されている。
自分の環境で動かす場合、9月17日付のApertus AI公式記事によると8Bは「多くのノートPCやワークステーションで動く」構成、70Bはサーバー級のハードウェア向けだ。動作環境はTransformersとvLLMで、いずれも現時点では公式リリース版への統合が済んでおらず、プロジェクトの改造版(Dockerイメージまたはgitブランチ)を使う手順になっている。
料金は?
今回確認した公式ページ6件には、各社APIの具体的な金額は載っていなかった。重みそのものはApache 2.0での配布だ。API提供元の料金は、各社のドキュメントを見る必要がある。
日本の読者が気にする点
今回取得した6ページの本文を「Japanese」「日本語」で検索したが、該当する記述はなかった。モデルカードは「幅広い言語に対応」と書くだけで、日本語の評価結果や対応言語の一覧はこの6ページからは確認できない。論文本体(PDF)は今回読んでいないため、そちらに日本語の数字がある可能性は残る。
日本時間22時台に確認して気づいた、記載のずれ
日本時間22時28分ごろに8Bのモデルページを開くと、冒頭に「連絡先(メールとユーザー名)の共有に同意しないとアクセスできない」というゲートが出ていた。Apache 2.0に加えて、利用規約(AUP)への同意も求められる設定だ。ログインしていない状態で見ているので、ログイン後の画面は未確認である。
もう1点。同じモデルカードの本文には「技術報告書は今後数週間以内に公開予定」という一文が残っていた。一方、リリースノートは「報告書は現在入手できる」と書き、arXivのページも10月11日付の提出を示している。リリースノートより先に報告書が出ていたため、モデルカード側の文言が更新されていないように見えるが、これは筆者の推測であり、公式の説明は確認していない。
確認できなかったこと・読み分けの注意
- 性能の数字は、リリースノートと論文の要旨に書かれた文章だけを使った。個々のベンチマークの点数表は、今回は読んでいない
- 「Gemma 4 12Bに近い」「Claude Haiku 4.5を上回る」といった比較は、リリースノートが載せている評価(翻訳の比較は外部評価者の結果として紹介)で、本記事は確かめていない。比較条件(設定や版)は、リリースノート本文からは分からない
- 提供元ごとの速度は、9月17日付の公式記事が匿名化した表で載せている。同記事自身が「独立に再現して確かめるべき」と書いており、自前のデータセンター(CSCS)以外はP1〜P5と匿名で、提供元の名前は出ていない
- 次世代の予定は、リリースノートがApertus 2.0を「疎なMoE構成・全体で約6,000億パラメーター、エージェント・数学・コーディングを重視」と説明している。9月の公式記事は時期を2027年としている。いずれも計画の段階だ
- 本記事は筆者がモデルを動かして試したものではなく、公式の記載の整理である
本記事が読んだ6ページ
- Apertus 1.5 Release Notes(Hugging Face Blog)
- Apertus 1.5: From Open Text Models to Open Multimodal Reasoners(arXiv:2610.15542)
- Apertus v1.5 コレクション
- swiss-ai/Apertus-v1.5-8B
- swiss-ai/Apertus-v1.5-70B
- Inference Ecosystem(Apertus AI・2026年9月17日)
確認時刻は日本時間2026年10月15日22時28分台。本記事は続報があり次第更新します。
この記事でよく聞かれること
- Apertus 1.5とは何ですか?
- Swiss AI Initiativeが公開している、重み・学習データ・学習手順まで公開する「完全オープン」の言語モデルの第1.5世代です。8Bと70Bの2サイズがあり、Apertus 1.0に追加で事前学習を行い、画像・音声の入力、任意の思考モード、262,144トークンの文脈長を加えたと同プロジェクトは説明しています。出力はテキストのみです。
- Apertus 1.5は無料で使えますか?ライセンスは?
- 重みはApache 2.0ライセンスでHugging Faceから配布されていると、プロジェクトのリリースノートに書かれています。ただしHugging Faceのモデルページでは、利用規約(AUP)への同意とメールアドレス・ユーザー名の共有が求められる設定でした。API提供各社の料金は、今回確認したページには金額が載っていません。
- Apertus 1.5はいつ公開されましたか?
- リリースノートによると、8Bと70Bの重みは2026年7月24日にHugging Faceへ公開済みです。技術報告書のarXiv提出は10月11日、リリースノート記事の公開は10月15日(UTC 09時台)です。
- Apertus 1.5は日本語で使えますか?
- 今回取得した公式ページ6件には、日本語への対応や評価についての記述が見当たりませんでした。モデルカードは「幅広い言語に対応」とだけ書いています。日本語での性能は、公式の発表からは判断できません。
出典・参照資料
- 一次資料Apertus 1.5 Release Notes — Swiss AI Initiative(Hugging Face)公式 ↗
- 一次資料Apertus 1.5: From Open Text Models to Open Multimodal Reasoners — arXiv ↗
- 一次資料Apertus v1.5 コレクション — swiss-ai(Hugging Face) ↗
- 一次資料swiss-ai/Apertus-v1.5-8B モデルカード — Hugging Face ↗
- 一次資料swiss-ai/Apertus-v1.5-70B モデルカード — Hugging Face ↗
- 一次資料Inference Ecosystem(2026年9月17日)— Apertus AI公式 ↗

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
LoRAとは──元の重みを凍結し、小さな行列2つだけを学習する仕組み。原論文はGPT-3 175Bで「学習パラメータ1万分の1・GPUメモリ3分の1」、QLoRAは「65Bを48GB未満」。画像生成での使われ方と作り方の流れ
LoRAとは──元の重みを凍結し、小さな行列2つだけを学習する仕組み。原論文はGPT-3 175Bで「学習パラメータ1万分の1・GPUメモリ3分の1」、QLoRAは「65Bを48GB未満」。画像生成での使われ方と作り方の流れ
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開 LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
 動画
ドイツ製AI「Kolibri」を手元のMacで動かした 78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
ドイツ製AI「Kolibri」を手元のMacで動かした78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
 動画
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表 総合点は7か月前のQwen3.5・Gemma 4に届かず
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表総合点は7か月前のQwen3.5・Gemma 4に届かず
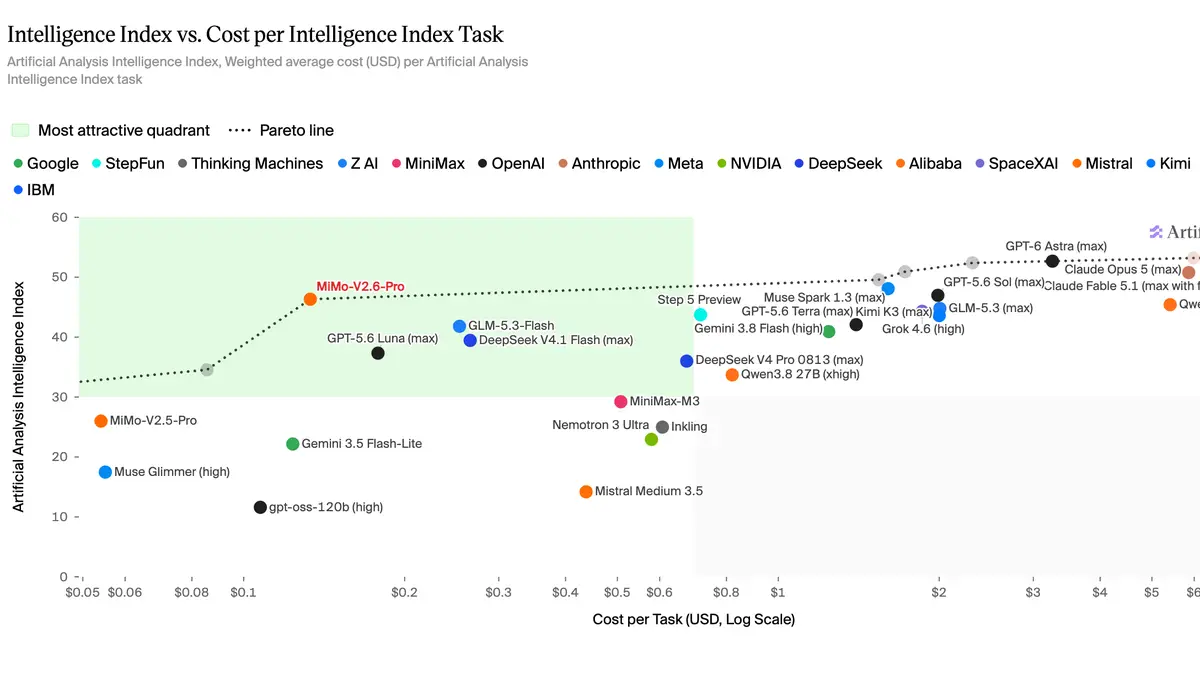
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
 動画