Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIはHugging Faceのブログで、小型モデル群LFM2.5の実用性を上げる2本を公開した。①DSpark(8月20日):LFM2.5-1.2B-Instruct・2.6B・8B-A1B向けの草稿モデル(各約300M)を公開。軽い草稿モデルが候補トークンを出し、本体が1回の順伝播でまとめて検証する投機的デコードで、貪欲デコードの出力は基準と同一のまま、H100(SGLang)で最大3.18倍、M4 Max MacBook Pro(llama.cpp・Metal)で最大2.87倍、2.6BはMATH500で61→137トークン/秒。関数呼び出しの遅延は平均57%減。llama.cppとSGLangに上流で対応。②GRPO微調整(9月3日):LFM2.5-350MをTRLのGRPOで、JSON形式・フィールド数・スキーマ検証の3つの報酬、約500サンプル・100ステップで無料枠の16GB GPUに収まる規模で学習し、構造化出力ベンチマークIFStruct(2,000問)で22.6%→29.7%。評価はM5 Max 36GBのMacBookでローカル実行。
2026年9月18日・日本時間時点の情報です。 Hugging FaceのLiquid AIのブログ2本(8月20日・9月3日)を読んだ。Hugging Faceの夏の報告で「米国で3番目に多くモデルを公開した」LiquidAIの、小型モデルを端末で速く・正確に使うための実務的な2本。ローカルLLMとはの補足として残す。
3行まとめ
- DSpark(8月20日):出力を変えずに速くする。 LLMの復号は計算より重みをDRAMからSRAMへ流す時間に縛られる。投機的デコードは、軽い草稿モデルが候補トークンを出し、本体が1回の順伝播でまとめて検証して重みの読み出し費用を分け合う。DSparkは、①本体の文脈特徴を条件にしたDFlash型の並列バックボーン(全草稿トークンの隠れ状態を1回で出す)、②隣接トークン間のマルコフ連鎖の頭(後ろの位置の受理率を上げる)、③各トークンの生存確率を予測し、検証の費用が節約を上回る低信頼の接尾辞を刈る検証器、の3部品。Liquid AIはLFM2.5-1.2B-Instruct・2.6B・8B-A1B向けの草稿モデル(各約300M、5層の注意のみ、ブロック9、15エポックから受理率最高の版を選択)を公開した。貪欲デコードでは受理トークンは本体の分布と一致し、却下時は本体のトークンに置き換わるので、出力列は基準と同一、ベンチマーク精度(pass@1・完全一致)は変わらない。
- DSparkの数字。 H100(SGLang・BF16・バッチ1・温度0)で最大3.18倍、M4 Max MacBook Pro(llama.cpp・Metal・FP16 GGUF)で最大2.87倍。LFM2.5-2.6BはMATH500でH100 326→1,000トークン/秒(3.06倍)・M4 Max 61→137(2.25倍)、HumanEvalで326→835・61→161(2.63倍)、受理は10個中4.5〜5.4個。MacBookでの2.6Bは「多くの商用クラウドモデルの約140トークン/秒を超える対話性」と書く。関数呼び出しの遅延は2.6Bで平均57%減で、端末内のエージェント推論に向く。llama.cpp(公式コードベースの上、実験的Metalカーネル)とSGLang(公式のDSpark実装の上)に初日対応し、上流にオープンソースで統合。
- GRPO微調整(9月3日):小さいモデルに形式を守らせる。 構造化出力(要求した形式・形のまま解析可能な出力を返すこと)は下流システムにつなげるかを決めるが、多くのベンチマークは推論や抽出の点数に埋もれている。LFM2.5-350MをTRLのGRPOで、JSON形式・フィールド数・スキーマ検証の3つの報酬(重み1.0・0.5・2.0)、約500サンプル・100ステップ・1プロンプト8生成という無料枠の16GB GPU(ColabやKaggle)に収まる規模で学習。評価はIFStruct(2,000問)をllama.cppのOpenAI互換サーバー経由で、M5 Max 36GBのMacBook Proでローカル実行し、22.6%→29.7%(ローカル基準22.6%はIFStructのブログの21.1%に近い)。IFStructの公式スコアの再現ではなく、「課題特化の軽い微調整で小さいモデルがはるかに大きいモデルに並ぶ」ことを示すのが目的、と注記。
自社測定の数字、29.7%はまだ低い
- DSparkの「出力は同一のまま速くなる」は、投機的デコードの性質で、品質と引き換えの量子化とは別の軸。当サイトのvLLMのDFlash2と同じ系統で、Liquid AIは端末側(llama.cpp・Metal)に初日で持ち込んだ点が違う
- GRPO側は「無料枠で100ステップ」という再現しやすさが価値で、報酬関数の3本立て(形式・件数・スキーマ)は他の小型モデルにも流用できる。Googleのautofinetuneのような探索ループの中身にそのまま入る型
- 29.7%は「7ポイント改善」であって高い遵守率ではない。本番でスキーマ遵守が要るなら、モデル側の改善と併せて出力側の検証・再試行は要る
- どちらも数字はLiquid AI(とHugging Face)の測定。M4/M5 Maxの数字は当サイトの読者のMacと条件が近い
原文の数字を突合、実機では未検証
この記事の下調べで、筆者は9月18日にHugging Faceのブログ2本を取得し、草稿モデルのサイズ・3部品・3.18倍/2.87倍・MATH500とHumanEvalの数字・57%・対応推論系・報酬の重み・500サンプル/100ステップ/8生成・22.6%→29.7%・評価環境がその原文にあることを確認した。GitHubのノートブックとモデルカードは開いていない。筆者は自分のMacでLFM2.5を動かしていない。
温度>0の速度と8B-A1Bの倍率は非公開
- DSparkの温度>0(サンプリング)時の速度と品質
- 8B-A1Bの各ベンチマークの倍率(表は一部のみ読めた)
- IFStructの29.7%が「はるかに大きいモデル」の何と並ぶのか(具体名なし)
出典はHugging Faceのブログ
- Up to 3.2x Faster Inference with LFM2.5-DSpark(Liquid AI・2026年8月20日)
- Fine-tuning a 350M Model for Better Structured Outputs in 100 GRPO Steps(Liquid AI・Hugging Face・2026年9月3日)
関連記事
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
vLLMに投機的デコードの新手法「DFlash2」 1H200・GSM8Kで自己回帰の3.51倍のスループット
vLLMに投機的デコードの新手法「DFlash2」1H200・GSM8Kで自己回帰の3.51倍のスループット
 動画
ローカルLLMとは何か 自分のPCでAIを動かす仕組み・利点・始め方を解説
ローカルLLMとは何か自分のPCでAIを動かす仕組み・利点・始め方を解説
LM Studioの使い方と料金【2026年9月版】 無料でローカルLLMを動かす手順(Mac M1〜M4・Windows・Linux、16GB推奨、4bit以上の量子化)、OpenAI互換API・MCP・文書チャット、新アプリ「Bionic」とBionic+ $20/Pro $100のクラウド(Kimi K3・GLM 5.3・DeepSeek V4 Flash、ZDR)
LM Studioの使い方と料金【2026年9月版】無料でローカルLLMを動かす手順(Mac M1〜M4・Windows・Linux、16GB推奨、4bit以上の量子化)、OpenAI互換API・MCP・文書チャット、新アプリ「Bionic」とBionic+ $20/Pro $100のクラウド(Kimi K3・GLM 5.3・DeepSeek V4 Flash、ZDR)
Google「autofinetune」 仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
Google「autofinetune」仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
Hugging Face「オープンモデルの現状・2026年夏」 中国ラボの月間最大モデル(754B〜2.78T)がほぼ毎月米国を上回る、米国で最多公開はAMDとNVIDIA、ダウンロード上位25と「いいね」上位25の重なりは1本だけ、Qwenの派生は151,448本で1日180〜210本、Hubを叩くエージェントはClaude Codeが7月44.4%・Codexが20.8%
Hugging Face「オープンモデルの現状・2026年夏」中国ラボの月間最大モデル(754B〜2.78T)がほぼ毎月米国を上回る、米国で最多公開はAMDとNVIDIA、ダウンロード上位25と「いいね」上位25の重なりは1本だけ、Qwenの派生は151,448本で1日180〜210本、Hubを叩くエージェントはClaude Codeが7月44.4%・Codexが20.8%
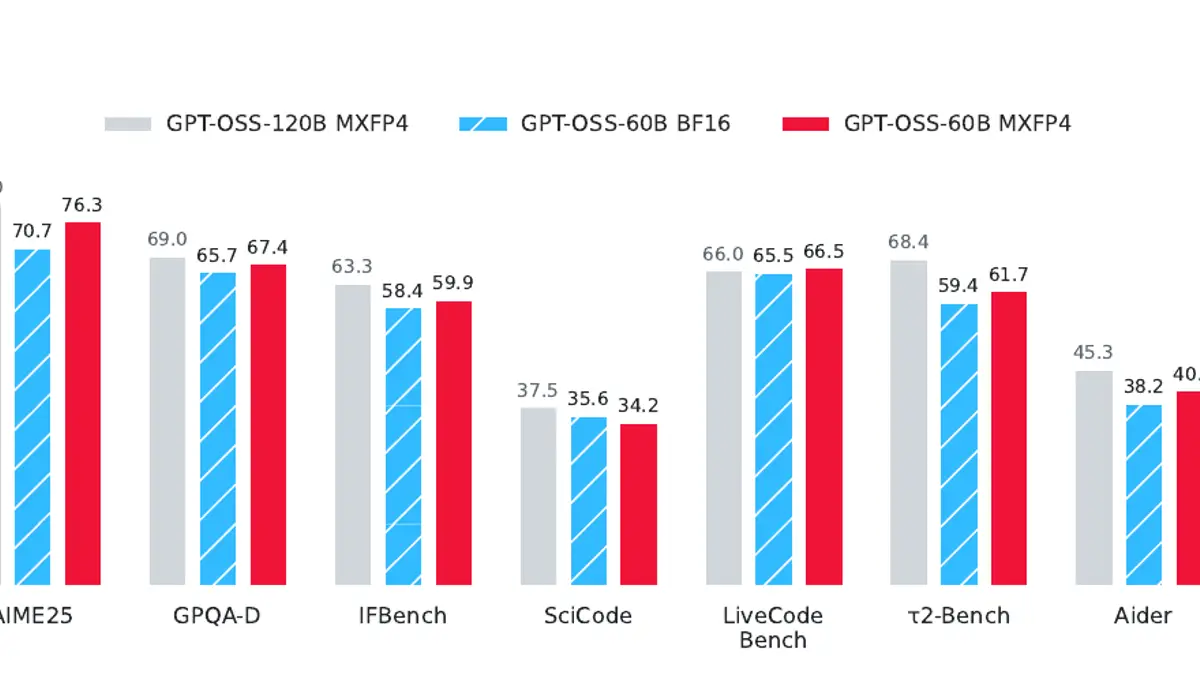
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Ai2「BenchMIRT」 100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
Ai2「BenchMIRT」100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)