NVIDIA、学習なしでDB予測する Kumo Relational(クモ・リレーショナル)を重み付きで公開41タスクで教師あり手法を上回ったと発表
日刊AIニュース10月21日(水)号:前日のAIのニュース18本を短くまとめました(約11分)›
NVIDIAは2026年10月21日、リレーショナルデータベースの予測を学習なしで行う基盤モデル Kumo Relational を公開した。15のDB・41タスクで教師あり手法を上回ったと説明し、コードはApache 2.0、重みはOpenMDW 1.1で配布している。
目次
NVIDIAは2026年10月21日(ブログの表記。Hugging Faceのブログ公開は日本時間10月22日3時26分)、リレーショナルデータベース上の予測を学習なしで行う基盤モデル「Kumo Relational(クモ・リレーショナル)」を公開した。NVIDIAの説明では、予測したい内容をクエリで書くと、モデルが最大1万件の過去の例を文脈として集め、1回の順伝播で解約・需要・不正などの結果を予測する。コードはApache 2.0、重みはOpenMDW License Agreement 1.1で、重みはHugging Faceから取得できる。
3行まとめ
- NVIDIAがKumo Relationalを公開。15のDB・41タスクで教師あり手法を上回ったと発表(NVIDIA側の評価)
- SAP SALTではAutoGluonのアンサンブルをMRRで8%上回り、RelArena-αでは最高スコアのモデルと同程度の精度を約430倍速く出すと説明
- コードはApache 2.0、重みはOpenMDW 1.1。
pip install structured-data-modelsで使え、NIMとしても動かせる
本記事の内容は、日本時間10月22日3時台に公式ページで確認したものです。
NVIDIAの欧州向けオープンモデル群の発表を扱った別記事でも、Kumoに触れている(欧州向けオープンモデル群の記事)。本記事はそのうちKumo Relational単体について、NVIDIAのブログ、モデルページ、公式ドキュメント、arXivの論文ページから整理する。
Kumo Relationalは何をするモデルか
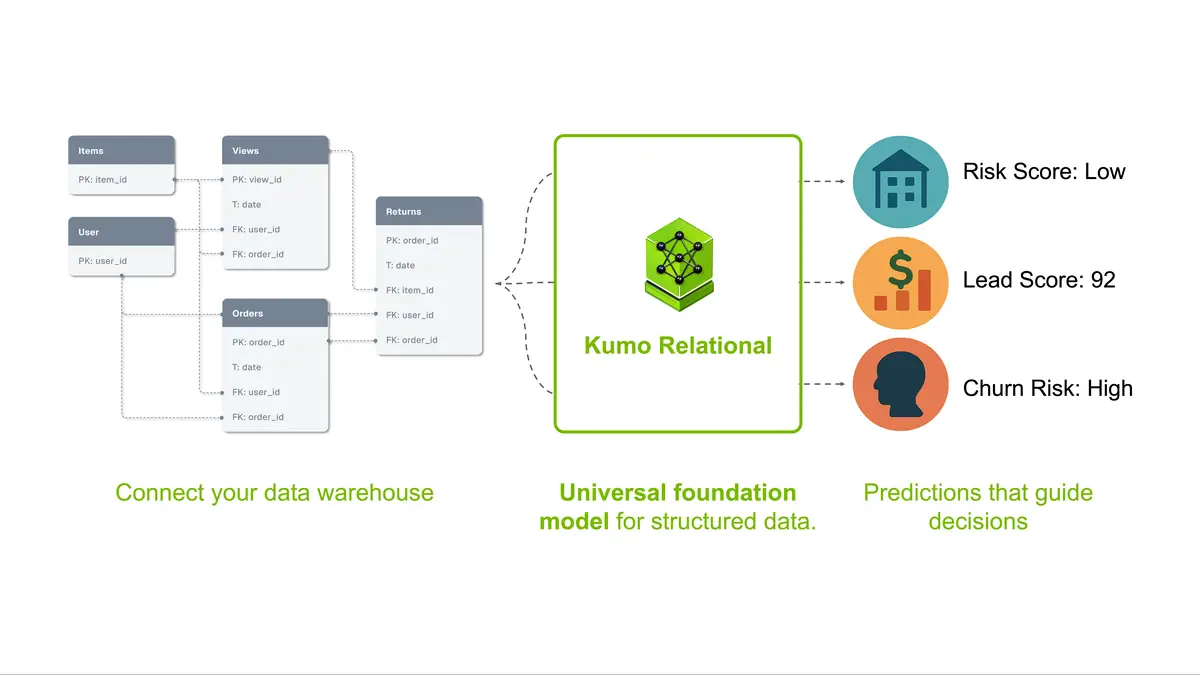
NVIDIAによると、Kumo Relationalは事前学習済みの「リレーショナル基盤モデル」で、企業のデータベースに直接つないで予測を出す。多くの構造化データ向け基盤モデルは1枚の平らな表を前提にするが、Kumo Relationalはユーザー・注文・商品のようにつながった複数のテーブルを、外部キーと時刻を保ったまま扱うという。「直近30日の平均注文額」のような手作業の集計で1行にまとめる工程が要らない、というのが同社の主張だ。
仕組みについてNVIDIAのブログは次のように説明している。
- 予測はPredictive Query Language(PQL)で書く。「何を予測するか」を宣言する形式で、公式の例は
PREDICT COUNT(orders.*, 0, 30, days) FOR EACH users.user_id - 時間を扱うタスクでは、基準時刻より前のデータだけをモデルに見せ、基準時刻より後の出来事から正解を計算する。同社はこれでデータ漏洩を防ぐとしている
- 各例は「ある時点のエンティティ周辺の部分グラフ」と「正解」の組で、推論時に最大1万件を文脈として読む
- 表の内側は列方向と行方向のアテンションで処理し、表をまたぐ部分は主キー・外部キーに沿ったグラフアテンションで処理する
NVIDIAのブログによると、事前学習は現実のデータベースを模した合成のリレーショナルデータだけで行ったという(後述のとおり、arXivの要旨の書き方とは食い違う)。同社は合成データ生成にPluRel(ICML 2026)の方式を土台にしたと書き、Kumoチームのメンバーが同論文の開発と共著に関わったと明記している。精度を最大限にしたい場合は、特定のデータセットとタスクで微調整もできる。
モデルページには「KumoRFM-2をベースにしている」「事前学習済みのTabICLv2の重みを微調整している」とも書かれている。arXivに載っている論文は「KumoRFM-2」(2026年4月14日投稿)で、ブログの本文が「この論文」と呼ぶものと同じ41ベンチマークの結果を扱っている。
結果はどうだったか──NVIDIA側が示した数字
NVIDIAによる評価の主な数字は次のとおり。いずれも同社ブログの記載で、第三者の再現ではない。
| 比較 | NVIDIAが示した結果 |
|---|---|
| 評価範囲 | RelBench V1/V2・SAP SALT・4DBInferの15データベース・41タスク。事前学習では見ていないデータ |
| RelBench V1の分類 | 専門家が特徴量を作った勾配ブースティング木を、平均でAUROC約4ポイント上回る |
| SAP SALT(そのまま) | 特徴量を作ったXGBoostをMRRで7ポイント上回る |
| SAP SALT(微調整後) | 同XGBoostをMRRで13ポイント上回る |
| SAP SALT | 大型のAutoGluonアンサンブルをMRRで8%上回る。直近の表形式基盤モデルは約25%上回る。微調整するとAutoGluonとの差は16% |
| RelArena-α(RelBench V1) | 推論時間は1,000件あたり中央値約17秒、Elo 1,842。最高スコアの rt-plurel は Elo 1,878で約7,300秒、約430倍遅いと説明 |
NVIDIAはさらに、文脈に使う学習データが全体の0.2%しかない場合でも良好に動く、外部キーのリンクを最大75%取り除いても安定する、ノイズの列を多数足してもほとんど悪化しない、とも書いている。規模については、独自のグラフエンジンでメモリマップI/Oを使い、500B行以上のデータベースまで扱えると説明している。
「教師あり手法を上回る初のfew-shot基盤モデル」という位置づけは、ブログとarXivの要旨の双方にある。要旨では「私たちの知る限り」と留保が付き、改善幅は「最大8%」と書かれている。
どこで、どう使えるのか
NVIDIAによると、使い方は2通りある。
- ライブラリで直接動かす: オープンソースのGPUネイティブな
structured-data-modelsライブラリをpip installし、sdm.models.KumoRelational(device="cuda")でモデルを読み込む。重みは初回利用時にHugging Face Hubから自動で取得される - NIMとして別サービスにする: NVIDIA NIMとして立て、
structured-data-models-clientからPQLで予測を投げる。クライアントが文脈の例と関連テーブルを集めてリクエストを送る。公式ドキュメントでは、NIMは分類・回帰、時系列の先の予測(Forecasting)、関連エンティティの推薦・ランキング(Link Prediction)に対応すると説明している
ライセンスは、コードがApache 2.0、重みがOpenMDW License Agreement 1.1。モデルページは、微調整元のTabICLv2の重みがBSD-3-Clauseで、その表示と全文をTHIRD-PARTY-NOTICES.txtに残していると書いている。
NVIDIAはエージェントからの利用も売りにしており、PQLが「予測の質問を投げる簡単な窓口」になると説明している。
日本時間3時台に公式ページを見て気づいたこと
取得した各ページを見比べると、気になる点が3つあった。
- ブログのコード例は
sdm.models.KumoRelational(device="cuda")だが、Hugging Faceのモデルページの例はtask="classification"とnum_estimators=8を指定している。ブログ側は引数を省いた簡略版に見える。実際にどちらの書き方で動くかは、私たちはコードを実行していないので確認できていない - 日本時間10月22日3時28分に取得したモデルページでは、「Downloads last month」が2,130、Likeが27で、「このモデルはどのInference Providerにもデプロイされていない」と表示されていた。この時点では、Hugging FaceのInference Providers経由で試せる状態ではなかった
- 事前学習データの書き方が、ブログと論文で違う。ブログは「完全に合成のリレーショナルデータで事前学習」と書くが、arXivのKumoRFM-2の要旨は「合成と実世界のデータの大きなコーパス」で事前学習したと書いている。モデルページによればKumo RelationalはKumoRFM-2をベースにしたものだが、両者の事前学習データが同じかどうかは、取得したページからは判断できなかった
NVIDIA自身が挙げている限界と、今回確認できていないこと
NVIDIAのブログに書かれた限界は3つ。
- 意味のあるテーブル間の関係と時間変化があるデータ(ユーザー行動の推移など)で最も力を発揮する
- 学習データが非常に大きいタスクでは、タスク専用の教師ありモデルが上回る可能性がある(同社のベンチマークでは文脈を最大1万件にしていた)。同社はその場合に微調整を使うとしている
- 予測の手がかりが限られたホップ数以内にある必要がある。同社は、少数の関連テーブルに絞ったクエリから始めて広げることを勧めている
そのほか、本記事の立場から次の点を書いておく。
- 41タスクの数字はNVIDIAとKumoの著者らが自分たちの論文・ブログで示したもの。独立した第三者の追試は、今回取得したページには出ていなかった
- 今回取得した4ページには、NIM利用の料金や、日本での提供条件に関する記載は見つからなかった(「price」「Japan」などで取得テキストを検索して確認した)。ライブラリと重みは公開されているが、運用に必要なGPUの規模も今回のページからは読み取れていない
- 私たちは製品を試していない。以上は公式ページの記載を整理したもの
ブログ下部の「More from this author」には、同じ10月21日付の「Kumo Forecast」の記事の見出しも並んでいたが、本文は取得していないため、本記事では扱わない。
出典と確認時刻
- NVIDIA Kumo Relational Outperforms Supervised Machine Learning on Relational Data, No Training Required(Hugging Face Blog)
- nvidia/Kumo-Relational(Hugging Face)
- Kumo Relational NIM(NVIDIAドキュメント)
- KumoRFM-2: Scaling Foundation Models for Relational Learning(arXiv:2604.12596)
確認時刻は、いずれも日本時間2026年10月22日3時27〜28分です。本記事は続報があり次第更新します。
この記事でよく聞かれること
- Kumo Relationalとは何ですか?
- NVIDIAが2026年10月21日に公開した、リレーショナルデータベース向けの事前学習済み基盤モデルです。NVIDIAの説明では、予測したい内容をクエリで書くと、最大1万件の過去の例を文脈として集め、1回の順伝播で解約・需要・不正などを予測します。タスクごとの学習や特徴量設計、テーブルの平坦化は不要としています。
- Kumo Relationalは無料で使えますか?ライセンスは?
- NVIDIAのブログによると、コードはApache 2.0、モデルの重みはOpenMDW License Agreement 1.1で公開されています。重みはHugging Faceの nvidia/Kumo-Relational から取得できます。NIMとして動かす場合の料金は、今回確認したページには記載がありませんでした。
- どれくらい精度が高いのですか?
- NVIDIAの発表では、RelBench・SAP SALT・4DBInferの15データベース・41タスクで、教師ありの関係深層学習モデルや専門家が特徴量を作った勾配ブースティング木を上回りました。SAP SALTではAutoGluonのアンサンブルをMRRで8%上回ると説明しています。数字はNVIDIA側の評価で、第三者による再現は今回確認していません。
- どんな場面では向きませんか?
- NVIDIAは限界として、意味のあるテーブル間の関係や時間変化があるデータで最も力を発揮すること、学習データが非常に大きいタスクでは教師ありモデルが上回る場合があること、予測の手がかりが限られたホップ数内にある必要があることを挙げています。
出典・参照資料
- 一次資料NVIDIA Kumo Relational Outperforms Supervised Machine Learning on Relational Data, No Training Required — Hugging Face Blog(NVIDIA) ↗
- 一次資料nvidia/Kumo-Relational — Hugging Face モデルページ ↗
- 一次資料Kumo Relational NIM — NVIDIA公式ドキュメント ↗
- 一次資料KumoRFM-2: Scaling Foundation Models for Relational Learning — arXiv ↗

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
NVIDIA、タンパク質設計のオープンモデルRFD4-Proteina(アールエフディーフォー・プロテイナ)をブラウザで試せるHugging Face Spacesで公開 11月4日まで専用GPUが無料
NVIDIA、タンパク質設計のオープンモデルRFD4-Proteina(アールエフディーフォー・プロテイナ)をブラウザで試せるHugging Face Spacesで公開11月4日まで専用GPUが無料
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開 生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIA、画像と文章を横断検索できる Nemotron 3.5 Embed/Rerank/Parse(ネモトロン)をオープンで公開 ViDoRe v3.1のdense検索で首位、Rerank追加でエージェントのトークン費用は約14%減と同社
NVIDIA、画像と文章を横断検索できる Nemotron 3.5 Embed/Rerank/Parse(ネモトロン)をオープンで公開ViDoRe v3.1のdense検索で首位、Rerank追加でエージェントのトークン費用は約14%減と同社
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開 4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開 8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
NVIDIA、オープンソースのAgent Toolkit(エージェントツールキット)に「Agent Knowledge Foundation」を追加 社内データをAIエージェントに使わせる基盤、Palantir・Databricks・Snowflakeとの連携例も
NVIDIA、オープンソースのAgent Toolkit(エージェントツールキット)に「Agent Knowledge Foundation」を追加社内データをAIエージェントに使わせる基盤、Palantir・Databricks・Snowflakeとの連携例も
NVIDIA、DSXで欧州のAIファクトリーの冷却水をほぼゼロにできる設計 同じトークン数を最大30%少ない電力で出すMaxLPS(マックスエルピーエス)などをGTC Berlinで発表
NVIDIA、DSXで欧州のAIファクトリーの冷却水をほぼゼロにできる設計同じトークン数を最大30%少ない電力で出すMaxLPS(マックスエルピーエス)などをGTC Berlinで発表