NVIDIA、画像と動画も読む「Nemotron(ネモトロン)3.5 Super VL」を公開120B・有効12B、公式グラフの首位は12項目中1つで速さはQwen3.5の2.34倍
NVIDIAは2026年10月15日、文字・画像・動画を入力できるオープンウェイトの視覚言語モデル「Nemotron 3.5 Super VL」をHugging Faceで公開した。総パラメータ120B(推論時に動くのは12B)、文脈は最大100万トークン。公式グラフでは6つのオープンモデルとの比較で首位は12項目中1項目にとどまる一方、GB200での出力スループットはQwen3.5の2.34倍とされる。
目次
NVIDIAは2026年10月15日、文字・画像・動画を入力できる視覚言語モデル「Nemotron(ネモトロン)3.5 Super VL」をHugging Faceで公開した。総パラメータは120Bで、推論のたびに動くのは12B。文脈は最大100万トークンまで扱えるとしている。重みは4bit量子化の「NVFP4」版とBF16版、学習前のBase版が並んで公開され、ライセンスは条件の少ないOpenMDW-1.1だ。NVIDIAの公式グラフと技術報告書が強調しているのは速さで、GB200での出力スループットは同じ規模のQwen3.5の2.34倍だという。
3行まとめ
- NVIDIAがNemotron 3.5 Super VL(120B・有効12B・100万トークン)をHugging Faceで公開。文字・画像・動画を読み、ライセンスはOpenMDW-1.1(モデルカードは商用利用可と明記)
- 公式グラフの比較では、6つのオープンモデルに対して首位は12項目中1項目(GraphWalks)。多くの項目ではQwen3.8 Flash-Nextが上
- 売りは速さ。GB200 1枚あたりの出力スループットはQwen3.5の2.34倍、Qwen3.8 Flash-Nextの1.90倍(NVIDIAの技術報告書)
本記事の内容は、日本時間10月15日23時台〜16日0時台に、Hugging Faceのモデルカードと10月14日付の技術報告書で確認したものです。
何が出たのか:動くのは12Bの視覚言語モデル
モデルカードに書かれている主な仕様は次のとおり。
| 項目 | 内容 |
|---|---|
| パラメータ | 総数120B/1トークンあたり動くのは12B |
| 作り | Mamba-2とTransformerを組み合わせたMoE(MoE層ごとに512のエキスパート)+C-RADIOの画像エンコーダー |
| 文脈長 | 最大100万トークン(入力と出力で共有) |
| 入力/出力 | 文字・画像・動画(mp4・最長2分)/文字 |
| 思考 | チャットテンプレートで enable_thinking をオン・オフ |
| 動作環境の例 | DGX Spark 1台・H200 1台・H100 2台・GB200 1台 |
| 推論エンジン | vLLM・SGLang・TensorRT-LLM(NVIDIA NIMの配布もあり) |
| ライセンス | OpenMDW-1.1 |
Hugging Faceのモデルカードは公開日を「10/15/2026」としている。リポジトリ自体は10月12日に作られ、最終更新は10月15日14時32分(UTC、日本時間23時32分)だった。技術報告書は10月14日付で、8月に公開済みの小型版「Nemotron 3.5 Lightning」(30B・有効3B・文字のみ)とあわせて1本にまとめている。
公式グラフを数えると、首位は12項目中1つ
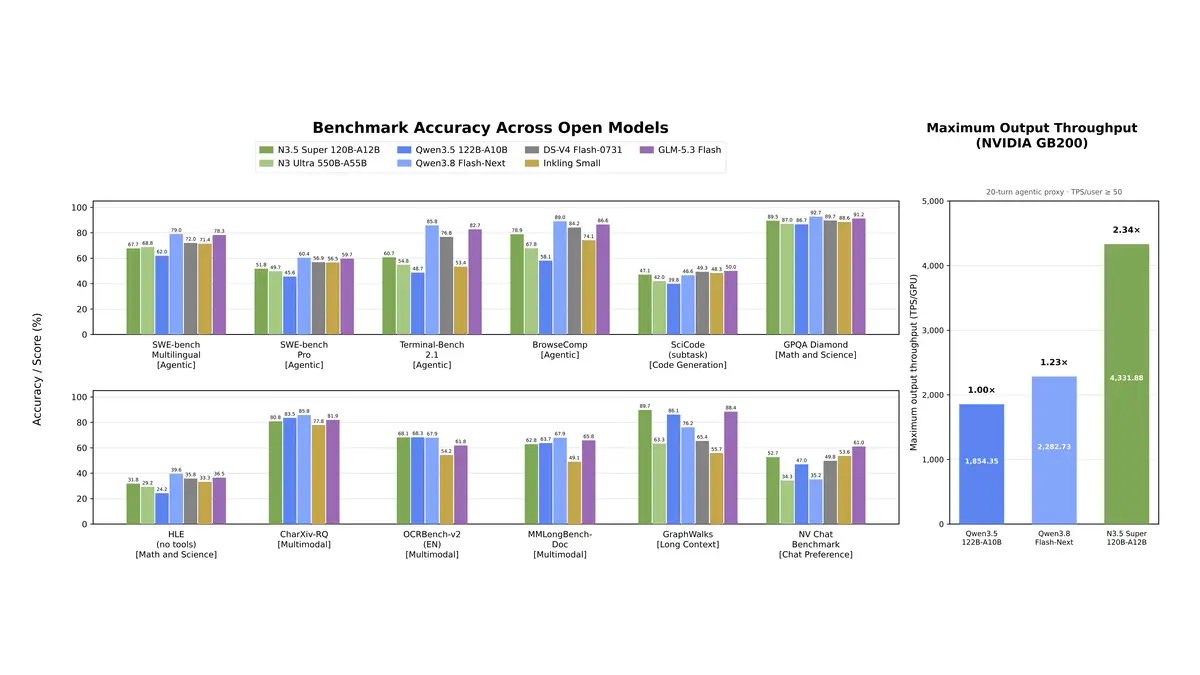
モデルカード冒頭の比較グラフは、Nemotron 3.5 Super VLを6つのオープンモデル(前世代のNemotron 3 Ultra 550B、Qwen3.5 122B、Qwen3.8 Flash-Next、DeepSeek V4 Flash、Inkling Small、GLM-5.3 Flash)と12項目で並べている。筆者がグラフの数字を1つずつ数えたところ、Nemotron 3.5 Super VLが一番高いのはGraphWalks(長い文脈の推論)の89.7だけだった。
| 項目 | Nemotron 3.5 Super VL | その項目の最高値 |
|---|---|---|
| SWE-bench Pro | 51.8 | 60.4(Qwen3.8 Flash-Next) |
| Terminal-Bench 2.1 | 60.7 | 85.8(Qwen3.8 Flash-Next) |
| BrowseComp | 78.9 | 89.0(Qwen3.8 Flash-Next) |
| GPQA Diamond | 89.5 | 92.7(Qwen3.8 Flash-Next) |
| HLE(ツールなし) | 31.8 | 39.6(Qwen3.8 Flash-Next) |
| CharXiv-RQ(図表の読解) | 80.8 | 85.8(Qwen3.8 Flash-Next) |
| OCRBench v2(英語) | 68.1 | 68.3(Qwen3.5 122B) |
| GraphWalks(長い文脈) | 89.7 | 89.7(本モデル) |
(グラフの12項目のうち8項目を抜粋。値はNVIDIAの公式グラフから読み取った)
一方で、前世代のNemotron 3 Ultra(550B・有効55B)と比べると伸びている。技術報告書は、SWE-bench Proの51.78%について「動くパラメータが約4.6分の1なのにNemotron 3 Ultraを上回った」と書く。グラフでもUltraは49.7だ。
なお、Terminal-Bench 2.1は資料によって数字が違う。グラフは60.7だが、モデルカードの表ではBF16版が66.70、NVFP4版が60.80になっている。グラフの値はNVFP4版の数字に近い。
NVIDIAが前に出しているのは「速さ」
比較グラフの右端には、点数ではなくスループットの棒グラフが置かれている。GB200 1枚あたりの最大出力スループット(20往復のエージェント作業を模した条件・1人あたり毎秒50トークン以上を保つ設定)は次のとおり。
| モデル | 出力トークン/秒/GPU | Qwen3.5を1とした倍率 |
|---|---|---|
| Qwen3.5 122B-A10B | 1,854.35 | 1.00 |
| Qwen3.8 Flash-Next | 2,282.73 | 1.23 |
| Nemotron 3.5 Super VL | 4,331.88 | 2.34 |
技術報告書の要旨も、Qwen3.5の2.34倍、Qwen3.8 Flash-Nextの1.90倍と書いている(1.90倍はグラフの数字を割り算しても同じ値になる)。要旨はさらに、推論の最適化でGB200 1枚あたり最大毎秒4,856トークン(1人あたり毎秒50トークン以上を保ったまま)に達したとも書いている。グラフの4,331.88とは別の数字で、条件の違いは要旨からは読み取れない。4bitのNVFP4版はBF16版の2.43倍のスループットで、精度はBF16版に対して中央値で99.62%を保ったという。モデルカードの表でも、両者の差は多くの項目で1ポイント未満に収まっている(SWE-bench ProはBF16が51.78、NVFP4が51.30)。
点数ではQwen3.8 Flash-Nextが多くの項目で上にいる。それでも同じGPUでより多くの処理を回せる、というのがNVIDIAの打ち出し方だ。GPUを売る会社のモデルらしい比べ方とも言える(ここは筆者の見方)。
コーディングの点数はハーネスで変わる
モデルカードには、同じモデルを6つのコーディングエージェント(ハーネス)で動かした結果も載っている。各ハーネスのシステムプロンプトと標準設定は変えずに測ったという。
| ハーネス | SWE-Bench Pro(731問・2回) | Terminal-Bench 2.1(89問・3回) |
|---|---|---|
| Claude Code(v2.1.126) | 49.45% | 59.55% |
| Codex(v0.144.6) | 47.26% | 61.80% |
| Hermes(v0.18.2) | 47.20% | 61.42% |
| Mini-SWE-agent(v2.4.5) | 47.40% | 54.68% |
| Pi(v0.80.10) | 46.92% | 48.31% |
| OpenCode(v1.17.8) | 41.04% | 55.06% |
SWE-Bench ProではClaude Code、Terminal-Bench 2.1ではCodexが一番で、同じモデルでも最大で13ポイント余りの差がついた。SWE-Bench Proは、gitの履歴を消したうえで「ずるやネット検索をしない」という指示を足して測ったと注記されている。技術報告書の要旨は、ソフトウェア開発のデータでの追加学習によって、ハーネスを変えたときの性能の安定性も上がったと説明している。
学習には他社のオープンモデルの出力も使ったと明記
モデルカードの学習データの節には、後学習のデータを作るのに使った他社モデルの名前が並ぶ。
| 用途 | モデルカードに書かれたモデル |
|---|---|
| 数学・理系の解答 | Kimi K3 |
| 数学の証明 | DeepSeek V4 Pro |
| 競技プログラミング | GLM-5.2 |
| 画像まわりの合成データ | Qwen3.5・Kimi |
| 会話データの更新 | Qwen・Kimi・Gemma |
| 長い文書の翻訳 | DeepSeek V4 Flash |
土台のモデルはNemotron 3 Super Baseで、そこへ上位のNemotron 3 Ultra Baseから1兆トークン分の蒸留をかけた。さらにインドの言語で1,000億トークンの継続事前学習をして、100万トークンへの文脈拡張、ソフトウェア開発データでの追加学習を重ねたとモデルカードは説明している。NVIDIAはNemotronを「重み・学習データ・学習手順を公開するモデル群」と位置づけており、技術報告書も事前学習と後学習のデータセットを公開するとしている。
日本語については、後学習で英語のほかにフランス語・ドイツ語・イタリア語・日本語・スペイン語・中国語に重点を置いたと書かれている。ただし評価表にあるのは多言語のMMLU-ProX(BF16版76.91)や翻訳のWMT24++(同84.80)で、日本語だけを取り出した点数は載っていない。
筆者のMac(メモリ64GB)で動くか:入るのは1〜2bit版まで
量子化版を配るUnslothの案内によると、GGUF版の大きさは1bitの46.1GBから8bitの132GBまで。最も小さい版でもメモリ64GB以上、4bit版(86.9GB)は128GB程度が目安だという。12Bしか動かないモデルでも、重みは全部メモリに載せる必要があるためだ。
この記事を書いている筆者の作業機はApple M5 Max・メモリ64GBで、この目安に当てはめると載るのは1bit版(46.1GB)か2bit版の一部(51.1GB)までになる。今回は実際に動かしてはいない。NVIDIAのモデルカードがローカル実行の例に挙げるのも、DGX Spark(Unslothによればメモリ128GB)、RTX Spark、RTX Pro 6000だ。モデルカードは想定用途を「NVIDIAのデータセンター向けシステムとDGX Spark」と書いており、気軽に手元で試せる大きさではない。
ライセンスと入手先
ライセンスのOpenMDW-1.1は、モデル一式を無償で「制限なく」扱うことを認める。条件は、配布するときにライセンス文と著作権表示を残すこと、そしてモデルが特許や著作権を侵害していると訴えた場合に権利が終わること。生成した出力の利用・改変・共有には制限を設けていない。モデルカードも「商用・非商用の利用に使える」と明記している。
入手先はHugging FaceのNVFP4版・BF16版・Base版のほか、投機的デコード用の小さな下書きモデル「LiLiCorr」も別に公開されている。企業向けにはNVIDIA NIMのコンテナがNGCカタログに載っている。
この記事で確かめられなかったこと
- NVIDIAの公式ブログ(blogs.nvidia.com・developer.nvidia.com/blog)とHugging Faceのブログには、日本時間10月16日0時の時点で、このモデルの発表記事が見当たらなかった。発表記事が出たら追記する
- 10月13日のNVIDIAブログで「10月15日公開」とされた同じ3.5世代の「Nemotron 3.5 Bolt 74B」(関連記事)は、本記事の執筆時点ではHugging Faceでnvidiaのモデルを「Nemotron-3.5」で検索しても出てこなかった
- 比較グラフの数値は画像から読み取ったもので、元の表(技術報告書のTable 10)とは照合していない
- 本記事は続報があり次第更新します
この記事でよく聞かれること
- Nemotron 3.5 Super VLとは何ですか?
- NVIDIAが2026年10月15日にHugging Faceで公開した視覚言語モデルです。総パラメータは120Bで、1トークンごとに動くのは12B。文字・画像・動画(mp4・最長2分)を入力でき、出力は文字です。文脈は最大100万トークンで、思考のオン・オフを切り替えられるとモデルカードに書かれています。
- 無料で使えますか?商用利用はできますか?
- 重みはHugging Faceで公開されており、モデルカードは「商用・非商用の利用に使える」としています。ライセンスはOpenMDW-1.1で、配布するときにライセンス文と著作権表示を残すこと、特許訴訟を起こすと権利が終わることなどが条件です。生成した出力の利用には制限を設けていません。
- 手元のPCやMacで動きますか?
- 量子化版を配るUnslothの案内では、最も小さい1bit版(46.1GB)でもメモリ64GB以上、4bit版(86.9GB)は128GB程度が目安です。NVIDIAのモデルカードが挙げる動作環境はDGX Spark 1台、H200 1台、H100 2台、GB200 1台です。
- 日本語に対応していますか?
- モデルカードによると、後学習では英語に加えてフランス語・ドイツ語・イタリア語・日本語・スペイン語・中国語に重点を置き、多言語の推論と翻訳の課題で学習しました。ただしモデルカードの評価表に、日本語だけを取り出した点数は載っていません。
出典・参照資料
- 一次資料NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 モデルカード — NVIDIA(Hugging Face) ↗
- 一次資料NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16 モデルカード — NVIDIA(Hugging Face) ↗
- 一次資料Nemotron 3.5 Super and Lightning 技術報告書(2026-10-14付)— NVIDIA ↗
- 一次資料OpenMDW License Agreement 1.1 ↗
- 一次資料Nemotron 3.5 Super VL NIM — NVIDIA NGC カタログ ↗
- 二次資料NVIDIA Nemotron 3.5 Super VL: Run Locally Guide — Unsloth ↗

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
NVIDIA、RTX Spark(スパーク)搭載PCの10月16日発売を前に「Nemotron 3.5 Bolt 74B」を15日公開へ PAIR(ペア)は正式版、Broadcast 2.3は配布中
NVIDIA、RTX Spark(スパーク)搭載PCの10月16日発売を前に「Nemotron 3.5 Bolt 74B」を15日公開へPAIR(ペア)は正式版、Broadcast 2.3は配布中
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開 LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
 動画
ドイツ製AI「Kolibri」を手元のMacで動かした 78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
ドイツ製AI「Kolibri」を手元のMacで動かした78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
GPU(ジーピーユー)とは 画面を描くために生まれ、いまはAIの計算も担うチップ。CPUとの違い、AIでGPUが使われる理由、NPUとの違い【2026年10月版】
GPU(ジーピーユー)とは画面を描くために生まれ、いまはAIの計算も担うチップ。CPUとの違い、AIでGPUが使われる理由、NPUとの違い【2026年10月版】
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
NVIDIA「Magpie TTS Multilingual」 3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
NVIDIA「Magpie TTS Multilingual」3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍