
画像認識・コンピュータビジョンの記事
「画像認識・コンピュータビジョン」に関連するAIニュースと解説、14本。新しい順に並べています。
画像認識・コンピュータビジョン の記事:14件
Google「EmbeddingGemma 2」公開 文字・画像・動画・音声を1つのベクトルにする7.4億パラメータのオープンモデル、手元のMacで日本語の検索を試した
Google「EmbeddingGemma 2」公開文字・画像・動画・音声を1つのベクトルにする7.4億パラメータのオープンモデル、手元のMacで日本語の検索を試した
モデル
H Company「NeoMME」 画像パッチとテキストを1つの双方向Transformerで処理する260M・800Mの多言語マルチモーダルエンコーダ(Apache 2.0)。事前学習の視覚塔も言語モデルも使わずマスク離散拡散でゼロから学習。文書検索版はViDoRe v3で260Mが0.523(ColQwen2.5の14分の1のパラメータ)、索引は1ページ1.5MB→6kB(255分の1)
H Company「NeoMME」画像パッチとテキストを1つの双方向Transformerで処理する260M・800Mの多言語マルチモーダルエンコーダ(Apache 2.0)。事前学習の視覚塔も言語モデルも使わずマスク離散拡散でゼロから学習。文書検索版はViDoRe v3で260Mが0.523(ColQwen2.5の14分の1のパラメータ)、索引は1ページ1.5MB→6kB(255分の1)
検証
Google「LiteRT.js」 .tfliteモデルをブラウザで動かすJavaScript版LiteRT。TensorFlow.jsのJSカーネルでなくネイティブのランタイムをWebAssemblyで提供し、CPU(XNNPACK)・GPU(WebGPU)・NPU(WebNN)を使い分け。他のWebランタイム比で最大3倍、CPU比でGPU/NPUは5〜60倍
Google「LiteRT.js」.tfliteモデルをブラウザで動かすJavaScript版LiteRT。TensorFlow.jsのJSカーネルでなくネイティブのランタイムをWebAssemblyで提供し、CPU(XNNPACK)・GPU(WebGPU)・NPU(WebNN)を使い分け。他のWebランタイム比で最大3倍、CPU比でGPU/NPUは5〜60倍
検証
Gemini「エージェント型の動画理解」 毎秒1フレームで丸ごと読む代わりに、必要な区間だけ探して見直す。トークン最大88%減・費用最大66%減・精度最大7%向上(Google DeepMind、3.7 Flash・3.6 Flash・3.5 Flash-Lite)。APIの設定を"agentic"にするだけ、追加料金なし。Geminiアプリと「Ask YouTube」にも順次
Gemini「エージェント型の動画理解」毎秒1フレームで丸ごと読む代わりに、必要な区間だけ探して見直す。トークン最大88%減・費用最大66%減・精度最大7%向上(Google DeepMind、3.7 Flash・3.6 Flash・3.5 Flash-Lite)。APIの設定を"agentic"にするだけ、追加料金なし。Geminiアプリと「Ask YouTube」にも順次
検証
Tencentが文書解析AI「WeVisDoc」をオープンウェイト公開 OmniDocBench v1.6で95.38、end-to-end型パーサーの比較で首位と主張
Tencentが文書解析AI「WeVisDoc」をオープンウェイト公開OmniDocBench v1.6で95.38、end-to-end型パーサーの比較で首位と主張
モデル
Qwen3.8-27Bが公開 1枚のGPUに収まる密モデルで動画も読める、ダウンロード330万回・likes 1.3万で中国勢8月最多
Qwen3.8-27Bが公開1枚のGPUに収まる密モデルで動画も読める、ダウンロード330万回・likes 1.3万で中国勢8月最多
モデル
手話をテキストに変えるAI「SL2T」 Google DeepMindがPixel 11に載せた仕組み
手話をテキストに変えるAI「SL2T」Google DeepMindがPixel 11に載せた仕組み
プロダクト
Tencentが「画面を見て操作する」オープンウェイトAIエージェントを公開 OSWorld-Verifiedで77.0点、手元で動かせるcomputer useの選択肢
Tencentが「画面を見て操作する」オープンウェイトAIエージェントを公開OSWorld-Verifiedで77.0点、手元で動かせるcomputer useの選択肢
モデル
AIが2000年前の炭化した巻物を読む Vesuvius Challengeは何をどこまで解読したか
AIが2000年前の炭化した巻物を読むVesuvius Challengeは何をどこまで解読したか
研究
「空間知能」とは何か Fei-Fei Liが掲げるAIの次のフロンティア
「空間知能」とは何かFei-Fei Liが掲げるAIの次のフロンティア
研究
派手な発表の裏で静かに公開された中国勢3モデル 文書検索・マルチモーダル埋め込み・動画編集パイプライン【2026年8月】
派手な発表の裏で静かに公開された中国勢3モデル文書検索・マルチモーダル埋め込み・動画編集パイプライン【2026年8月】
モデル
動画生成AIの『記憶』をKVキャッシュの外に出す Alaya-EVOKEはH200で1.5秒分の映像を2.11秒で作り続ける
動画生成AIの『記憶』をKVキャッシュの外に出すAlaya-EVOKEはH200で1.5秒分の映像を2.11秒で作り続ける
研究
動画生成AIの採点に「なぜそのスコアか」を残す HarnessEval-Wはサブエージェントを分業させて評価の根拠を証拠の木にする
動画生成AIの採点に「なぜそのスコアか」を残すHarnessEval-Wはサブエージェントを分業させて評価の根拠を証拠の木にする
研究
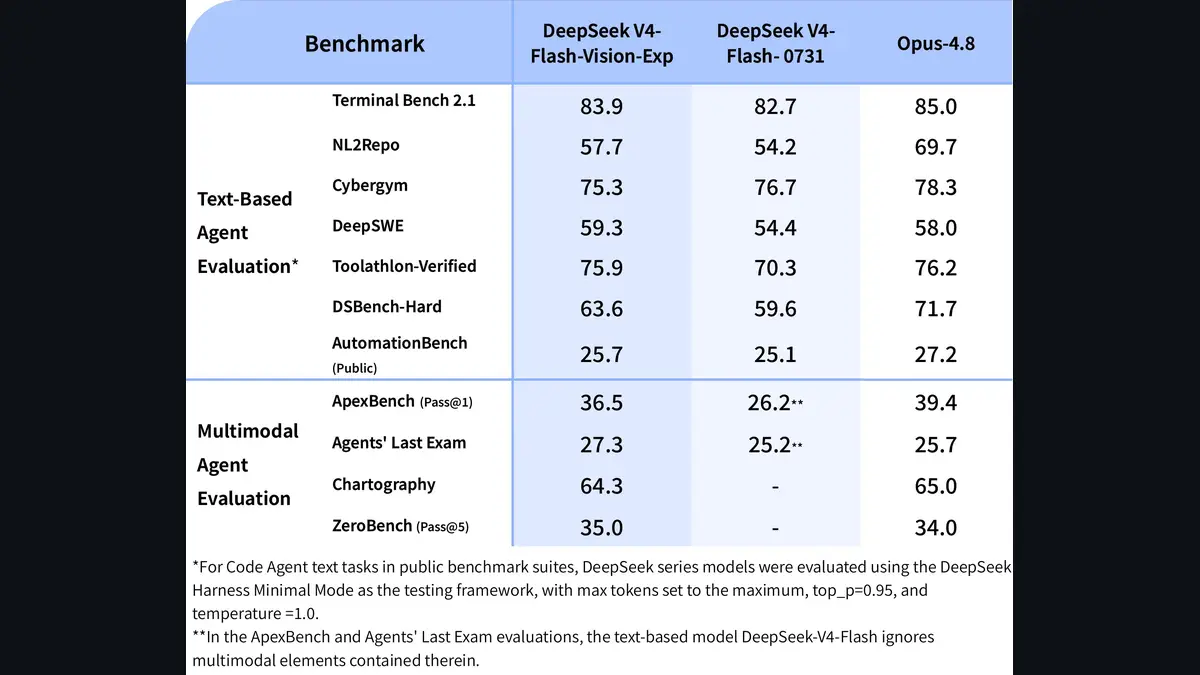
DeepSeekがAPIの画像入力に初対応 V4-Flash-Vision-Exp公開、1画像最大384トークンで料金はFlash据え置き
DeepSeekがAPIの画像入力に初対応V4-Flash-Vision-Exp公開、1画像最大384トークンで料金はFlash据え置き
モデル