判定だけを返すAI「Jev」が1.14に画像入力・位置を返す「Box」・26万トークンの長文を試験機能で追加、価格は据え置き
TypeSafe AI(タイプセーフ)は2026年10月14日(米国時間)、文章を書かずに判定だけを返すモデル「Jev」の新版1.14を公開した。同時に、画像の入力、画像のどこに対象があるかを返す新しい質問の型「Box」、26.2万トークンまでの長文を、APIのヘッダーで有効にする試験機能として出した。同社は画像とBoxを「本番に使える水準ではない」と明記している。価格は入力100万トークン0.042ドル・出力無料のまま。同社の社内測定では1.14が60.0点、1.13が58.9点で、比べた相手はオープンウェイトのモデルだけだ。
目次
2026年10月15日午前・日本時間時点の情報です。米TypeSafe AI(タイプセーフ)は10月14日(米国時間)、公式ブログで判定専用モデル「Jev」の新版1.14を公開した。Jevは文章を生成せず、決めておいた質問に「はい/いいえ」「選択肢のどれか」「点数」で答えるモデルで、9月15日の発表時の中身は前回の記事にまとめた。今回のモデル本体の変更について同社は「小さな改良」と書き、いちばん伸びると見込むのは英語以外の言語だとしている。あわせて、画像の入力、画像のどこに対象があるかを返す新しい質問の型「Box(ボックス)」、26.2万トークンまでの長文の3つを、APIのヘッダーで有効にする試験機能として出した。価格は変わらない。
3行まとめ
- モデルはJev 1.14(
jev-1.14.0)。今はjev-previewで呼び、既定のjev-latestは「1週間後」に1.14へ切り替わると同社ブログ。価格は入力100万トークン0.042ドル・出力無料で1.13と同じ。- 試験機能は3つ:画像入力(1.13でも使える)、画像内の位置を四隅の割合で返す「Box」(1.14だけ)、既定6.4万→26.2万トークンの長文(両方で使える)。画像とBoxは「本番に使える水準ではない」と同社が明記。
- 同社の社内測定では総合60.0点(1.13は58.9点)、確率のずれ(較正誤差)は1.6(1.13は1.8)。比べた相手はオープンウェイトのモデルだけで、同社自身が「自分たちのモデルに有利に偏っている可能性が高い」と添えている。
1.14で何が変わったか
公式ドキュメントのモデル一覧と、ブログの記述をまとめると次のようになる(2026年10月15日午前に取得)。
| 項目 | 内容 | 出どころ |
|---|---|---|
| モデルID | jev-1.14.0(10月14日から提供) |
ドキュメント「Models」 |
| 呼び方 | jev-preview が1.14を指す。jev-latest はまだ1.13を指し、「1週間後」に1.14へ切り替え |
ドキュメント・ブログ |
| 価格 | 入力100万トークン0.042ドル・出力無料(1.13と同じ) | ドキュメント「Models」 |
| 既定のコンテキスト長 | 1リクエスト64k(約6.4万)トークン、1問あたり32kトークン(1.13と同じ) | ドキュメント「Models」 |
| 画像入力(試験) | PNG/JPEG。1.13と1.14の両方で使える | ドキュメント「Images」 |
| Box(試験) | 画像内の対象の位置を返す新しい型。1.14だけ | ドキュメント「Box」 |
| 長文(試験) | ヘッダーを付けると両方の上限が262k(約26.2万)トークン。1.13でも使える | ドキュメント「Models」 |
| 1.13の扱い | 当面は提供を続け、廃止の60日前に告知する予定。1.14は30日前。廃止の方針は別に公表する予定 | ブログ |
| 問い合わせの提供(任意) | 利用者が選べば、自分の問い合わせを弱点探しに使ってもらえる。学習には使わないと同社 | ブログ |
モデル本体の改良について、ブログはこう書いている。
Not meant to be flashy but instead be small, subtle improvements to everything. Most things should be a tiny bit better, but we expect the largest gain in multi-lingual support.
(派手さを狙ったものではなく、あらゆる面での小さく控えめな改良だ。ほとんどのことが少しずつ良くなっているはずだが、最も大きな伸びは多言語対応で見込んでいる。)
試験機能は、どれもリクエストに専用のヘッダーを付けた時だけ有効になる。画像とBoxは TypeSafe-Danger-Zone-Images: true、長文は TypeSafe-Danger-Zone-Long-Context: true だ。同社はこれを「danger zone(危険地帯)」と呼び、ブログで線引きの理由を書いている。
But as a warning, we think there is still way too much jaggedness for us to vouch for these for production use cases!
(ただし警告として、これらにはまだ得意・不得意のむらが大きすぎて、本番の用途に使えると私たちが保証することはできないと考えている。)
画像は1.13の時点で読めていた
画像入力について、ブログは次のように明かしている。
Surprise: the Jev you all know and love (jev-1.13.0) was multimodal all along!
(実は、みんなが知っているJev(jev-1.13.0)は最初からマルチモーダルだった。)
ドキュメントによると、画像は3つの場所に置ける。判定の材料になる「state」、質問文の中、選択肢の基準の中だ。ドキュメントの図では、玄関カメラの写真をstateに、社員証の写真をはい/いいえの質問文に、親指を立てた写真を選択肢「thumbs_up」の基準に置いた例を示している。画像はリクエストの中で一度だけ送り、置きたい場所から名前で参照する仕組みになっている。ただし、参照するたびに画像がもう一度読み込まれて上限に数えられるので、複数の質問で同じ画像を使う時はstateに1回だけ置くよう勧めている。
制限はドキュメントに数字で書かれている。
| 制限 | 値 |
|---|---|
| 形式 | PNGかJPEGの静止画だけ(動くPNGは不可。GIF・WebP・HEICは変換が必要) |
| 1枚の大きさ | 16MiBまで |
| リクエスト全体 | 32MiBまで(画像を参照ごとに展開した後の大きさも32MiBまで) |
| 推奨の大きさ | 長い辺を1568ピクセル以下に縮めてから送る |
| 上限を超えた時 | 自動で縮めずに拒否。1枚でも拒否されるとリクエスト全体が失敗する |
画像の正確さについて、ブログは先に断っている。
As a warning, all models (Jev included) perform worse on multimodality over pure text.
(警告として、どのモデルも(Jevも含めて)、文字だけの時より画像を含む時の方が性能が落ちる。)
同社の勧めは、質問をできるだけ単純な問いに分けることだ。
Box──「はい/いいえ」以外を返す最初の型
Boxは、画像の中で何かがどこにあるかを答える型だ。ドキュメントの例は「カウンターの上のマグカップ」「スキャンした書類の署名」「玄関にいる人」。答えは対象を囲む最小の長方形の四辺で、左右は画像の幅、上下は画像の高さに対する割合(左上が起点)で返る。割合なので、同じ答えをどの大きさの画像にも当てはめられる。Boxが使えるのは1.14だけで、モデル名に jev-preview か jev-1.14.0 を指定する。
ブログはBoxの位置づけをこう書く。
It’s our first type that’s not purely meant for smart-if statements, and is a preview for our explorations beyond simple decisions into what else System One Models can support.
(これは、賢いif文のためだけではない最初の型で、単純な判定を超えてSystem One Modelが何に対応できるかを探る取り組みの予告でもある。)
これまでのJevの型(Noul・Choice・Score)は、どれもプログラムの分岐に使う判定を返すものだった。Boxは初めて「場所」を返す。ドキュメントには使い方の注意もあり、大きな画像の中の数十ピクセルほどの小さな対象は見落とすことがあるので、先に画像をタイルに分けてChoiceでどのタイルにあるかを選ばせ、そのタイルにBoxを聞く、という2段階を勧めている。
長文は26.2万トークンまで。ただし遅く、不正確になる
既定のコンテキスト長は1.13と同じ6.4万トークンのままで、ヘッダーを付けたリクエストだけ26.2万トークンまで広がる。料金のトークン単価は変わらない。ブログによると、Jevはもともと本番で開放していたより長い文脈を扱えたが、長い文脈では信頼性が落ちるため意図して制限していた。ドキュメントは使いどころを絞るよう書いている。
It is slower and less accurate than staying within the default limits, so turn it on only for requests that need it.
(既定の上限の範囲にとどまるより遅く、正確さも落ちるので、必要なリクエストにだけ有効にしてほしい。)
社内測定の点数──同社が「信じすぎるな」と添えた3枚の図
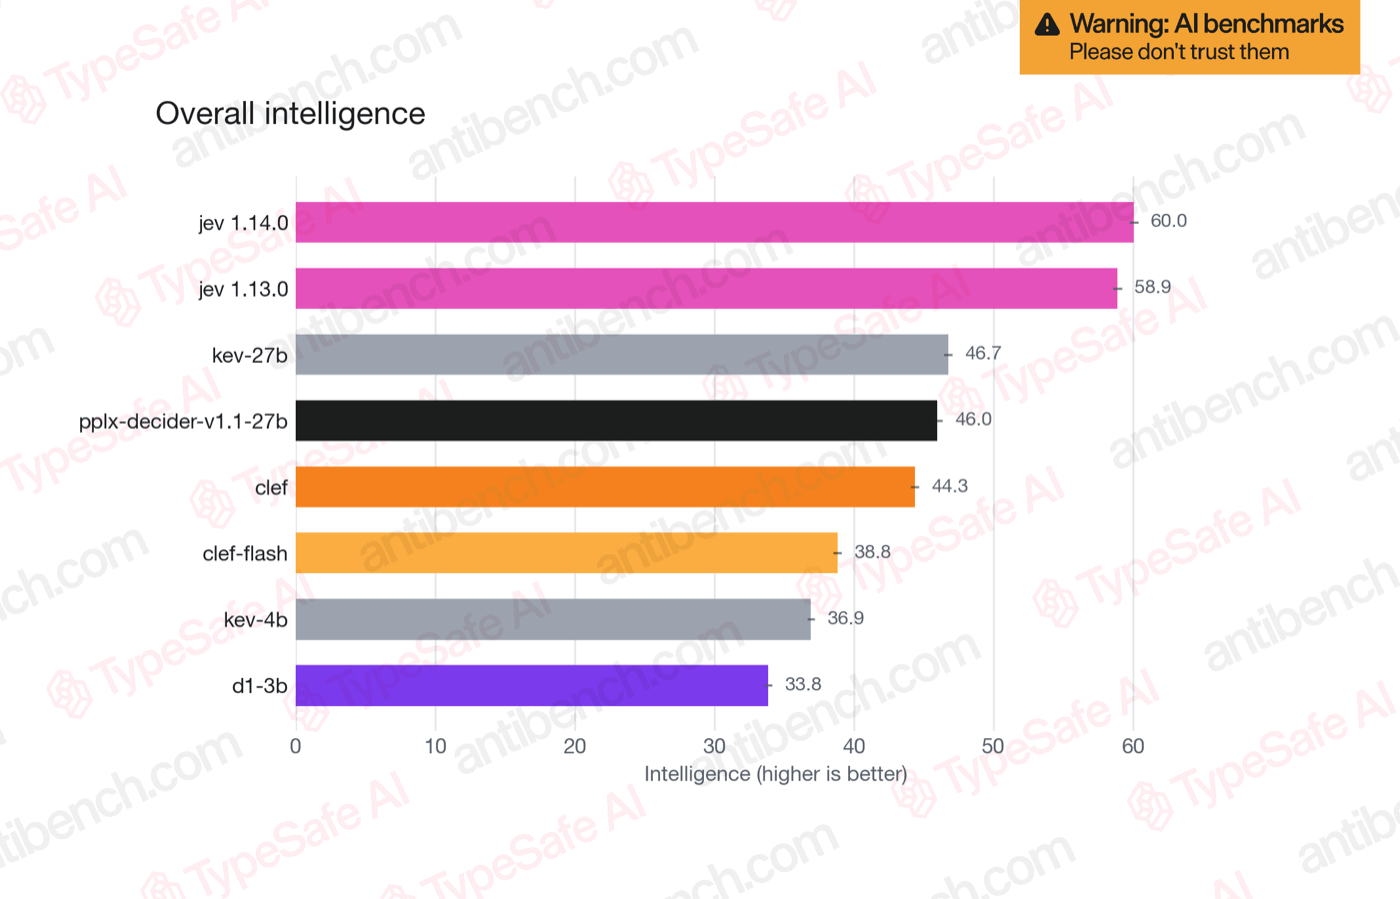
同社は「we dislike public benchmarks(私たちは公開ベンチマークが好きではない)」と書いたうえで、社内の測り方で出した点数を今回のブログに3枚の図で載せた。総合の点数(高いほど良い)は、1.14が60.0、1.13が58.9。同じ図の他のモデルは、kev-27b 46.7、pplx-decider-v1.1-27b 46.0、clef 44.3、clef-flash 38.8、kev-4b 36.9、d1-3b 33.8だ(図の数字を目視で転記)。
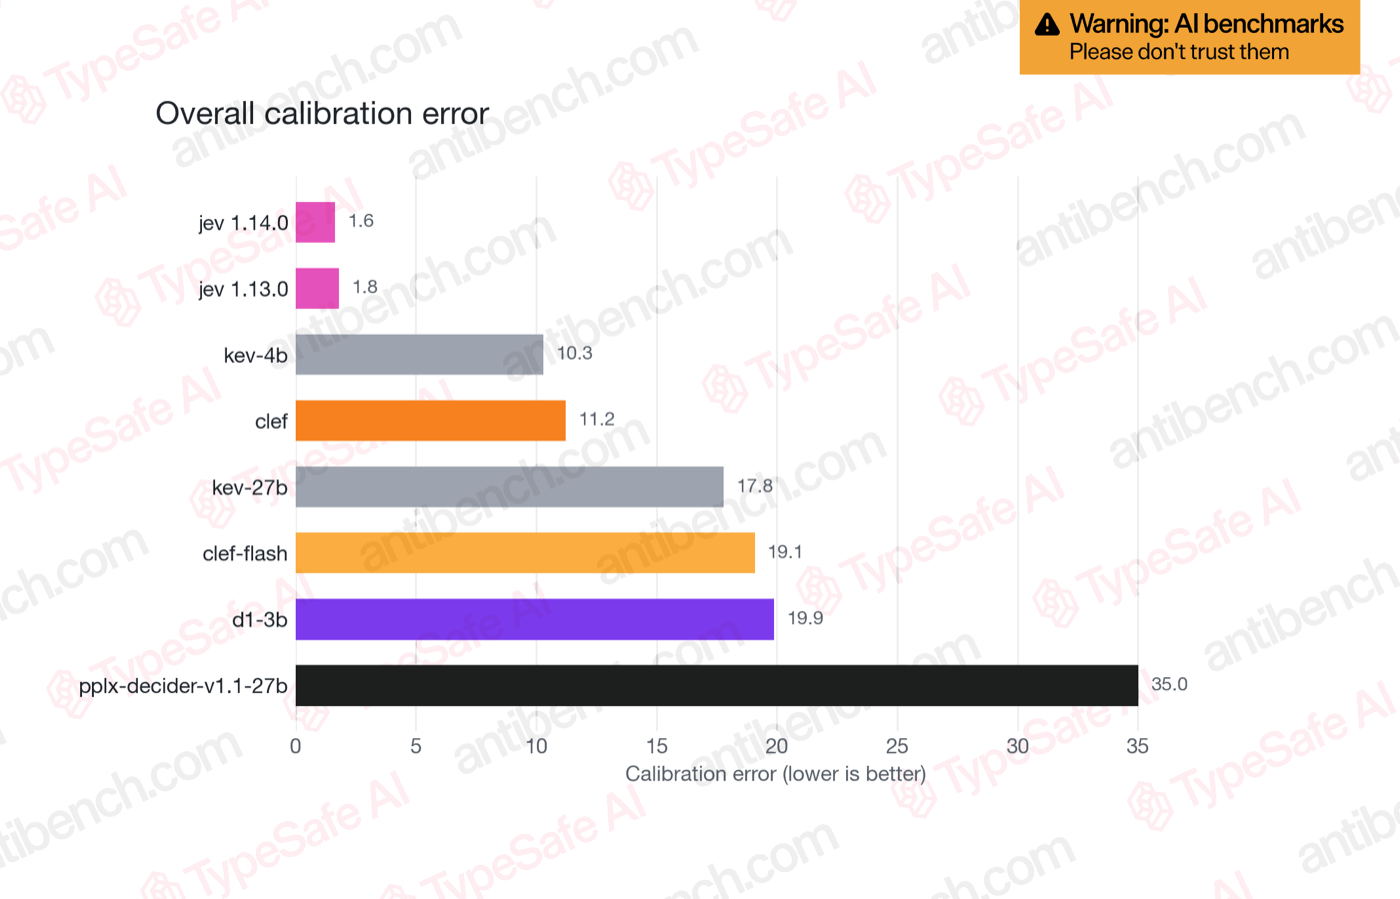
2枚目は較正誤差(低いほど良い)。較正誤差は一般に、モデルが出した確率と実際の正解率のずれを表す指標で、たとえば「8割の確率ではい」と出した判定が本当に8割当たるなら、ずれは小さい。同社はJevを、出す確率と実際の正解率が合うように訓練していると説明している。図の数字は、1.14が1.6、1.13が1.8。他のモデルは10.3から35.0の間だった。3枚目の「点数と費用」の図では、横軸が100万回の問い合わせあたりの費用(対数目盛り)で、1.14と1.13は同じ位置、目盛りの100ドルと200ドルの間に並んでいる。
図のどれにも「Warning: AI benchmarks」「Please don't trust them」(警告:AIのベンチマーク/信じないでください)という2行の札が付いている。ブログは比べた相手について、こう書いている。
We’re including only open weight models because we guard our validation set very closely and are spooked out about the data policies of our model providers.
(オープンウェイトのモデルだけを入れている。検証用のデータを厳重に守っていて、モデル提供各社のデータの扱いが怖いからだ。)
This is likely biased towards our models. Feel free to ignore our model, and instead focus on the relative ranking of open source models.
(これは私たちのモデルに有利に偏っている可能性が高い。私たちのモデルは無視して、オープンソースのモデル同士の順位を見てもらって構わない。)
つまり、9月の評価のようにGPTやClaudeと並べた数字は、今回は出ていない。1.13から1.14への伸びは、同社の物差しで1.1点だ。
日本語で使う場合に関わること
ブログは1.14で最も伸びるのは多言語対応だと見込んでいる。一方で、10月15日午前に取得したモデル一覧のページは、言語について1.13の時と同じ注意を載せたままだ。
English is the primary training language and where accuracy is currently best. Other languages, including CJK scripts, are handled but not equally well; test on your own content before relying on Jev for a non-English workload, and pay close attention to Confidence when routing.
(英語が主な学習言語で、現時点で正確さが最も高い。CJK(中国語・日本語・韓国語)を含む他の言語も扱えるが、同じ水準ではない。英語以外の業務でJevに頼る前に自分のデータで試し、振り分けの際は確信度に注意してほしい。)
ブログの測定の節に載った3枚の図(総合点・点数と費用・較正誤差)はどれも全体の数字で、言語別の内訳は無い。ブログ本文で言語に触れているのも、上の「多言語対応」の一文だけだ。日本語でどれだけ良くなったかは、今のところ自分のデータで試すしかない。
公式ページを読み比べて見つけた食い違い
筆者は9月16日の記事と動画のあと、9月19日に公式ドキュメントを全ページ読んだ。その時点のメモには、入力は「テキストのみ」とある。今回、同じドキュメントを読み直すと、次の2点が揃っていなかった(いずれも10月15日午前に取得したページ)。
- モデル一覧の表は、1.14と1.13の両方とも入力を「Text」と書いている。一方で画像のページには「Jev 1.13 and Jev 1.14 both accept images.(Jev 1.13と1.14はどちらも画像を受け付ける)」とある。画像は試験機能なので表には載せていない、という整理なのかもしれないが、表にはその説明は無い。
- 1.13には既知の弱点を並べたページ(Jev 1.13 jaggedness)があるが、同じ形のアドレスで1.14を開くと404だった。1.14の弱点ページは、取得した時点ではまだ無かった。
「1.13は最初から画像を読めた」というブログの一文は、9月の時点では外から見えなかった機能が、モデルの中にはすでにあったことを意味する。9月19日のメモと今回の画像のページを並べると、画像に限っては、変わったのはモデルではなく、利用者に開けた範囲だということになる。
この発表で分からないこと
- 点数はすべて同社の社内測定。同社自身が「信じすぎるな」と書き、比べた相手もオープンウェイトのモデルに限っている。GPTやClaudeとの比較、第三者による測定は、本記事が確認したブログとドキュメントの範囲には無い。
- 画像とBoxの正確さ:今回取得したブログ、画像のページ、Boxのページには、画像やBoxの正確さを示す数字は載っていない。同社はドキュメントで「リクエストの形式、答え、制限はリリースの間に変わることがあり、正確さもモデルの更新で変わる」と書いている。
jev-latestの切り替え日:ブログは「in a week(1週間後)」とだけ書いており、10月14日から数えると10月21日ごろになる(当方の計算)。正確な日時は書かれていない。- 廃止の方針:1.13を正式に廃止する60日前に告知する予定で、その前に廃止の方針を公表するとブログにある。方針そのものはまだ出ていない。
- 提供の範囲:ブログのページ説明には今も「Try our first System One Model, Jev, in early access.(最初のSystem One ModelであるJevを早期アクセスで試せる)」とあり、今回のブログの本文には、一般提供や早期アクセスの範囲についての記述は無い(10月15日午前に取得した本文で確認)。
出典と時点
- 公式ブログ「Jev: For the builders AND dreamers」(2026年10月14日)、ドキュメントの「Models」「Images」「Box」「Jev 1.13 jaggedness」は、2026年10月15日午前(日本時間)に取得した内容に基づく
- 3枚の図の数字はブログの図を目視で転記した。図の作成者はTypeSafe AIで、比較対象のモデルの選び方も同社による
- 公式Xの投稿(10月15日10時2分・日本時間)は「1.14を10月14日の午後1時14分(米太平洋時間)に発表した」としている
- 日本語訳は筆者によるもので、原文が正本
- 前回の記事:ChatGPTともClaudeとも作りが違う新モデル「Jev」(9月16日・動画版あり)
本記事は、jev-latest の切り替えや、1.14の弱点ページ・廃止の方針が公開され次第更新します。
出典・参照資料
- 一次資料Jev: For the builders AND dreamers — TypeSafe AI Blog(2026-10-14) ↗
- 一次資料Models — TypeSafe Docs(モデルID・価格・コンテキスト長・エイリアス) ↗
- 一次資料Images — TypeSafe Docs(画像の送り方・制限) ↗
- 一次資料Box — TypeSafe Docs(新しい質問の型) ↗
- 一次資料TypeSafe AI公式X「we announced Jev 1.14 on 10.14 at 1:14pm PT」 ↗
- 一次資料Jev 1.13 jaggedness — TypeSafe Docs(1.13の既知の弱点) ↗

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
ChatGPTともClaudeとも作りが違う新モデル「Jev」 文章を書かず判定だけを返すTypeSafe AIの発表を、公式ブログと評価サイトの数字で読む
ChatGPTともClaudeとも作りが違う新モデル「Jev」文章を書かず判定だけを返すTypeSafe AIの発表を、公式ブログと評価サイトの数字で読む
 動画
ハルシネーションとは AIが事実と違うことをもっともらしく答える現象(幻覚)。例、起きる理由、使う人ができる確かめ方【2026年10月版】
ハルシネーションとはAIが事実と違うことをもっともらしく答える現象(幻覚)。例、起きる理由、使う人ができる確かめ方【2026年10月版】
ディープラーニングとは何か 機械学習・ニューラルネットワークとの関係を一次資料で整理する
ディープラーニングとは何か機械学習・ニューラルネットワークとの関係を一次資料で整理する
ニューラルネットワークとは何か 仕組みの基礎とAIモデル記事への入口
ニューラルネットワークとは何か仕組みの基礎とAIモデル記事への入口
Transformer(トランスフォーマー)とは 2017年の論文「Attention Is All You Need」が提案したニューラルネットの構造。Attentionの計算、BERT・GPT・ViTへの広がり、著者のその後、長い文脈での限界まで原文で読む
Transformer(トランスフォーマー)とは2017年の論文「Attention Is All You Need」が提案したニューラルネットの構造。Attentionの計算、BERT・GPT・ViTへの広がり、著者のその後、長い文脈での限界まで原文で読む
LM StudioがMLXエンジンを統一した理由 フォークされていた2つの実装を1つにするとフォロー応答が25倍速くなった
LM StudioがMLXエンジンを統一した理由フォークされていた2つの実装を1つにするとフォロー応答が25倍速くなった
 動画
AIは二度、資金を断たれてきた 76年の歴史を、繰り返された「冬」から読む
AIは二度、資金を断たれてきた76年の歴史を、繰り返された「冬」から読む