Transformer(トランスフォーマー)とは2017年の論文「Attention Is All You Need」が提案したニューラルネットの構造。Attentionの計算、BERT・GPT・ViTへの広がり、著者のその後、長い文脈での限界まで原文で読む
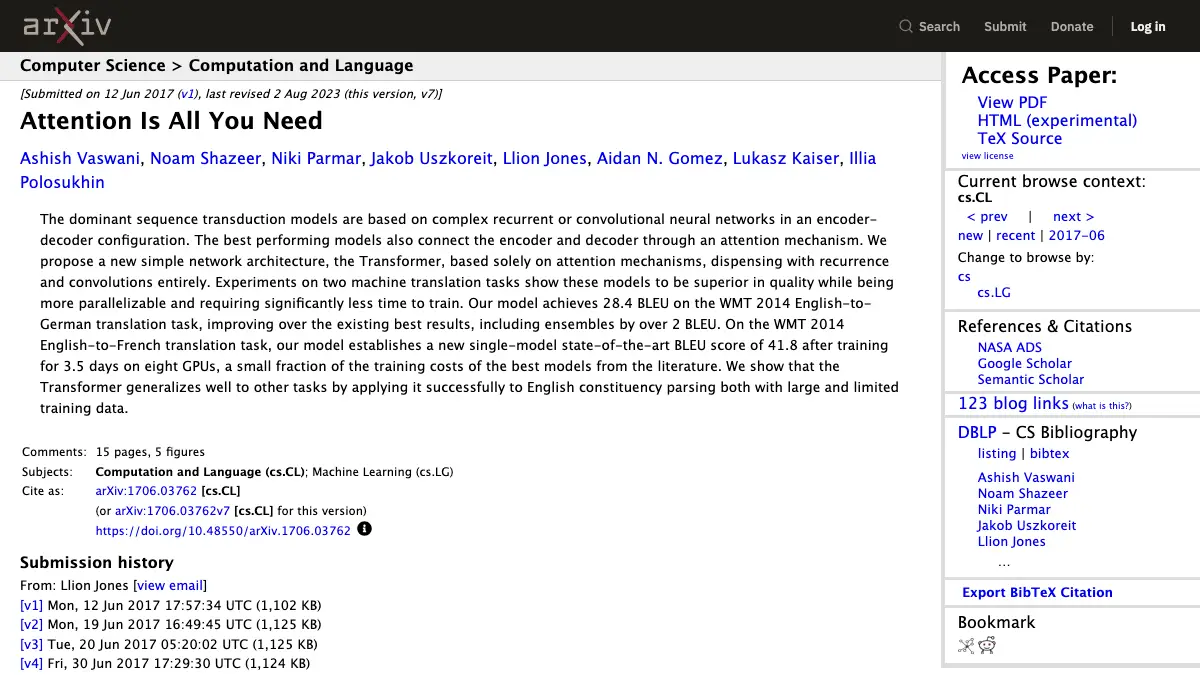
Transformerは、Google Brain・Google Researchで研究していた8人が2017年6月にarXivへ出した論文「Attention Is All You Need」(arXiv:1706.03762)が提案したニューラルネットの構造で、再帰も畳み込みも使わず、Attention(注意機構)だけで系列を処理する。論文の要旨は、英独翻訳で28.4 BLEU、英仏翻訳で41.8 BLEU(本文6.1節は41.0と書く)を出し、英仏の学習は8基のGPUで3.5日だったと書く。この記事は2026年10月2日にarXivの原文を取り直し、要旨の引用と訳、式1本で見るAttention、BERT・GPT-3・ViTの原論文、公式ページで確かめられた著者3人の現職、計算量が長さの2乗になる限界とその後の研究を順に整理する。
目次
2026年10月2日・日本時間時点の情報です。 Transformer(トランスフォーマー)は映画や玩具、電気の変圧器の名前でもあるが、AIの文脈では2017年の論文「Attention Is All You Need」が提案したニューラルネットの構造を指す。Mambaの論文(2023年12月)は要旨の冒頭で、基盤モデルが「almost universally」(ほぼ例外なく)この構造に基づくと書く。以下は、論文とBERT・GPT-3・Vision Transformer(ViT)の原論文をarXivから取り直し、書かれていることだけで答える。
3行まとめ
- Transformerは、Google Brain・Google Researchで研究していたAshish Vaswani氏ら8人(論文の表記)が2017年6月12日(UTC)にarXivへ出した論文が提案した構造。 要旨は再帰も畳み込みも使わずAttention機構だけに基づくと書き、英独翻訳で28.4 BLEU、英仏で41.8 BLEU(本文6.1節は41.0)、英仏の学習は8基のGPUで3.5日と書く。
- 中心の計算は式1本。 Attention(Q,K,V) = softmax(QKᵀ/√d_k)V。位置ごとに「どこをどれだけ見るか」の重みを作り、値(V)の重み付き和を取る。
- BERT・GPT-3・ViTはいずれもこの構造を使う(各原論文の記述)。 一方、論文のTable 1はAttentionの層あたり計算量が系列の長さnの2乗に比例すると書き、FlashAttention(2022年)やMamba(2023年)の要旨はこの点を課題に挙げる。
Transformerとは何か──再帰も畳み込みも使わない系列処理の構造
論文の要旨(arXivのabsページ、10月2日11時23分取得)は次のとおり。
The dominant sequence transduction models are based on complex recurrent or convolutional neural networks in an encoder-decoder configuration. The best performing models also connect the encoder and decoder through an attention mechanism. We propose a new simple network architecture, the Transformer, based solely on attention mechanisms, dispensing with recurrence and convolutions entirely.
(訳)主流の系列変換モデルは、エンコーダ・デコーダ構成の、複雑な再帰型または畳み込み型のニューラルネットワークに基づいている。最も性能の高いモデルは、エンコーダとデコーダをAttention機構でも結んでいる。我々は、Attention機構だけに基づき、再帰と畳み込みを完全に省いた、新しく単純なネットワーク構造「Transformer」を提案する。
系列変換は、英語の文をドイツ語の文に変える翻訳のような仕事を指す。要旨は続けて結果を挙げる。
Our model achieves 28.4 BLEU on the WMT 2014 English-to-German translation task, improving over the existing best results, including ensembles by over 2 BLEU. On the WMT 2014 English-to-French translation task, our model establishes a new single-model state-of-the-art BLEU score of 41.8 after training for 3.5 days on eight GPUs, a small fraction of the training costs of the best models from the literature.
(訳)WMT 2014の英独翻訳で28.4 BLEUを達成し、アンサンブルを含む既存の最良結果を2 BLEU以上上回った。英仏翻訳では、8基のGPUで3.5日の学習の後、単一モデルとして新たな最高値の41.8 BLEUを記録した。文献上の最良モデルの学習費用のごく一部である。
| 項目 | 論文の記載 |
|---|---|
| 提出 | v1は2017年6月12日(UTC)。最新版はv7(2023年8月2日) |
| 構造 | エンコーダ6層・デコーダ6層(N=6)、各層の出力次元 d_model=512、Attentionのヘッド数 h=8 |
| 学習 | NVIDIA P100 GPU 8基の1台のマシン。基本モデル10万ステップ=12時間、大モデル30万ステップ=3.5日 |
Attention Is All You Needとノーベル賞の関係は──2024年の発表文に「transformer」の語は無い
この記事は受賞の予想や推測をしない。ノーベル財団のプレスリリースによると、2024年の物理学賞(10月8日発表)はJohn J. Hopfield氏とGeoffrey Hinton氏に「for foundational discoveries and inventions that enable machine learning with artificial neural networks」(人工ニューラルネットワークによる機械学習を可能にした基礎的な発見と発明に対して)、化学賞(10月9日発表)はDavid Baker氏(計算によるタンパク質設計)とDemis Hassabis氏・John Jumper氏(タンパク質の構造予測)に授与された。
筆者が取得した2本の原文を「transformer」で検索したところ、どちらにも出てこなかった。論文とノーベル賞を結びつける記述は、この記事が当たった範囲には無い。2025年以降の発表は扱っていない。
Attention(自己注意)は何を計算しているのか
論文の3.2節はAttentionを、クエリと、キーと値の組の集合を出力に写す関数と定義する(すべてベクトル)。出力は値の重み付き和で、各値の重みはクエリと対応するキーの「compatibility」(適合度)で決まる、と書く。
論文が採った具体形が「Scaled Dot-Product Attention」で、式(1)はこれだけだ。
Attention(Q, K, V) = softmax( Q Kᵀ / √d_k ) V
3.2.1節に沿って読むと、各語のクエリ(Q)と全部の語のキー(K)の内積が「どれだけ注目するか」の点数になり、それを√d_k(キーの次元の平方根)で割り、softmaxで足して1になる重みに直して、値(V)を重み付きで足し合わせる。√d_kで割るのは、d_kが大きいと内積が大きくなってsoftmaxの勾配が極端に小さい領域に入る、と論文が考えるためだ。
「自己注意(self-attention)」は、クエリ・キー・値がすべて同じ系列から来る場合を指す(3.2.3節)。デコーダの自己注意では、softmaxの入力のうち不正な接続に当たる値を−∞に置く「マスク」で、まだ生成していない先の語を見ないようにする。
論文はさらに、Attentionを並列に8回(h=8、各64次元)行う「Multi-Head Attention」を使い、複数のヘッドなら「異なる表現部分空間」の情報を同時に見られ、1つでは平均化がそれを妨げる、と書く。語の順序は、正弦波と余弦波による「位置エンコーディング」を埋め込みに足して入れる(3.5節)。
3語の文で式(1)を動かすと何が出るか
筆者は10月2日11時25分ごろ、このMacのPython(NumPy 2.4.6)で式(1)をそのまま書いた十数行のスクリプトを実行した。3語(私は/猫が/好き)、次元d=4だが、語のベクトルも射影行列も乱数で、学習はしていない(語の名前は表示用のラベル)。出力した重み(行がクエリ、列がキー)は次のとおり。
| クエリ\キー | 私は | 猫が | 好き |
|---|---|---|---|
| 私は | 0.384 | 0.300 | 0.315 |
| 猫が | 0.321 | 0.206 | 0.473 |
| 好き | 0.053 | 0.008 | 0.939 |
各行を足すと1になる。確かめられるのはこの性質だけで、数字そのもの(「好き」が自身に0.939を置くことなど)に意味は無い。学習済みのモデルについては、多くのヘッドが文の構文や意味の構造に関係する振る舞いを示すように見える、と論文は書く(第4節末)。
なぜ広まったのか──論文と後続の原典が書いていること
論文は1節で、再帰型ネットワークは位置を順番に処理するので1つの学習例の中で並列化できないと書き、これを「根本的な制約(fundamental constraint)」と呼ぶ。Transformerは「大幅に多い並列化を可能にし」、8基のP100 GPUで「わずか12時間」の学習で翻訳品質の最高値に届きうる、と書く。第4節「Why Self-Attention」のTable 1(制限つきの行は省略)は次のとおり。
| 層の種類 | 層あたりの計算量 | 逐次演算の最小回数 | 最大経路長 |
|---|---|---|---|
| Self-Attention | O(n²·d) | O(1) | O(1) |
| Recurrent(再帰) | O(n·d²) | O(n) | O(n) |
| Convolutional(畳み込み) | O(k·n·d²) | O(1) | O(log_k(n)) |
nは系列の長さ、dは表現の次元、kは畳み込みの窓幅。逐次演算が少ないほど並列にでき、2語の間の経路が短いほど長距離の依存関係を学びやすい、というのが論文の整理だ。
翻訳の精度と学習費用は論文のTable 2にある(筆者がHTML版から抜粋。原表10行のうち、従来モデルは英独・英仏ともBLEUが最も高いConvS2Sアンサンブルだけを載せた)。
| モデル | BLEU 英独 | BLEU 英仏 | 学習費用 英独(FLOPs) | 学習費用 英仏(FLOPs) |
|---|---|---|---|---|
| ConvS2S Ensemble | 26.36 | 41.29 | 7.7×10¹⁹ | 1.2×10²¹ |
| Transformer(基本) | 27.3 | 38.1 | 3.3×10¹⁸ | 同左 |
| Transformer(大) | 28.4 | 41.8 | 2.3×10¹⁹ | 同左 |
Transformerの費用は原表(HTML版・PDFとも)で2列にまたがる1つの値なので「同左」とした。筆者の手計算(Python)では、ConvS2Sアンサンブルの英仏の費用1.2×10²¹はTransformer(大)の2.3×10¹⁹の約52倍。ただしFLOPsは実測でなく、論文が「学習時間×GPU数×各GPUの持続的な単精度演算性能の推定値」で見積もった値だ。6.1節は、英仏でTransformer(大)がそれまでの単一モデルをすべて上回り、費用は従来の最高性能モデル(the previous state-of-the-art model)の「1/4未満」だったと書く。
BERT・GPT・ViTはTransformerのどこを引き継いだのか
3つとも、arXivの原論文が「Transformer」の語で自分の構造を説明している。
BERT(Devlin氏ら、2018年10月)は「Bidirectional Encoder Representations from Transformers」の略。要旨は、ラベルなしの文章から左右両方の文脈を使う表現を事前学習し、出力層を1つ足すだけで質問応答などに使えると書き、11の課題で最高値(GLUEスコア80.5%など)を報告する。本文はモデルを「multi-layer bidirectional Transformer encoder」(多層の双方向Transformerエンコーダ)と書く。元の論文のエンコーダ側を使う形だ。
GPT。GPT-3の論文(Brown氏ら、2020年5月)は1,750億パラメータの自己回帰言語モデルで、2.1節は「We use the same model and architecture as GPT-2」(GPT-2と同じモデルと構造を使う)と書く。BERTの論文(2018年)は、当時のOpenAI GPT(初代)との違いをこう書く。
Critically, however, the BERT Transformer uses bidirectional self-attention, while the GPT Transformer uses constrained self-attention where every token can only attend to context to its left.
(訳)ただし決定的な違いとして、BERTのTransformerは双方向の自己注意を使い、GPTのTransformerは、各トークンが自分より左の文脈しか見られない制約つきの自己注意を使う。
元の論文のデコーダが先の語を−∞のマスクで隠すのと同じ考え方がGPTの「左しか見ない」自己注意にあたる、と筆者は読んだ。これは筆者の読みで、本記事が当たったGPT-3論文に、元論文のマスクとの関係を述べた箇所は見当たらなかった。
ViT(Vision Transformer)(Dosovitskiy氏ら、2020年10月)。題名は「An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale」で、要旨の冒頭はこう書く。
While the Transformer architecture has become the de-facto standard for natural language processing tasks, its applications to computer vision remain limited.
(訳)Transformer構造は自然言語処理の事実上の標準になったが、コンピュータビジョンへの応用は限られている。
要旨は続けて、画像をパッチの並びにして純粋なTransformerを当てると画像分類で良い結果が出ると書き、大量のデータで事前学習すると、最先端の畳み込みネットワークより学習に必要な計算資源が「substantially fewer」(大幅に少ない)と書く。
筆者の整理では、BERTは元の論文のエンコーダ側、GPTは左だけを見るデコーダ側に近い使い方、ViTは入力が画像パッチ、となる。LLMの定義はLLMとは、トークンはトークンとは何か、入口はニューラルネットワークとは何か、MoEはMoEとはに。
論文の著者8人は今どこにいるのか
論文(arXivのHTML版)の著者欄では、Ashish Vaswani、Noam Shazeer、Łukasz KaiserがGoogle Brain、Niki Parmar、Jakob Uszkoreit、Llion JonesがGoogle Research、Aidan N. GomezはUniversity of Toronto(「Work performed while at Google Brain」の注記)、Illia Polosukhinは所属欄なし(「Work performed while at Google Research」の注記)。脚注は「Equal contribution. Listing order is random.」(同等の貢献。並び順は無作為)と書く。
その後について、筆者が公式の会社ページで10月2日11時24〜25分に確かめられたのは3人だけだ。
- Llion Jones氏:Sakana AIの会社情報ページ(英語)が「Co-Founder & CTO」とし、Transformer構造を導入した論文「Attention Is All You Need」の共著者と紹介する。会社はSakana AIとは、Schmidhuber氏の参画は関連記事に。
- Aidan Gomez氏:Cohereの「About」ページが、創業者の欄に「Aidan Gomez Co-founder and CEO」と載せている。
- Ashish Vaswani氏:Essential AIの「About」ページが「Our CEO, Dr. Ashish Vaswani」と書く。
残る5人は、この記事が当たった公式ページでは現在の肩書きを確かめられなかったので、書かない。
長い文脈で何が重くなるのか──計算量とその後の研究
Table 1のとおり、Self-Attentionの層あたり計算量はO(n²·d)で、系列の長さnの2乗に比例する。論文は第4節で、nが表現次元dより小さければ再帰層より速いとし、「非常に長い系列」には近傍r個だけを見る制限つきのAttentionを今後検討すると書く。
その後の研究の要旨は、この点を別々の方向から扱う。
- 線形Attention(Katharopoulos氏ら、2020年6月):自己注意をカーネル特徴写像の線形な内積で表し、計算量をO(N²)からO(N)に下げる。非常に長い系列の自己回帰の予測で最大4000倍速い。
- FlashAttention(Dao氏ら、2022年5月):近似なしの正確なAttentionのまま、GPUのメモリ階層間の読み書きを減らす。GPT-2(系列長1K)で3倍の高速化。
- S4(Gu氏ら、2021年10月):Attentionを使わない状態空間モデル。Long Range Arenaの全課題で最高値、画像と言語ではTransformerとの差を「大幅に縮めた」。
- Mamba(Gu氏・Dao氏、2023年12月):入力に応じて情報を取捨選択する状態空間モデル。推論のスループットはTransformerの5倍、3Bのモデルは同サイズのTransformerを上回り、2倍の大きさのTransformerに並ぶ。
長い入力を扱う側の話はコンテキストウィンドウとはに。4本は2020〜2023年の論文で、2026年10月時点の主要なLLMがどの構造かは、この記事では確かめていない。
取れなかった数字と、読み違えやすい点
被引用数は載せていない。 筆者は10月2日11時23〜26分に、キー不要の公開APIであるSemantic Scholar Graph APIへ、この論文とBERT・GPT-3・ViTの被引用数を求めて計8回リクエストを送ったが、8回ともHTTP 429(Too Many Requests)だった。OpenAlexの公開APIで題名を検索すると2025年付けの別のDOIの記録が最上位に出たが、arXiv版と同じ論文として数えられているか確認できず、その数字も載せない。
英仏のBLEUは論文の中で2通りある。 要旨とTable 2は「41.8」、6.1節の本文は「our big model achieves a BLEU score of 41.0」。筆者はv7のHTML版とPDFの両方で2つを確認した。どちらが正しいかは論文からは決められないので、41.8を使い41.0を併記した。
題名を「Attentionさえあれば何でもできる」と読むと、論文の範囲を超える。 題名の主張は、再帰と畳み込みを使わなくても翻訳で品質の高い結果が出る、という要旨の範囲の話だ。構造にはAttentionのほか、位置ごとのフィードフォワード層、残差接続、層正規化、位置エンコーディングも入っている(3節)。
この記事が当たった一次資料と取得時刻
論文のabs・HTML版v7(11時23分)とPDF v7(11時25分)、BERT・GPT-3・ViTのabs(11時23分)とBERT・GPT-3のPDF(11時25分)、後続4本のabs(11時25分)、ノーベル財団の2024年物理学賞・化学賞のプレスリリース(11時23分)、Sakana AI・Cohere・Essential AIの会社ページ(11時24〜25分)を、いずれも2026年10月2日(日本時間)にcurlで取得し、引用と数字を原文と突き合わせた。各URLは出典欄にある。要旨の訳と式の読み方の説明は筆者による。
確かめていない点:Shazeer氏ら5人の現在の所属、被引用数、2026年時点の主要LLMがどの構造を採っているか。サムネイルはarXivのabsページのスクリーンショット(10月2日)。
出典・参照資料
- 一次資料arXiv:1706.03762 Attention Is All You Need(abs。著者8人・要旨・提出履歴v1〜v7。2026年10月2日11時23分取得) ↗
- 一次資料arXiv:1706.03762v7 HTML版(本文・式(1)・Table 1・Table 2・5.2節・6.1節。2026年10月2日11時23分取得) ↗
- 一次資料arXiv:1706.03762v7 PDF(Table 2・6.1節の41.0の確認。2026年10月2日11時25分取得) ↗
- 一次資料arXiv:1810.04805 BERT(abs 11時23分・PDF 11時25分。2026年10月2日取得) ↗
- 一次資料arXiv:2005.14165 Language Models are Few-Shot Learners(GPT-3。abs 11時23分・PDF 11時25分。2026年10月2日取得) ↗
- 一次資料arXiv:2010.11929 An Image is Worth 16x16 Words(ViT。2026年10月2日11時23分取得) ↗
- 一次資料arXiv:2006.16236 Transformers are RNNs(線形Attention。2026年10月2日11時25分取得) ↗
- 一次資料arXiv:2205.14135 FlashAttention(2026年10月2日11時25分取得) ↗
- 一次資料arXiv:2111.00396 S4(構造化状態空間。2026年10月2日11時25分取得) ↗
- 一次資料arXiv:2312.00752 Mamba(2026年10月2日11時25分取得) ↗
- 一次資料The Nobel Prize in Physics 2024 プレスリリース(ノーベル財団。2026年10月2日11時23分取得) ↗
- 一次資料The Nobel Prize in Chemistry 2024 プレスリリース(ノーベル財団。2026年10月2日11時23分取得) ↗
- 一次資料Corporate Information — Sakana AI(Llion Jones氏の肩書き。2026年10月2日11時24分取得) ↗
- 一次資料About — Cohere(Aidan Gomez氏の肩書き。2026年10月2日11時24分取得) ↗
- 一次資料About — Essential AI(Ashish Vaswani氏の肩書き。2026年10月2日11時25分取得) ↗

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
ニューラルネットワークとは何か 仕組みの基礎とAIモデル記事への入口
ニューラルネットワークとは何か仕組みの基礎とAIモデル記事への入口
MoE(Mixture of Experts)とは 「総パラメータ」と「アクティブパラメータ」の読み分け方まで
MoE(Mixture of Experts)とは「総パラメータ」と「アクティブパラメータ」の読み分け方まで
コンテキストウィンドウとは AIが一度に「見ていられる」量。主要モデルの現在値(API 100万トークン級)、ChatGPT・Geminiのプラン別上限、超えるとどうなるか、広ければいいわけではない理由
コンテキストウィンドウとはAIが一度に「見ていられる」量。主要モデルの現在値(API 100万トークン級)、ChatGPT・Geminiのプラン別上限、超えるとどうなるか、広ければいいわけではない理由
トークンとは何か LLMの料金とコンテキストを決める最小単位
トークンとは何かLLMの料金とコンテキストを決める最小単位
Sakana AI、LSTM考案者の一人シュミットフーバー氏を招聘 Transformer論文の共著者は氏ではなく同社CTOのLlion Jones氏
Sakana AI、LSTM考案者の一人シュミットフーバー氏を招聘Transformer論文の共著者は氏ではなく同社CTOのLlion Jones氏
 動画
AIは二度、資金を断たれてきた 76年の歴史を、繰り返された「冬」から読む
AIは二度、資金を断たれてきた76年の歴史を、繰り返された「冬」から読む
Sakana AI、社内で育ってきた研究グループ「Frontier Intelligence Group」を公表 Transformer論文共著者のCTO Llion Jones氏が問うポストTransformer
Sakana AI、社内で育ってきた研究グループ「Frontier Intelligence Group」を公表Transformer論文共著者のCTO Llion Jones氏が問うポストTransformer