コンテキストウィンドウとは──AIが一度に「見ていられる」量。主要モデルの現在値(API 100万トークン級)、ChatGPT・Geminiのプラン別上限、超えるとどうなるか、広ければいいわけではない理由
コンテキストウィンドウは、AIモデルが1回の処理で同時に扱える文章の上限で、単位はトークン。質問だけでなく、それまでの会話・システム指示・ツール定義・AIの返答(思考を含む)が全部この枠に入る。2026年9月時点、API側はGPT-5.6 Sol/GPT-6 Astra(105万)、Claude Fable 5.1・Opus 5・Sonnet 5(100万)、Gemini 3.8 Flash(104万8,576)と「100万トークン級」が標準になったが、アプリ側は別で、ChatGPTはInstantが無料27K・Plus 54K・Pro 128K、推論がGo/Plus 256K・Pro 400K、Geminiアプリは無料3.2万・AI Plus 12.8万・AI Pro 100万と、プランで大きく違う。超えたときの挙動(ChatGPTは共有枠、Claude APIは圧縮、Astra/Solは27.2万超で入力2倍の課金)と、「広い=良い」ではない実測(Context Rot)・ローカル実行のメモリ式まで、公式ページと当サイトの記事で整理する。
目次
2026年9月18日・日本時間時点の情報です。 モデルの発表文に必ず出てくる「コンテキストウィンドウ100万トークン」という数字は、何を数えていて、アプリで使うときの上限とどう違うのか。この記事は、用語の意味から始めて、主要モデルの現在値、ChatGPT・Geminiのプラン別の上限、上限を超えたときに何が起きるか、「広ければ良い」とは限らない実測までを、公式ページと当サイトの記事で1ページにまとめる。用語の索引は/termsに。
3行まとめ
- 意味。 コンテキストウィンドウは、AIモデルが1回の処理で同時に扱える文章の上限で、単位はトークン(日本語はおおむね1文字=1〜数トークン)。今の質問だけでなく、**それまでの会話・システム指示・ツール定義・AIの返答(思考を含む)**が全部この枠を分け合う。
- 現在値。 API側は「100万トークン級」が標準になった。GPT-5.6 Sol/Terra/Luna・GPT-6 Astraは105万(入力92万2,000・出力12万8,000)、Claude Fable 5.1・Mythos 5.1・Opus 5・Sonnet 5は100万(出力12万8,000)、Gemini 3.8 Flashは104万8,576(出力6万5,536)。ただしアプリ側はプランで違う。ChatGPTはInstantが無料27K・Go/Plus 54K・Pro 128K、推論モデルがGo/Plus 256K・Pro 400K。Geminiアプリは無料3.2万・AI Plus 12.8万・AI Pro/Ultra 100万。
- 超えるとどうなるか・広ければ良いか。 ChatGPTは「共有コンテキストウィンドウ」で、入力に使える領域は上限より小さい(システム指示・メモリ・内部処理が使う)。Claude APIは会話を要約して詰める圧縮が用意され、OpenAIのSol/Astraは27.2万トークンを超えると入力2倍・出力1.5倍の課金になる。そして18モデルを検証した「Context Rot」では、入力が長くなるほど単純な作業でも正答率が落ちる。広い枠は「入る」ことを保証するだけで、「同じ精度で読める」ことは保証しない。
何を数えているのか
コンテキストウィンドウ(context window)は、モデルが1回の応答を作るときに参照できるトークンの総量で、次のものがすべて入る。
| 枠に入るもの | 例 |
|---|---|
| システム指示 | アプリ側が付けている指示(ChatGPTの脚注では「ツールやパーソナリティを含む」) |
| これまでの会話 | 同じチャットの過去のやり取り全部 |
| 今の入力 | 質問・貼り付けた文章・添付ファイルの中身 |
| ツールの定義と結果 | 検索結果、コード実行の出力、MCPのツール一覧 |
| メモリ | 有効にしているときの記憶 |
| AIの返答 | 出力トークン。思考(reasoning)を出すモデルはその分も |
つまり「100万トークン」は、貼り付けられる文章の量ではなく、全部を足した上限である。ChatGPTの料金ページの脚注はこれをそのまま書いている。「ユーザーが入力に使用できる領域は、コンテキストウィンドウ全体よりも小さくなっています。これは、システム指示(ツールやパーソナリティを含む)、メモリ(有効な場合)、および内部処理(情報の確認、推論、応答生成)にも領域が使用されるためです」。
1トークンが何文字かはトークンの記事に。Anthropicのモデルページには「1Mトークンは、現行のトークナイザでおおよそ英語55万5,000語・250万Unicode文字。Opus 4.7より前のモデルは1Mに約75万語が入った」という目安があり、同じ100万でもトークナイザで詰められる量が違う。
主要モデルの現在値(API・2026年9月18日)
| モデル | コンテキスト | 最大入力/最大出力 | 出典 |
|---|---|---|---|
| GPT-6 Astra | 1,050,000 | 922,000/128,000 | OpenAIモデルページ(Astraの使い方) |
| GPT-5.6 Sol/Terra/Luna | 1,050,000 | 922,000/128,000 | OpenAIモデルページ(Solとは) |
| Claude Fable 5.1/Mythos 5.1 | 1,000,000 | —/128,000 | Anthropicモデルページ(Fable 5.1の使い方) |
| Claude Opus 5/Sonnet 5 | 1,000,000 | —/128,000 | 同上の比較表 |
| Claude Haiku 4.5 | 200,000 | —/64,000 | 同上の比較表 |
| Gemini 3.8 Flash | 1,048,576 | —/65,536 | Googleモデルページ(3.8 Flashの記事) |
OpenAIの「最大入力92万2,000」は、105万から出力の12万8,000を引いた値で、入力と出力が同じ枠を分け合っていることが数字にも表れている。
アプリ側はプランで違う
API の数字と、ChatGPT・Geminiのアプリで実際に使える枠は別物である。
ChatGPT(料金ページの比較表・2026年9月18日取得)
| 無料 | Go | Plus | Pro | |
|---|---|---|---|---|
| GPT Instant のコンテキストウィンドウ上限 | 27K | 54K | 54K | 128K |
| Instant の入力の目安 | 約12ページ | 約40ページ | 約40ページ | 約250ページ |
| GPT 推論のコンテキストウィンドウ上限 | 場合によって異なる | 256K | 256K | 400K |
| 推論の入力の目安 | 場合によって異なる | 約320ページ | 約320ページ | 約680ページ |
同じ「GPT-5.6 Sol」でも、APIの105万に対しアプリのInstantでは54K〜128Kで、アプリでは上限を絞って提供している。長い資料を読ませるならInstantでなく推論モデル(Thinking)側の枠を使うことになる。ChatGPTのプランと使い分けはChatGPTの使い方に。
Geminiアプリ(Googleヘルプ・Geminiアプリの使い方)
| プラン | コンテキストウィンドウ |
|---|---|
| 無料 | 3万2,000トークン |
| Google AI Plus(月725円) | 12万8,000トークン |
| Google AI Pro(月2,900円)/Ultra | 100万トークン |
Claude.aiのプラン別の枠は、当サイトが確認した公式資料(Fable 5.1の使い方で参照したヘルプ)にプランごとの数字としては書かれていないため、この記事ではAPIの値だけを載せる。
超えるとどうなるか
- ChatGPT:枠は共有で、会話が長くなると古い部分が参照されなくなる。料金ページは「ユーザー入力用として表示される容量は目安であり、使用中の機能やメモリの内容に応じて動的に変化する場合があります」と書く。
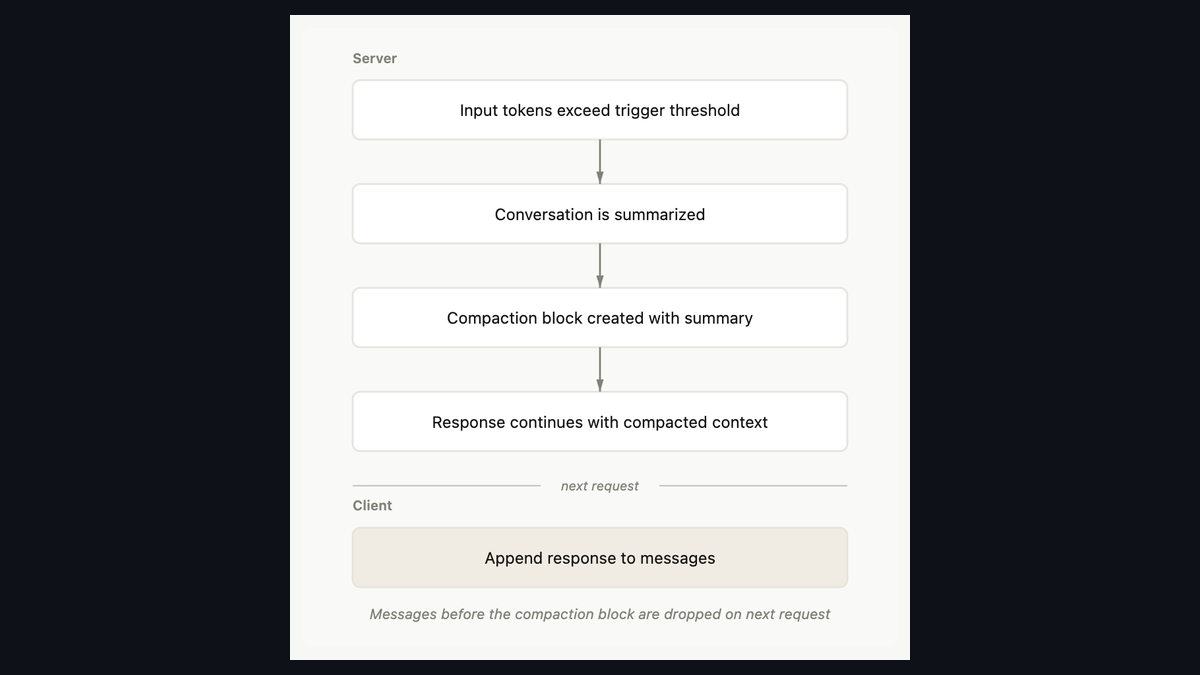
- Claude API:入力が枠を超える前に会話を要約して詰める「圧縮(compaction)」がある。従来はしきい値(5万トークン以上)で自動要約、9月14日からは開発者が任意のタイミングで要約を求められるベータが加わった(オンデマンド圧縮の記事)。Claude Codeでも枠が埋まると自動で圧縮が走る(同記事の筆者の観測)。
- OpenAI API(Sol/Terra/Luna/Astra):枠の中でも入力が27万2,000トークンを超えると、そのリクエスト全体が入力2倍・出力1.5倍の単価になる(Astraの使い方の引用「Prompts with more than 272K input tokens are priced at 2x input and cache rates and 1.5x output for the full request」)。枠に入っても、長いと高い。
- ローカル実行:枠の広さはそのままメモリ消費になる。KVキャッシュがコンテキスト長に比例して増え、70Bモデルなら128Kでキャッシュだけで約40GB、100万トークンなら約320GBに達する(計算式の記事)。「1M対応」のモデルを手元で1Mで動かすのは、家庭用のMacやGPUでは現実的でない。
広ければ良いわけではない
ベクトルDB企業Chromaの技術レポート「Context Rot」(2025年7月)は、GPT-4.1・Claude 4・Gemini 2.5・Qwen3を含む18モデルで、入力が長くなるほど、単純な作業でも性能が落ちることを示した。定番の「Needle in a Haystack」(長文の中から1文を探す)で満点でも、探す対象と質問の言い回しが離れていたり、紛らわしい文(distractor)が混じっていたりすると、長さに応じて落ちる(レポートの読解記事)。
実務での含意は3つ。
- 入れられるだけ入れない。 必要な部分だけを渡す方が、精度も費用も良い。長い会話は要約して新しいチャットに移す
- 長い資料は「読ませ方」を設計する。 どこに何を置くか、何を先に読ませるかを決めるのがコンテキストエンジニアリングで、枠の広さが解決するわけではない
- 課金は枠でなく使った量で決まる。 APIは入力トークン数×単価なので、100万の枠を毎回埋めれば1回あたり数ドルから数十ドルになる。Sol/Astraは27.2万を超えると単価も上がる
筆者が確かめた点
この記事の下調べで、筆者はChatGPTの料金ページ(日本語版)の比較表を9月18日に自分の画面で開き、「GPT Instant のコンテキストウィンドウ上限 27K/54K/54K/128K」「GPT 推論のコンテキストウィンドウ上限 場合によって異なります/256K/256K/400K」の行と脚注の文言を確認した。OpenAIのモデルページ4本(Sol・Terra・Luna・Astra)は、いずれもコンテキスト1,050,000・最大入力922,000・最大出力128,000で同じ値だった。AnthropicのFable 5.1とMythos 5.1のモデルページの比較表も同じ値で、Haiku 4.5だけが200,000/64,000である。
書かれていないこと
- ChatGPTの「GPT 推論」の枠が、Thinkingのどの段階(Medium/High/Extra High)にも同じ値で当たるかは、料金ページに記載がない
- Claude.aiのプラン別(Pro・Max)のコンテキスト上限は、当サイトが参照したヘルプに数字としては書かれていない
- 各社の「入力の目安(約○ページ)」の1ページの定義は、料金ページに記載がない
出典はOpenAI・Anthropic・Googleの公式ページとChromaのレポート
- ChatGPTのプラン別の枠は、ChatGPT料金ページの比較表(2026年9月18日取得)
- APIの値は、OpenAI・Anthropic・Googleのモデルページ(それぞれ当サイトの各記事で取得日つきで引用)
- Geminiアプリのプラン別の枠は、Googleヘルプ(Geminiアプリの使い方で確認)
- 「Context Rot」はChromaの技術レポート原文
- 本記事は主要モデルの値やプランの上限が変わったら更新する
出典・参照資料
AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事
トークンとは何か──LLMの料金とコンテキストを決める最小単位
長く話すほどAIは劣化する──「Context Rot」をChromaの技術レポートで読む
Macで動くモデルサイズの計算式──「コンテキスト窓が広い」の裏でVRAMが消えていく仕組み
Claude APIに「任意のタイミングで会話を圧縮する」オンデマンド圧縮(ベータ)──署名付きの要約ブロックを返し、直近の会話は原文のまま残せる。しきい値型との違い、課金の見方、失敗時の挙動

コンテキストエンジニアリングとは──プロンプトエンジニアリングとの違いを整理する
GPT-6 Astraの使い方──どのプランで、どこで使えて、週に何通まで送れるか(ChatGPT・Work・Codex・API)

AIは無料版で足りるか、有料に上げるべきか──実際に使い分けてきて分かった判断の分かれ目