ChatGPTともClaudeとも作りが違う新モデル「Jev」──文章を書かず判定だけを返すTypeSafe AIの発表を、公式ブログと評価サイトの数字で読む
TypeSafe AIが2026年9月15日に発表した「Jev」は、文章を生成せず、事前に決めた質問への判定(はい/いいえ・選択肢・点数)だけを確かさの数字つきで返すモデルだ。同社の評価では、4種類の業務判断でGPT-5.6 Terraと同じ正解率(67.8%対67.9%)のまま、1件のコストは76分の1、応答時間は25分の1。ただし数字はすべて自社評価で、「答えの形の誤り0%」は実測ではなく仕様上の値だと同社自身が書いている。創業者は元OpenAIで、「人が好む文章への最適化は自動化には間違った目標だった」と述べた。
目次
2026年9月16日朝・日本時間時点の情報です。米TypeSafe AIは9月15日(米国時間)、公式ブログで新しいモデル「Jev」を発表し、順番待ちの開発者向けに早期アクセスを始めた。同社が「System One Model」と呼ぶこのモデルは、ChatGPTやClaudeのように文章を生成しない。文章やログを入れると、あらかじめ決めておいた質問への判定だけを、確かさの数字つきで返す。同社の評価では、4種類の業務判断でOpenAIのGPT-5.6 Terraと同じ正解率のまま、1件あたりのコストは76分の1、応答時間は25分の1だった。この記事は公式ブログと評価サイトの原文と数字だけで、何が違うのか、どこまで確かめられているのかを並べる。動画版(12分)も公開している: https://youtu.be/HmLK5Vr-mgc
3行まとめ
- Jevは文章を書かない。入力は普通の文章(メール、ログ、記録)、出力は「はい/いいえ」「用意した選択肢のどれか(最大255択)」「点数」の3種類だけで、それぞれに確かさの数字がつく。会話、コード生成、要約はできないと同社が明記している。
- 同社評価の数字:4種類の業務判断の平均で、Jevは正解率67.8%・1件0.0004ドル・0.4秒。同じ正解率のGPT-5.6 Terra(workflow方式)は67.9%・0.0304ドル・10.1秒。差は76倍と25倍(当方計算)。一番正解率が高いのはGPT-5.6 Solの74.1%で、Jevはそこには届かない。
- 同社が自分で書いている限界:評価は自社製で公開ベンチマークは出さない方針、評価の「正解」はGPT-6 AstraとClaude Fable 5.1の平均、「答えの形の誤り0%」は実測でなく仕様上の値、価格が持ち出しでないことは「証明できない」、内部構造は非公開。第三者の測定はまだ無い。
何が返ってくるのか──入力は文章、出力は3種類の判定
同社ブログの一文がJevの定義になっている。
Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out.
(Jevを、フロンティア級の知能による関数呼び出しだと考えてほしい。構造化されていない状態を入れると、型の決まった確率的な判定が出てくる。)
評価サイトの説明によると、質問の型は3種類ある。「Noul」(はい/いいえ。確率で返る)、「Choice」(定義した選択肢のうちどれか。選択肢ごとの分布と確信度)、「Score」(尺度上の点数と、水準ごとの分布と確信度)だ。ブログには「Jev supports a cardinality up to 255(Jevは255までの選択肢数に対応する)」とあり、それを超える場合は独立に採点してから明示的に選ぶ2段階になる。
使い方を、説明のための仮の例で書く。会社に届くメールから苦情を見つけたいなら、最初に「このメールは苦情か」という項目を1つ設定しておく。あとは届いたメールを渡すたびに、説明文でも返信文でもなく、「はい」か「いいえ」と確かさの数字が返る。その結果を受け取った別の仕組みが、苦情なら担当窓口に、そうでなければ通常の受付に回す。ChatGPTでも同じ分類はできるが、Jevは文章を作る機能を持たず、決めた判定を繰り返し返すことに絞っている、というのが同社の位置づけだ。
既存のLLMと何が違うと同社は言っているか
ブログ冒頭の比較表を要約すると次のようになる。数字は同社の表記。
| 項目 | 既存のLLM(同社の記述) | System One / Jev(同社の記述) |
|---|---|---|
| 訓練の目標 | RLHF/RLVR。人間の評価者が好む文章、または機械で検証できる出力 | RLCD(Reinforcement Learning for Calibrated Decisions)。出した確率が実際の正解率と合う判定 |
| 入力 | 非構造データ。逐次のメッセージが中心 | 非構造データ。プログラムの状態が中心 |
| 出力 | 文字列。何でも出せる分、使うには解析と検証が要る | 型の決まった構造化値。出力の候補と形は事前定義。型エラーは起きない |
| 生成方式 | 1トークンずつ逐次 | 全出力を1回の問い合わせで並列に出す |
| 価格 | 入力100万トークンあたり0.20〜10ドル。出力は入力の約5倍 | 入力100万トークンあたり0.042ドル。出力は無料(「計測するには安すぎる」) |
| 応答時間 | 3〜329秒(同社が外部サイトの計測を引用) | 70〜500ミリ秒 |
| 確信度 | 求めても過信・不安定になりがち | すべての出力に確信度がつき、高い確信ほど正解率が高い |
同社は「While Jev gives up string generation, it's optimized for structured outputs and can't hallucinate.(Jevは文字列生成を捨てた代わりに、構造化出力に最適化されており、ハルシネーションを起こせない)」と書いている。この「起こせない」の意味は後述する。
数字──同社評価で「Terraと同じ正解率、費用76分の1、時間25分の1」
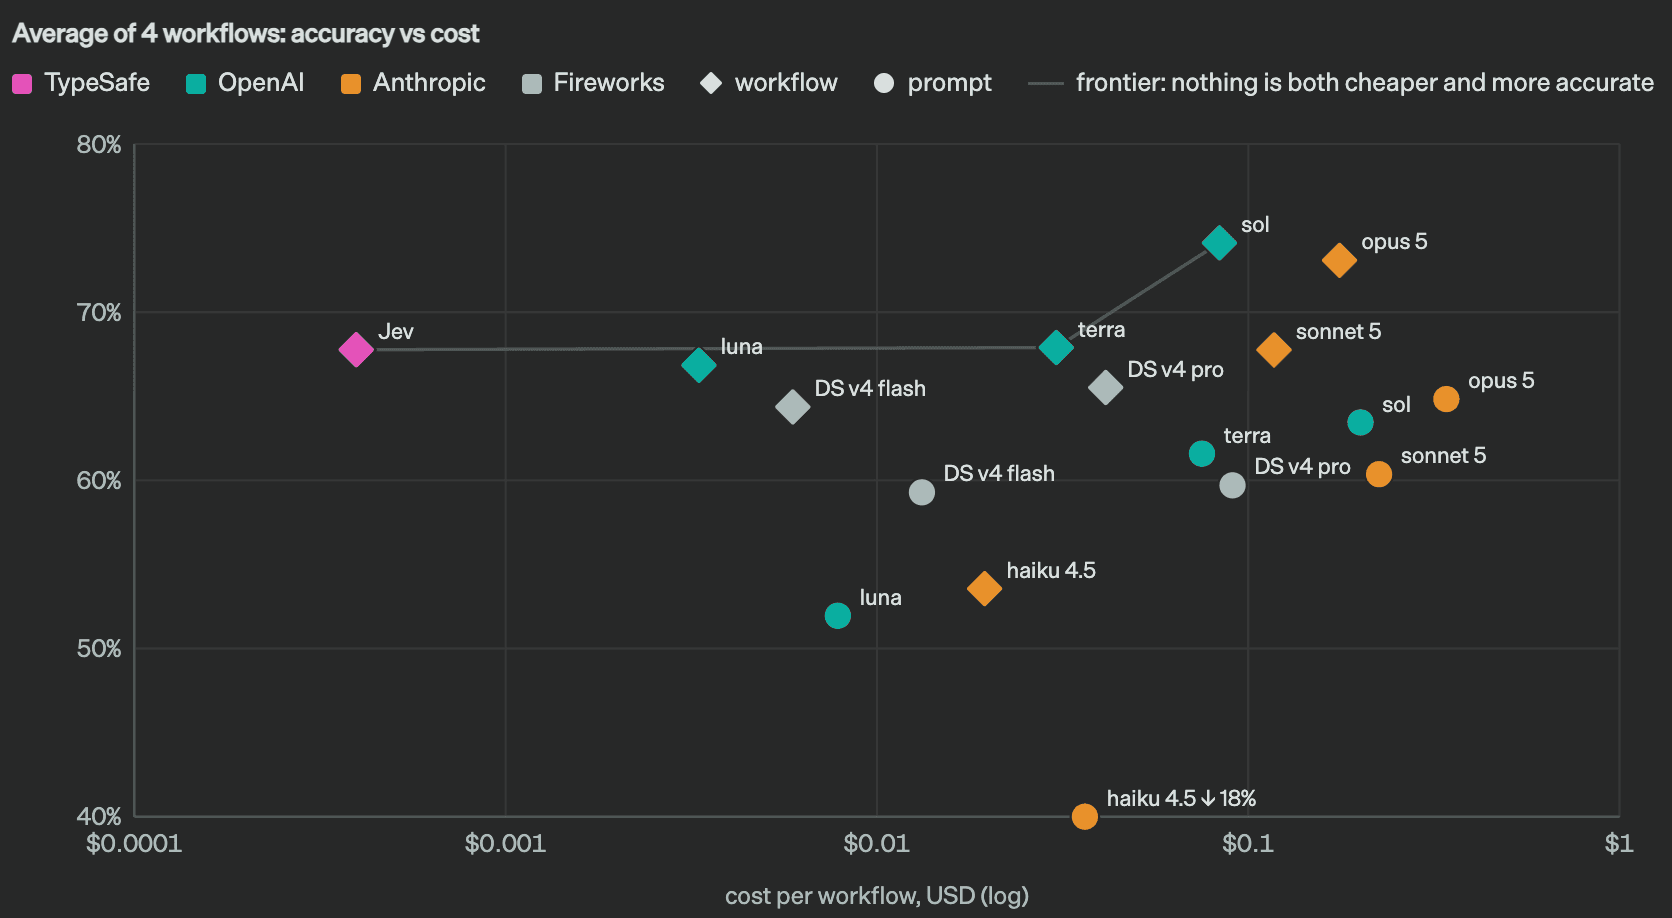
評価サイトは、セキュリティ警報の対応、サポート対応ログの監査、請求書処理、カスタマーサービスの4種類の業務を、判定の連なり(ワークフロー)としてコードに書き、同じワークフローを各モデルに通して正解率・コスト・時間を測っている。正解は「GPT-6 AstraとClaude Fable 5.1(いずれもhigh thinking)の回答の平均」で、他のモデルは各社の既定の推論設定だ。4業務の平均は次の通り(評価サイトの図のデータから抜粋。「workflow」は分解した質問で動かす方式、「prompt」は1つの指示で丸ごと判断させる方式)。
| モデル | 方式 | 正解率 | 1件コスト | 時間 |
|---|---|---|---|---|
| Jev | workflow | 67.8% | $0.0004 | 0.4秒 |
| GPT-5.6 Terra | workflow | 67.9% | $0.0304 | 10.1秒 |
| GPT-5.6 Sol | workflow | 74.1% | $0.0836 | 23.3秒 |
| Claude Opus 5 | workflow | 73.1% | $0.1761 | 37.8秒 |
| GPT-5.6 Luna | workflow | 66.8% | $0.0033 | 12.9秒 |
| Claude Sonnet 5 | workflow | 67.8% | $0.1174 | 78.1秒 |
| GPT-5.6 Terra | prompt | 61.6% | $0.0750 | 25.1秒 |
同じ正解率のTerra(workflow)と比べると、コストは0.0304÷0.0004=76倍、時間は10.1÷0.4=25倍の差になる(当方計算)。一方で正解率の最高はSolの74.1%、次いでOpus 5の73.1%で、Jevは届かない。SolとOpus 5の1件コストはJevの約209倍と約440倍だ。
同社のトップページには「193.6倍速く、444.6倍安い」とあるが、ブログはその出所と評価を自分で書いている。
This is where the claims of 193.6x faster, 444.6x cheaper on our home page comes from, and we expect that these are on the higher end of real world gains.
(トップページの「193.6倍速い、444.6倍安い」という主張はここから来ている。そして我々は、これらが実世界で得られる改善の上振れ側にあると見込んでいる。)
評価サイトはもう1つ、方式そのものについて「4業務の平均で、どのモデルも、同じ方針をプロンプトで丸ごと渡すより、ワークフローに分解した方が正確で、安く、速かった」と書いている。上の表のTerraの2行(67.9%対61.6%)がその例だ。
「ハルシネーションしない」の意味──0%は実測ではない
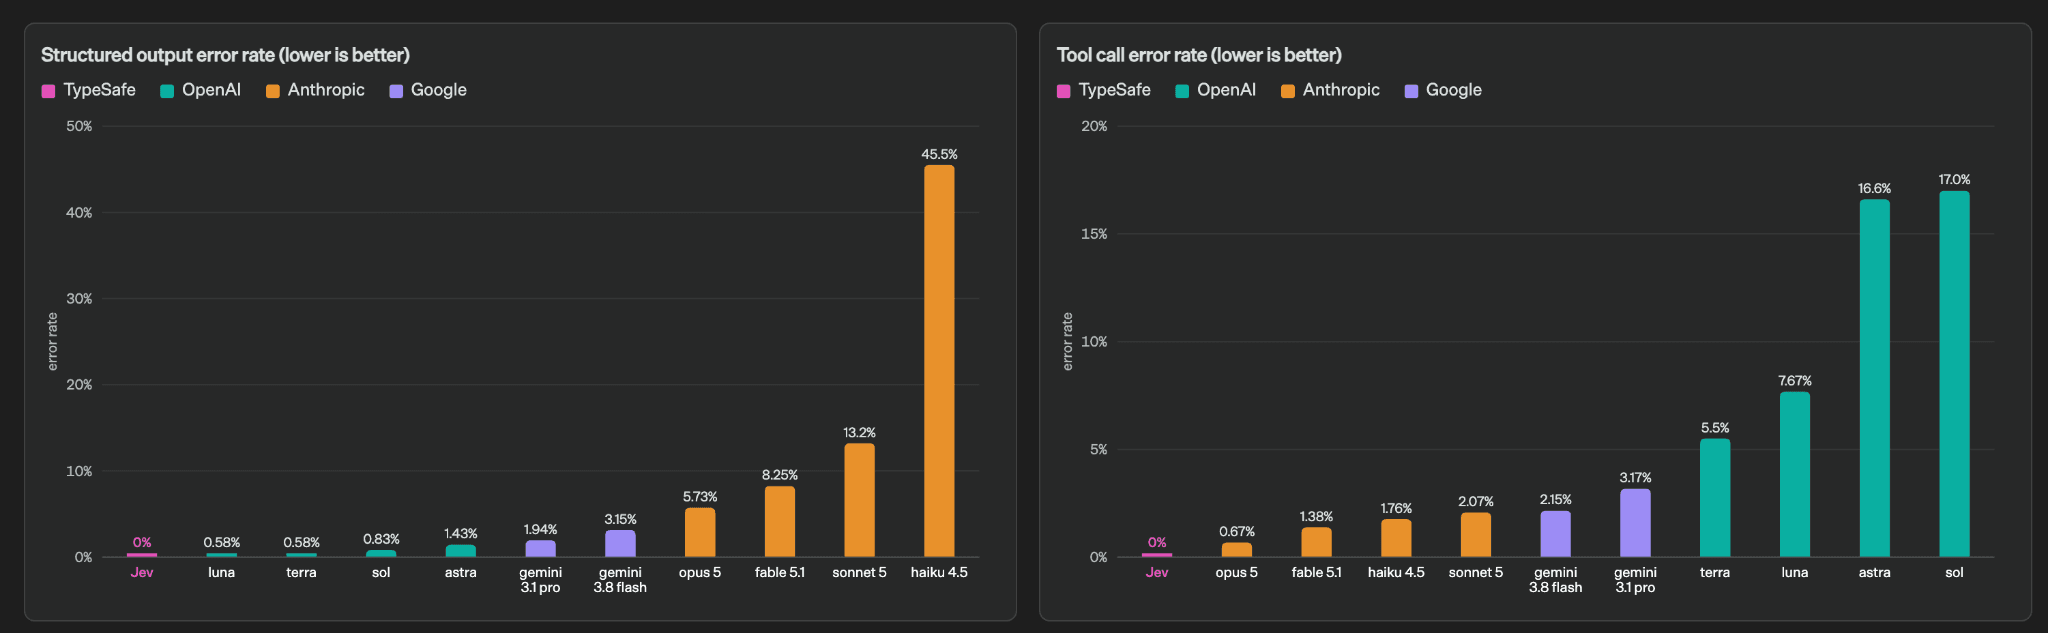
ブログは、決めた形式で答えさせた時に形式が崩れた割合(構造化出力のエラー率)と、ツール呼び出しの失敗率を図にしている。構造化出力では、Jev 0%、Luna 0.58%、Terra 0.58%、Sol 0.83%、Astra 1.43%、Gemini 3.1 Pro 1.94%、Gemini 3.8 Flash 3.15%、Opus 5 5.73%、Fable 5.1 8.25%、Sonnet 5 13.2%、Haiku 4.5 45.5%。ツール呼び出しでは、Jev 0%、Opus 5 0.67%、Fable 5.1 1.38%、Haiku 4.5 1.76%、Sonnet 5 2.07%、Gemini 3.8 Flash 2.15%、Gemini 3.1 Pro 3.17%、Terra 5.5%、Luna 7.67%、Astra 16.6%、Sol 17.0%だ。
ここで同社は、Jevの0%が測定値でないことを明記している。
Our number is not empirical. Schema matching is guaranteed, thus we can confidently add 0% into the plots.
(我々の数字は実測ではない。スキーマへの一致は保証されているので、自信を持って0%を図に入れられる。)
つまり「ハルシネーションを起こせない」は、答えの形が事前に固定されているため、存在しない選択肢や壊れた形式を返すことが仕組み上ないという意味で、判定の中身が正しいという意味ではない。間違った選択肢を選ぶことは普通に起きる。他社モデル側の数字については「The numbers for LLMs are from OpenRouter i.e., there almost certainly is bias here: more complex queries might be routed to better models.(LLMの数字はOpenRouterからのもので、ほぼ確実に偏りがある。難しいクエリほど良いモデルに回されている可能性がある)」とも書いている。
誰が作ったのか──「人が好む文章への最適化は、自動化には間違った目標だった」
ブログの筆者は創業者のDiogo Almeida氏で、OpenAIで言語モデルに指示を守らせる手法の構築に関わり、その研究が「ended up as the research behind ChatGPT(ChatGPTの背後にある研究になった)」と書いている。同氏によれば、この4年間の問いは「Models have been superhuman at chat for years, so where is all the automation?(モデルは何年も前からチャットで超人的なのに、自動化はどこにあるのか)」だった。同社は2年間ステルスで開発し、新しいアーキテクチャ、並列サンプラー、RLCDと呼ぶ訓練法を組み合わせたとしている。
FAQでは、なぜ新しい訓練法が要ったかをこう説明する。
Every lab optimizes for the same task during Reinforcement Learning with Human Feedback (RLHF): produce the text that a human rater prefers. That was the right task for a chat product, but it is the wrong task for automation.
(どのラボも、人間のフィードバックによる強化学習(RLHF)で同じ課題に最適化している。人間の評価者が好む文章を出すことだ。それはチャット製品には正しい課題だったが、自動化には間違った課題だ。)
「Jevは小さいLLMか」というFAQには「Jev is neither small nor an LLM(Jevは小さくもなく、LLMでもない)」と一行だけあり、構造の詳細は書かれていない。名前の由来は、Daniel Kahnemanの「速い思考(System 1)」と、効率化が需要を増やすという経済学者William Stanley Jevonsから取ったと説明している。
用途とデモ──セキュリティ警報の仕分け、Doom、Wikipediaのリンクたどり
ブログが挙げる用途は4つ。ソフトウェアの中の判断(分類、振り分け、点数付け、抽出、分岐)、大量データの仕分け、100ミリ秒級の速さが要る場面、そしてLLMのプロンプトや出力の採点・検証・ガードレールだ。評価サイトの例では、パソコンやサーバーで警報が鳴った時に、まず3つの質問(許可されていない操作か、記録で説明がつくか、証拠はどれくらい強いか)に答えさせ、コードがその確率を見て「閉じる/担当者に回す/今すぐ止める」を決め、止める場合はさらに11の質問(認証情報の流出、攻撃者のセッションの生存など)で状態を確認してから対処を選ぶ、という流れになっている。
デモは2つ。ゲームDoomをJevに操作させ、1秒に10回判定させたもので、費用は「~$7/hour(約7ドル/時)」。ただし入力は画面ではなく、ゲームの状態を文字で表したデータだと注記している。もう1つはWikipediaのリンクだけをたどって目的のページに着く「Wikiracing」で、1手ごとに数百から数千のリンクから選ぶ。こちらは相手のLLMを非推論モード(Astraのみ最低の推論設定)で走らせたため、速さの差は他のデモより小さいと同社が書いている。
筆者が原文で確かめたこと
この記事と動画のために、筆者は公式ブログをそのまま取得して読み、評価サイトの散布図に埋め込まれたデータ点(モデル名・方式・正解率・コスト・時間)を機械で抜き出して表にした。上の表の数字と、76倍・25倍の計算はそこから出している。確かめられた事実を2つ書く。1つは、評価の「正解」を作っているGPT-6 AstraとClaude Fable 5.1が散布図に載っていないこと。つまり、現時点で一番賢いとされる2つのモデルとJevの直接比較は、この評価では出ない。もう1つは、ブログのFAQの回答(新しい訓練法が要った理由、公開ベンチマークを出さない方針、学習データは全て自社製で顧客データは使わない、など)が画面上では折りたたまれていて、ページに埋め込まれたデータから読んだこと。上に引いたFAQの引用はそこから取った原文だ。
この発表で、まだ確かめられないこと
- 数字はすべてTypeSafe自身の評価。同社は「We deliberately chose not to publish performance against public benchmarks(意図的に公開ベンチマークでの性能を出さないことにした)」と書いており、本記事が確認した公式ブログと評価サイトの範囲には、第三者による測定への言及は無い。
- 評価の設計に同社が認める偏り:正解がAstraとFable 5.1の平均であるためOpenAIとAnthropicのモデルに有利で、「我々のモデルとDeepSeekのモデルの相対性能は過小評価されているだろう」と同社は書く。4つの業務も同社の担当チームが作ったもので、「some bias could exist(多少の偏りはあり得る)」としている。
- 価格の持続性:「We can't prove it isn't subsidized(補助されていないことは証明できない)」と同社が明記。今の価格が続く保証はない。
- 内部構造は非公開。「LLMではない」以上の説明は無い。
- 一般には触れない。早期アクセスは順番待ちの開発者から順で、一般提供の時期は書かれていない。
- 応答時間3〜329秒は、同社が外部の計測サイトを引用した値で、条件は当方で再検証していない。
- 動画内の「日本円で約6円」は1ドル150円での概算、「苦情メールの仕分け」と「90と出したら9割当たる」は説明用の仮の例で、同社の実データではない。
次に見るもの
- 早期アクセスの開発者による外部の測定(速さ、価格、判定の正解率)
- 一般提供の時期と価格の据え置き
- 公式ドキュメントで「決定のスキーマ」をどう書くか(分類・振り分けを自分の業務で試す時の入口)
本記事はこれらの続報があり次第更新します。
出典と数字の扱い
- 公式ブログ「Introducing System One Models & Jev」(2026年9月15日)と評価サイト evals.typesafe.ai は、2026年9月16日午前(日本時間)に取得した内容に基づく
- 表の数字は評価サイトの図に埋め込まれたデータ点から抜粋した。76倍・25倍・209倍・440倍は当方の計算(0.0304÷0.0004、10.1÷0.4、0.0836÷0.0004、0.1761÷0.0004)
- エラー率の図の数字はブログの図を目視で転記した。Jevの0%は同社が「実測ではない」とする仕様上の値
- 日本語訳は筆者によるもので、原文が正本
- 動画版: https://youtu.be/HmLK5Vr-mgc / 関連:GPT-5.6 Sol/Terra/Lunaの一般提供、Claude Fable 5.1 / Mythos 5.1、GPT-6 Astra、LLMのハルシネーションの原因と対策
出典・参照資料
この記事の解説動画
YouTubeで見る ↗AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事

OpenAI、GPT-5.6を一般提供開始──Sol・Terra・Lunaの3モデル同時投入、Fableを複数ベンチで上回る
Claude Fable 5.1公開──科学研究ベンチが24.7%から52.6%へ、価格据え置きで実質25%安
GPT-6 Astra公開──自社比較表では首位、独立指標では5位、価格はFable 5.1と同額の$10/$50
OpenAIの「Programmatic Tool Calling」──モデルがコードを書いてツールを並列実行し、中間結果を圧縮する

LLMのハルシネーション(幻覚)とは?原因と対策【2026年版】

Claude 料金・性能比較・ChatGPTとの違い【2026年最新版】
AIに打った内容は誰が見られるのか──OpenAI・Anthropic・Googleの規約原文を並べたら、3社で書き方がはっきり違った