Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
日刊AIニュース10月20日(火)号:前日のAIのニュース12本を短くまとめました(約8分)›
Hugging FaceのPyTorchチームが2026年10月20日、PyTorch 2.15のMPS(Mac向けGPU)の変更点を公開した。FP8に対応し、M3 UltraでQwen3.6-35B-A3Bの生成は9.4から61.3トークン/秒へ。Wan2.2の動画デコードのメモリは約270GiBから約8GiBに下がったと説明している。
Hugging FaceのPyTorchチームは2026年10月20日(現地日付)、PyTorch 2.15(パイトーチ)のMac向けGPUバックエンド「MPS」の変更点をまとめたブログ「MPS in PyTorch 2.15」を公開しました。同チームによると、MPSにFP8が加わり、MoE(Mixture of Experts)モデルの生成はM3 Ultraで2.14比5〜6.5倍になります。Wan2.2の動画デコードでは、メモリのピークが約270GiBから約8GiBに下がったとのことです。
3行まとめ
- Hugging FaceのPyTorchチームが、PyTorch 2.15のMPS(Mac向けGPU)の改善を公開。
torch.float8_e4m3fnが使え、F.scaled_mmで直接計算できる- M3 UltraのMoE生成は2.14比5〜6.5倍(Qwen3.6-35B-A3Bは9.4→61.3トークン/秒)。Wan2.2の動画VAEデコードはピークメモリ約270GiB→約8GiB
- MPSはmacOS 15以降、PyTorch 2.15はPython 3.11以降が必要。ブログの導入手順はリリース候補向け
本記事の内容は、日本時間10月20日20時台に公式ページで確認したものです。数字はすべてブログとプルリクエストに書かれた測定値で、当サイトが再現したものではありません。
何が速く、何が使えるようになるのか
ブログが冒頭に挙げる変更は次のとおりです。
| 項目 | 2.15での変更(ブログの記載) |
|---|---|
| FP8 | torch.float8_e4m3fn がMPSで使える。1値1バイトで、FP16やBF16の半分の容量。F.scaled_mm はtensorwiseとrowwiseのスケーリングに対応 |
| MoEの生成 | M3 Ultra+torch.compileで2.14比5〜6.5倍 |
| 線形層 | 1行入力向けの行列×ベクトルカーネルを F.linear につなぎ、実モデル由来の96のBF16形状で幾何平均1.23倍 |
| softmax | [1, 128256] のFP32で57µsから7µsに。約8倍 |
| 複素数の線形代数 | complex64のLU分解・LU solve・三角solveがMPSで動く |
| 動画デコード | Wan2.2のVAEデコードでドライバーメモリのピークが約270GiBから約8GiB |
| Python側の操作 | torch.mps.Stream などでMPSのストリームを指定できる |
MoEモデルの生成が5〜6.5倍になった理由
ブログは、M3 Ultra+torch.compileでの生成速度を次のように示しています。比較対象はPyTorch 2.14です。
| モデル | 2.14 | 2.15 |
|---|---|---|
| Qwen3.6-35B-A3B | 9.4トークン/秒 | 61.3トークン/秒 |
| LFM2.5-8B-A1B | 23.6トークン/秒 | 123.6トークン/秒 |
理由としてブログが挙げるのは、ネイティブのgrouped matmul(デコード専用の経路つき)、GPUとCPUの同期の削減、top-kルーティングの高速化です。
ブログの説明によると、2.14ではgrouped matmulがグループの境界をCPUにコピーしてグループごとにループしていました。新しいMetalカーネルはGPU上で境界を直接読みます。grouped matmulの実装を扱うプルリクエスト(#194933)のコードの注記にも、境界を読むとGPUからCPUへの同期が起きるのでそれを避ける、という趣旨が書かれています。
このプルリクエストにも生成速度の表があり、LFM2.5-8B-A1Bは23.57から60.33トークン/秒(2.56倍)、Qwen3.6-35B-A3Bは9.39から25.95トークン/秒(2.76倍)です。ブログの61.3や123.6とは数字が違います。このプルリクエストの表は「Histc only」と「Both PRs」の列を持ち、2件のプルリクエストを合わせた結果として示されています。ブログにはデコード用カーネルの効果として「約1.3倍」とも書かれています。ブログ自身が5〜6.5倍の理由を3つ挙げていることと合わせると、5〜6.5倍は1つの変更だけの効果ではないと読めます。
動画デコードのメモリが約270GiBから約8GiBになった理由
原因は定数パディングです。ブログによると、Wan-AI/Wan2.2-TI2V-5B-Diffusers のVAEデコードは、28タイルの全体で8,764回のパディング呼び出しをします。パディングをMPSGraphからMetalに移すと、ドライバーメモリのピークは270.135GiBから8.108GiBに下がりました。
一方、アロケーターが確保したピーク(8.070GiB)は変わっていません。変わったのはアロケーターの外のドライバーメモリで、パディングのプルリクエスト(#195368)の表では262.065GiBから0.038GiBです。テンソルの割り当てピークは4.422GiBから4.095GiBへ小さく減っています。
ブログは同じ修正の副産物も書いています。2.14ではQwen-Image-2.1のVAEエンコーダーがMPSで画像を壊していました(ComfyUIで報告)。2.15ではエンコードしてデコードし直した画像とCPUの結果の一致度が、PSNRで10.06dBから29.95dBになったとのことです。
誰が、いつから使えるのか
ブログが書く要件は次の2つです。
- Apple siliconのMacで、macOS 15以降(MPSの要件)
- Python 3.11以降(PyTorch 2.15の要件)
条件を満たさないOSやMetal GPUのない環境では、MPSの利用可否の確認が理由を返すようになったと書かれています。
導入手順は、試験用インデックスから入れるコマンドです。
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpu
ブログはこれを「リリース候補を別の環境で試す方法」として紹介しており、結びでも「リリース候補を試してほしい」と書いています。今回取得したページには、2.15の正式版の公開日は書かれていませんでした。
FP8については、FP8のプルリクエスト(#194074)に関連する動きがあります。このプルリクエストはマージ済みと表示され、本文の最後には「Enable compressed-tensors FP8 kernels on MPS (torch >= 2.15)」という huggingface/transformers#48985 への言及があります。同ページではMerged表示です。題名からは、transformers側でもtorch 2.15以降を前提にMPSでFP8を扱う準備が進んでいることがうかがえます(transformersのプルリクエスト本体は今回取得していません)。
前のバージョンと何が違うのか
ブログは2026年初頭の状況を、次のように説明しています。
At the start of 2026, running even small models on MPS often meant working around unsupported operations, performance cliffs and unexpected memory growth.
(訳:2026年の初めは、小さなモデルでもMPSで動かすには、未対応の演算、性能の急落、予想外のメモリ増加を回避する必要があることが多かった。)
そのうえで同チームは、Hugging Face Hubの実モデルで足りない部分を見つけ、PyTorch本体で直しており、その方法は次第にMPSGraphを専用のMetalカーネルに置き換える形が多くなっていると述べています。ブログによると、この記事の内容の多くはその取り組みの成果です。conv1dの順伝播、定数パディング、アップサンプリングの逆伝播はMPSGraphからMetalの経路へ移り、dropoutは既存の融合カーネルを使うようになったと書かれています。
PyTorch 2.16の先行紹介も載っています。ただし一部はまだレビュー中で、リリースまでに変わる可能性があるとブログ自身が断っています。数字は次のとおりです。
| 2.16の項目 | ブログの数字 |
|---|---|
| コマンドバッファを16カーネルごとにコミット(BF16、2048トークン) | LFM2.5-8B-A1B 108.8→126.0トークン/秒、Qwen3.6-35B-A3B 52.9→62.8、Qwen3.8-27B 12.1→12.6 |
| アテンションをすべてMetalに(M5 Pro) | GQAのデコードが465µsから65µs、4K×4Kのprefillが42msから6ms |
| 配布物の縮小 | libtorch_cpu.dylibが384MiBから287MiBへ約25%減 |
公式ページを確認して気づいたこと
日本時間20時台にブログを取得して読み比べたところ、冒頭の「TL;DR」が「5〜6.5倍」と書く一方、後半のデコード用カーネルの説明では「約1.3倍」と書いていました。矛盾して見えますが、前者は2.14との比較で理由が3つ挙げられており、後者はデコード用カーネルの効果として書かれています。前者は複数の変更を合わせた数字で、後者はその一部だと読めます。プルリクエスト側の表(2件合わせて2.56〜2.76倍)も、この読み方と食い違いません。
また、ブログのインストール手順がリリース候補向けの試験用URLだったことも、ページを取得して初めてわかりました。記事の見出しだけ見ると「2.15が出た」と読めますが、ブログ自身は「リリース候補」と書いています。なお、当サイトは製品を自分で試してはいません。ここまでの内容は、取得したページの記載に基づきます。
発表だけでは確かめられないこと
- 測定条件: 5〜6.5倍や270GiB→8GiBは、Hugging FaceのPyTorchチームがブログで示した数字です。MoEの生成速度はM3 Ultra+torch.compileの条件で、ほかのMacで同じ倍率になるかは書かれていません。
- グラフ: ブログには「約1.3倍」やsoftmaxの語彙サイズ別の結果の直後に図が続くとみられる箇所がありますが、今回の取得テキストには中身が入っていませんでした。「約1.3倍」の内訳モデルは確認できていません。
- 正式版の時期: 今回取得したページには、2.15の正式版の公開日の記載は見つかりませんでした。
- 2.16の内容: 一部は「レビュー中で、変更されうる」とブログが断っています。
- 対象バックエンド: この発表はMPS(Mac)の話です。CUDAなど他のバックエンドの変更は、今回の取得ページの範囲では扱われていません。
出典と確認時刻
- MPS in PyTorch 2.15 — Hugging Face公式ブログ(2026年10月20日公開、日本時間20時09分に取得)
- [MPS] Implement grouped_mm · PR #194933(日本時間20時09分に取得)
- [MPS] Migrate constant pad to metal · PR #195368(日本時間20時09分に取得)
- [MPS] Add float8_e4m3fn dtype support · PR #194074(日本時間20時09分に取得)
本記事は続報があり次第更新します。
この記事でよく聞かれること
- PyTorch 2.15のMPSでは何が変わりますか?
- Hugging FaceのPyTorchチームの公式ブログによると、MacのGPU(MPS)でFP8(float8_e4m3fn)が使えるようになります。MoEモデルの生成はM3 Ultraで2.14比5〜6.5倍になり、softmaxは約8倍、Wan2.2の動画VAEデコードのピークメモリは約270GiBから約8GiBに下がります。
- PyTorch 2.15のMPSを使うのに必要な環境は?
- 公式ブログによると、Apple siliconのMac、macOS 15以降、Python 3.11以降が必要です。macOS 15未満やMetal GPUがない環境では、MPSが使えるかの確認が理由を表示するようになったとも書かれています。
- PyTorch 2.15は正式版ですか?
- 2026年10月20日20時台(日本時間)に確認したブログの導入手順は、試験用インデックス(download.pytorch.org/whl/test/cpu)から torch==2.15.0 を入れるリリース候補向けのもので、結びでも「リリース候補を試してほしい」と書かれています。正式版の公開日は今回取得したページからは確認できていません。
- MoEモデルが5〜6.5倍速いという数字はどの条件ですか?
- 公式ブログによると、M3 Ultra上でtorch.compileを使った場合の数字で、Qwen3.6-35B-A3Bが9.4から61.3トークン/秒(約6.5倍)、LFM2.5-8B-A1Bが23.6から123.6トークン/秒(約5.2倍)です。比較対象はPyTorch 2.14です。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
ドイツ製AI「Kolibri」を手元のMacで動かした 78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
ドイツ製AI「Kolibri」を手元のMacで動かした78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
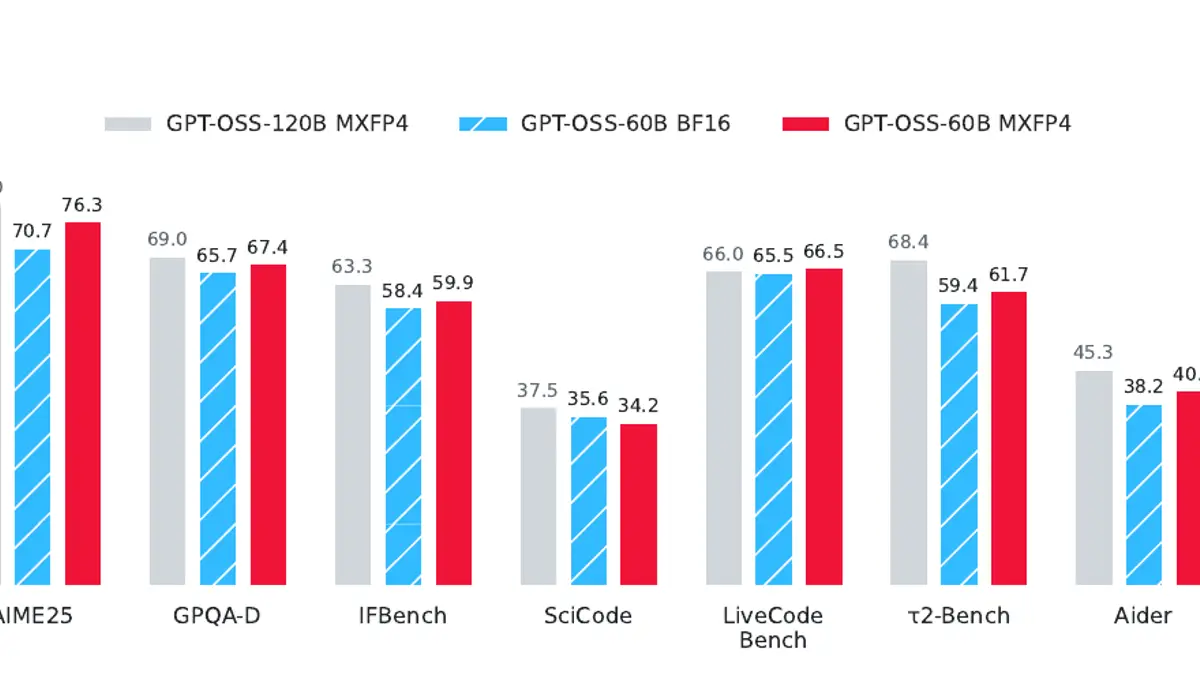
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開 LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
GGUFとMLX、Macで動かすならどっちを選ぶべきか 「ファイル形式」と「フレームワーク」を混同しないための整理
GGUFとMLX、Macで動かすならどっちを選ぶべきか「ファイル形式」と「フレームワーク」を混同しないための整理
Hugging Face「funes」 Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
Hugging Face「funes」Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
Hugging Face「@huggingface/kernels」 ブラウザ推論の土台として、207本のWebGPUカーネルを1本ずつ版つきリポジトリ(契約・WGSLテンプレート・正当性テスト・ベンチマーク)としてHubで公開(Apache 2.0)。`getKernel`でHubから直接読み込み、「Fleet」で来訪者のGPUでの正当性と速度の証拠を同意のうえで集める
Hugging Face「@huggingface/kernels」ブラウザ推論の土台として、207本のWebGPUカーネルを1本ずつ版つきリポジトリ(契約・WGSLテンプレート・正当性テスト・ベンチマーク)としてHubで公開(Apache 2.0)。`getKernel`でHubから直接読み込み、「Fleet」で来訪者のGPUでの正当性と速度の証拠を同意のうえで集める