GitHub Copilot Fusion(フュージョン)、端末内のローカルモデルとクラウドを自動で使い分ける実験的プレビューCLI・Copilotアプリ・VS Codeで、WindowsはMAI Code 1.1 Flashを管理付きでダウンロード
日刊AIニュース10月27日(火)号:前日のAIのニュース12本を短くまとめました(約8分)›
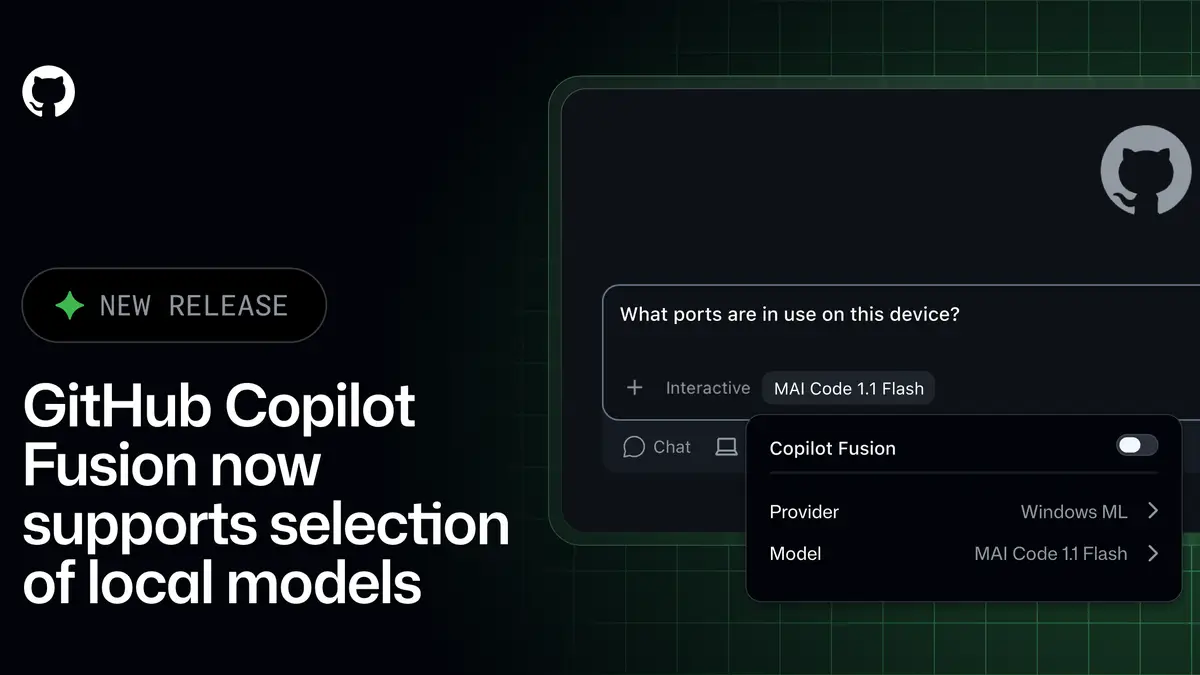
GitHubは2026年10月28日、Copilot Fusionがサポート対象の端末内モデルとクラウドモデルを選び分ける「ローカルモデルのインテリジェントルーティング」を、オプトインの実験的プレビューとして出したと発表した。対象はCopilot CLI・Copilotアプリ・VS Code。WindowsではMAI Code 1.1 FlashをWindows ML経由で管理付きでダウンロードできる。
目次
GitHubは現地時間2026年10月28日(日本時間10月29日0時30分ごろ)、Copilot Fusion(フュージョン)がサポート対象の端末内モデルとクラウドモデルを選び分ける「ローカルモデルのインテリジェントルーティング」を、実験的プレビューとして出したと発表しました。対象はGitHub Copilot CLI、GitHub Copilotアプリ、Visual Studio Codeです。オプトイン(自分で有効にした人だけが使う方式)で、GitHubは「リクエストごとに手動でモデルを切り替えずに、端末の計算資源を使える」と説明しています。
3行まとめ
- GitHubは2026年10月28日、Copilot Fusionのローカルモデル対応を実験的プレビューで開始。Copilot CLI・Copilotアプリ・VS Codeで、端末内モデルとクラウドモデルを自動で選び分ける
- Windowsでは、Windows MLプロバイダー経由でMAI Code 1.1 Flashを管理付きでダウンロード可能。Copilot CLIは手動設定のモデルならWindows・macOS・Linuxで使え、Qwen3.8 Flash Nextも設定対象
- ローカル推論でもオフラインにはならない。ルーティングの判断はクラウドで行われ、ローカルモデルはクラウド側と安全対策が異なる場合があるとGitHubは書いている
本記事の内容は、日本時間10月29日2時台にGitHub公式のChangelogページで確認したものです。
何ができるようになったのか
GitHubの発表によると、Copilot Fusionの「Standard」を選ぶと、Copilotがローカルモデルとクラウドモデルのどちらを使うかを選びます。ローカルモデルを直接選んでセッションを始めることもできます。
Fusion自体は、当サイトが先に報じた一般提供の記事のとおり、全Copilotプランで一般提供されています(今回のページには書かれていない内容で、その記事の取得時点の情報です)。段階の名前(Standard・High・Max)や割引の話も、そちらにまとめました。今回の発表は、その「Standard」の選択肢に端末内のモデルが加わる、という位置づけです。
どこで、どう有効にするのか
発表は、Windowsの対応端末で、Windows MLプロバイダー経由でMAI Code 1.1 Flashをダウンロードして設定できるとしています。入口は製品ごとに違います。
| 製品 | 有効にする手順(GitHubの記載) |
|---|---|
| Copilot CLI | 実験モード(experimental mode)を有効にし、/model を開いて表示に従ってセットアップ |
| Copilotアプリ | Settings > Model providers でWindows MLプロバイダーを設定し、Settings > Experiments で「Local model auto routing」を有効にして、新しいセッションを始める。Windows MLのローカルモデルはWindowsでは既定で有効 |
| VS Code | chat.copilot.localModel.enabled を有効にする |
モデルの準備ができたら、Copilot FusionでStandardを選ぶと、Copilotがローカルとクラウドを選びます。
自分で用意したモデルは使えるのか
管理付きのダウンロードはWindowsだけです。ただしGitHubは、Copilot CLIのローカルなFusionルーティングは、手動で設定したモデルならWindows・macOS・Linuxで動くと書いています。
- 設定できるモデルとして名前が挙がっているのは、MAI Code 1.1 FlashとQwen3.8 Flash Nextの2つです
- ローカルのOpenAI互換サーバー経由で設定します
- モデルのダウンロードと推論ランタイムは自分で管理し、端末に十分な資源が必要です
- サポート対象のローカルモデルプロバイダーとして設定し、実験的なローカルルーティングを有効にしたうえで、FusionでStandardを選びます
見落としやすい点が2つあります。1つ目は、BYOK(自分のキーを持ち込む方式)の設定でモデルを追加したり検出したりしても、それだけではFusionの対象にならないことです。発表はこれを、直近のCopilot CLIのローカルモデル検出の改善の上に積んだ機能だと説明しています。2つ目は、Copilotアプリの扱いです。アプリは互換性のあるローカルモデルをBYOKでつないで直接選ぶこともできますが、インテリジェントルーティングの対象は現時点では管理付きのWindows MLモデルだけだと書かれています。
「ローカル」でも、クラウドとつながったままです
ここは誤解しやすいところなので、発表の文言に沿って整理します。
- ローカル推論をしても、セッションはオフラインにならない
- Copilot Fusionは、ルーティングの判断を引き続きクラウドで行う
- ローカルモデルは、Copilotが提供するクラウドモデルとは安全対策が異なる場合がある
つまり「モデルの推論が端末内で動く場合がある」のであって、「すべてが端末内で完結する」わけではありません。社内規程などでデータの扱いを確認している場合は、どの処理がどこで動くかを公式ドキュメントで確かめる必要があります。
今回、他と何が違うのか
同じ10月28日のChangelogには、Fusionのルーティングとオーケストレーション、Copilotアプリ、Enterpriseなどに関する投稿が並んでいます(ページ下部の関連投稿の一覧)。今回の投稿はそのうち、ローカルモデルの選択に絞った内容です。JetBrains向けのFusionについては、JetBrains版の提供開始の記事を参照してください。Copilotアプリ側の別の新機能は、ProjectsとComputer useの記事で扱っています。
発表は、ローカルモデルのルーティングの詳細として2026年10月7日の最初の発表を挙げています。本記事はその10月7日の発表ページは取得しておらず、10月28日付のChangelogだけを根拠にしています。
日本時間2時01分に公式ページを開いて確認したこと
取得したのは、公式ChangelogのページHTMLを文字だけにしたものです。日本時間10月29日2時01分に取得した時点では、ページ本文は英語のみでした。本文には日本語の説明や日本での提供に触れた記述は見当たりません。公開時刻はページのメタデータでは太平洋夏時間の10月28日8時30分台で、日本時間では10月29日0時30分台にあたります。製品は自分では試していません。以下の内容は、すべてこのページの記載に基づいています。
料金・対応プラン・性能は、この発表からは分からない
今回取得した公式ページには、次の情報の記載がありませんでした(ページ内を検索して確認しています)。
- 実験的プレビューを使えるCopilotのプラン(Free・Pro・Business・Enterpriseなど)
- ローカルモデルを使った場合の課金やクレジットの扱い
- ローカルとクラウドをどう振り分けるかの基準、精度や速度の数字
- 日本での提供状況
ルーティングの挙動はリンク先の公式ドキュメント(intelligent routing to local models)に書かれているとされていますが、本記事ではそのドキュメントは取得していません。導入前に、ご自身のプランと環境で使えるかを公式ドキュメントで確認してください。実験的プレビューなので、仕様が変わる可能性もあります。
出典と確認時刻
- GitHub Changelog「GitHub Copilot Fusion now supports selection of local models」(2026年10月28日付): https://github.blog/changelog/2026-10-28-github-copilot-fusion-now-supports-selection-of-local-models
確認した時刻は日本時間2026年10月29日2時01分です。本記事は続報があり次第更新します。
この記事でよく聞かれること
- GitHub Copilot Fusionのローカルモデル対応とは何ですか?
- GitHubの2026年10月28日の発表によると、Copilot Fusionがサポート対象の端末内モデルとクラウドモデルのどちらかを選ぶ「インテリジェントルーティング」を、オプトインの実験的プレビューとして出しました。対象はGitHub Copilot CLI、GitHub Copilotアプリ、Visual Studio Codeです。リクエストごとに手動でモデルを切り替えなくても、端末の計算資源を使えるとGitHubは説明しています。
- ローカルモデルはどの環境で使えますか?
- GitHubの発表では、管理付きのダウンロードとセットアップはWindowsのみで、MAI Code 1.1 FlashをWindows MLプロバイダー経由で入れます。一方、Copilot CLIのローカルなFusionルーティングは、手動で設定したモデルならWindows・macOS・Linuxで動くと書かれています。Copilotアプリのルーティングは、現時点では管理付きのWindows MLモデルのみが対象です。
- ローカルモデルを使うとオフラインで使えますか?
- 使えません。GitHubの発表は、ローカル推論でセッションがオフラインになるわけではなく、Copilot Fusionはルーティングの判断を引き続きクラウドで行うと書いています。また、ローカルモデルはCopilotが提供するクラウドモデルと安全対策が異なる場合があるとも説明しています。
- 自分で用意したローカルモデルはFusionで自動的に選ばれますか?
- 自動では選ばれません。発表によると、BYOK(自分のキー)の設定でモデルを追加・検出しただけでは、Copilot Fusionの対象にはなりません。Copilot CLIでは、MAI Code 1.1 FlashまたはQwen3.8 Flash NextをOpenAI互換のローカルサーバー経由で設定し、実験的なローカルルーティングを有効にしたうえで、FusionでStandardを選ぶ手順が示されています。
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
GitHub、Markdownで書いた自動化をActionsで動かす「Agentic Workflows(エージェンティック ワークフロー)」を一般提供に Free・Team・Enterpriseが対象
GitHub、Markdownで書いた自動化をActionsで動かす「Agentic Workflows(エージェンティック ワークフロー)」を一般提供にFree・Team・Enterpriseが対象
GitHub Copilot(コパイロット)アプリに「security extension」 コードスキャンの警告を一覧し、Copilotに説明・修正させられる(パブリックプレビュー)
GitHub Copilot(コパイロット)アプリに「security extension」コードスキャンの警告を一覧し、Copilotに説明・修正させられる(パブリックプレビュー)
GitHub Copilot(コパイロット)、JetBrains IDEでAutoに代わる「Copilot Fusion」を提供開始 ローカルサンドボックスと次の編集提案(NES)は一般提供に
GitHub Copilot(コパイロット)、JetBrains IDEでAutoに代わる「Copilot Fusion」を提供開始ローカルサンドボックスと次の編集提案(NES)は一般提供に
VS Code の GitHub Copilot(コパイロット)、クラウドセッションをスマホ・github.com・CLIから続行可能に Agent Host(エージェントホスト)とcomputer useも追加
VS Code の GitHub Copilot(コパイロット)、クラウドセッションをスマホ・github.com・CLIから続行可能にAgent Host(エージェントホスト)とcomputer useも追加
GitHub Copilot(コパイロット)、権限の確認をLLMが判定する「Assisted permissions」を一般提供 「明らかに安全」と判定した要求だけ自動で通る
GitHub Copilot(コパイロット)、権限の確認をLLMが判定する「Assisted permissions」を一般提供「明らかに安全」と判定した要求だけ自動で通る
GitHub Copilot(コパイロット)、Microsoft Teams向けの新GitHubアプリを公開 通知への返信で@GitHubがバグ修正やプルリクエスト作成まで、旧アプリは11月16日に廃止
GitHub Copilot(コパイロット)、Microsoft Teams向けの新GitHubアプリを公開通知への返信で@GitHubがバグ修正やプルリクエスト作成まで、旧アプリは11月16日に廃止
GitHub Copilot(コパイロット)、Visual Studio 2026の9月アップデートを公開 プルリクエストの要約、BYOMのプレビュー、NuGet脆弱性のAI修正。BYOMは旧Ask・Agentでは使えなくなる
GitHub Copilot(コパイロット)、Visual Studio 2026の9月アップデートを公開プルリクエストの要約、BYOMのプレビュー、NuGet脆弱性のAI修正。BYOMは旧Ask・Agentでは使えなくなる