
音声AI・文字起こしの記事
「音声AI・文字起こし」に関連するAIニュースと解説、26本。新しい順に並べています。
音声AI・文字起こし の記事:26件
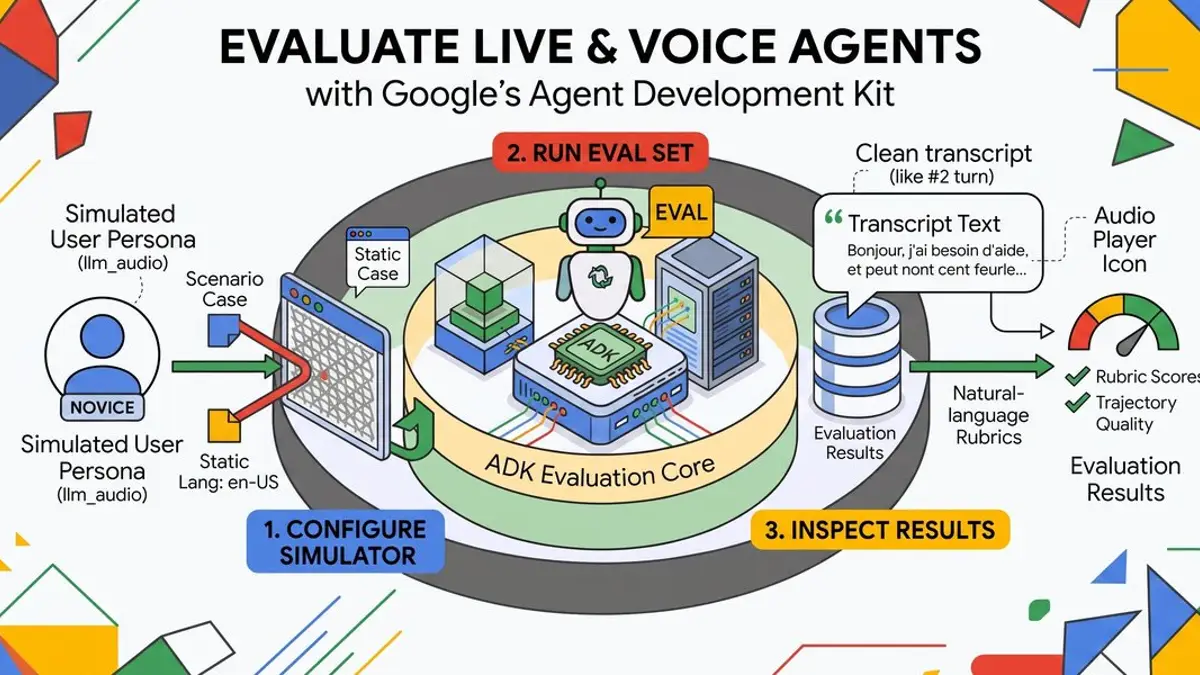
Google ADKに「ライブ・音声エージェントの評価」 模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
Google ADKに「ライブ・音声エージェントの評価」模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
検証
Google、Gemini 3.8 Flash TTSと3.8 Flash-Lite TTSを発表 9/15公開の3.8 Liveとは別の読み上げ専用モデル、既製の声は2,000種類超、音声出力は10秒$0.0015〜$0.00225(2026年内)
Google、Gemini 3.8 Flash TTSと3.8 Flash-Lite TTSを発表9/15公開の3.8 Liveとは別の読み上げ専用モデル、既製の声は2,000種類超、音声出力は10秒$0.0015〜$0.00225(2026年内)
モデル
Googleが「300言語超・70億人・世界人口の86%」と数字を出した言語AIの現在地 Gemini 3.5 Live Translateは70言語・2,000超の言語ペア、目標は「話者数上位1,000言語」、端末内翻訳TranslateGemmaは55言語、フィーチャーフォンでもGemini
Googleが「300言語超・70億人・世界人口の86%」と数字を出した言語AIの現在地Gemini 3.5 Live Translateは70言語・2,000超の言語ペア、目標は「話者数上位1,000言語」、端末内翻訳TranslateGemmaは55言語、フィーチャーフォンでもGemini
研究
OpenAI、全二重の音声モデル「GPT-Live-1」をAPIで提供 1分$0.05(秒単位課金)の会話層に、推論とツールはGPT-6 Astraなど後ろのモデルへ委任。Full Duplex BenchでGPT-Realtime-2.1より30ポイント上、電話(SIP)対応、声は12種類
OpenAI、全二重の音声モデル「GPT-Live-1」をAPIで提供1分$0.05(秒単位課金)の会話層に、推論とツールはGPT-6 Astraなど後ろのモデルへ委任。Full Duplex BenchでGPT-Realtime-2.1より30ポイント上、電話(SIP)対応、声は12種類
プロダクト
 動画
Alibaba、Qwen3.8-Omni-Flashを発表 音声1時間の入力が1セント未満、会議の文字起こしはDER 88.1→3.4、Gemini 3.8 Flashに音声で上・動画推論で下、重みは非公開
Alibaba、Qwen3.8-Omni-Flashを発表音声1時間の入力が1セント未満、会議の文字起こしはDER 88.1→3.4、Gemini 3.8 Flashに音声で上・動画推論で下、重みは非公開
モデル
Gemini 3.8 Liveと3.8 Live Extended Thinking公開 話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位、音声は1分あたり入力$0.005・出力$0.018
Gemini 3.8 Liveと3.8 Live Extended Thinking公開話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位、音声は1分あたり入力$0.005・出力$0.018
モデル
ByteDanceが「見ながら聞きながら話す」全二重AIを実運用投入 音声だけのGPT系リアルタイムAIとの違いはどこにあるか
ByteDanceが「見ながら聞きながら話す」全二重AIを実運用投入音声だけのGPT系リアルタイムAIとの違いはどこにあるか
モデル
RedNoteのdots3-noteをllama.cppがサポート 280Bのマルチモーダル、動くのは16B、Apache 2.0
RedNoteのdots3-noteをllama.cppがサポート280Bのマルチモーダル、動くのは16B、Apache 2.0
モデル
5分のフル楽曲を生成するMiniMax Music 3、重みが公開 8B+0.6Bの2段構えLLMとFlow Matchingで歌詞から曲を作る
5分のフル楽曲を生成するMiniMax Music 3、重みが公開8B+0.6Bの2段構えLLMとFlow Matchingで歌詞から曲を作る
モデル
grok-voice-latestが裏側でThink Fast 2.0に切り替わった日 8月5日、気づかれずに起きたルーティング変更
grok-voice-latestが裏側でThink Fast 2.0に切り替わった日8月5日、気づかれずに起きたルーティング変更
モデル
OpenAIが「4o」を外した文字起こしモデルを投入 GPT Transcribe・GPT Live Transcribeの料金と対応範囲
OpenAIが「4o」を外した文字起こしモデルを投入GPT Transcribe・GPT Live Transcribeの料金と対応範囲
プロダクト
Sunoが9月3日からダウンロード数に上限 旧モデル全廃も予告、公式ブログ4本で確認する変更点
Sunoが9月3日からダウンロード数に上限旧モデル全廃も予告、公式ブログ4本で確認する変更点
プロダクト
diffusersの「Modular Diffusers」が実験段階を卒業 新モデルは既に旧来パイプラインを持たずModular専用で配布される
diffusersの「Modular Diffusers」が実験段階を卒業新モデルは既に旧来パイプラインを持たずModular専用で配布される
検証
Gemini 3.5 Transcribeが正式提供 85言語以上を自動判定・話者最大8人分離を料金表で確認する
Gemini 3.5 Transcribeが正式提供85言語以上を自動判定・話者最大8人分離を料金表で確認する
プロダクト
IBMの音声認識モデル「Granite Speech 5.0 TurboCTC」 470Mでデコーダなし、1フォワードパスで文字起こし
IBMの音声認識モデル「Granite Speech 5.0 TurboCTC」470Mでデコーダなし、1フォワードパスで文字起こし
モデル
ElevenLabsが画像・動画生成APIに進出、ローカルMCPは廃止 changelogで確認する8月の3つの変更
ElevenLabsが画像・動画生成APIに進出、ローカルMCPは廃止changelogで確認する8月の3つの変更
プロダクト
音声やYouTubeリンクをピアノ譜に変換するpianoify 『Muscriptor』公開インスタンスの中身
音声やYouTubeリンクをピアノ譜に変換するpianoify『Muscriptor』公開インスタンスの中身
検証
動画のPikaが音声4モデルを一挙公開 「ElevenLabsの9倍安い」という自己申告の中身
動画のPikaが音声4モデルを一挙公開「ElevenLabsの9倍安い」という自己申告の中身
プロダクト
話し言葉を整った文章に変換するGoogleの新AI「Eloquent」 サブスクなし・オフライン動作の音声入力アプリ
話し言葉を整った文章に変換するGoogleの新AI「Eloquent」サブスクなし・オフライン動作の音声入力アプリ
プロダクト
Suno対GEMA、独ミュンヘン地裁がGEMA勝訴 AI音楽著作権訴訟でヨーロッパ初の判断
Suno対GEMA、独ミュンヘン地裁がGEMA勝訴AI音楽著作権訴訟でヨーロッパ初の判断
業界
OfflineでもParakeet TDT V3が使えるLinuxネイティブ音声入力ツール「hyprwhspr」
OfflineでもParakeet TDT V3が使えるLinuxネイティブ音声入力ツール「hyprwhspr」
検証
Sesameの「インテリジェント・アイウェア」 Oculus共同創業者が2027年に投入するAIメガネで、今わかっていること
Sesameの「インテリジェント・アイウェア」Oculus共同創業者が2027年に投入するAIメガネで、今わかっていること
プロダクト
Microsoft、Build 2026で自社初の推論モデル「MAI-Thinking-1」を発表
Microsoft、Build 2026で自社初の推論モデル「MAI-Thinking-1」を発表
モデル
 動画
AI業界が72時間で"声"に集中投下 Anthropic・OpenAI・Googleが動いた3日間を一次資料で確認した
AI業界が72時間で"声"に集中投下Anthropic・OpenAI・Googleが動いた3日間を一次資料で確認した
業界