Alibaba、Qwen3.8-Omni-Flashを発表──音声1時間の入力が1セント未満、会議の文字起こしはDER 88.1→3.4、Gemini 3.8 Flashに音声で上・動画推論で下、重みは非公開
AlibabaのQwenチームが2026年9月18日、文章・画像・音声・動画を入力して文章で返すQwen3.8-Omni-Flashと、会話用のQwen3.8-Omni-Flash-Realtimeを発表しました。価格は入力0.15ドル・出力0.47ドル(100万トークンあたり・QwenCloud国際価格)、公式の推計では音声1時間の入力が1セント未満です。公式表では会議音声の話者取り違え率(AliMeeting DER)が前世代の88.1から3.4に下がり、Gemini 3.8 Flashとの比較では音声系で上、音声付き動画の推論では下でした。重みは公開されていません。
目次
2026年9月18日昼・日本時間時点の情報です。AlibabaのQwenチームが9月18日、Qwen3.8-Omni-Flashを発表しました。文章・画像・音声・動画を入力して文章で返すモデルで、コンテキストは100万トークンです。同時に、カメラとマイクを繋いだまま会話するQwen3.8-Omni-Flash-Realtimeと、オープンソースの周辺ツール2つ(Qwen-MM-PluginsとQwen-Live Harness)が発表されています。モデル本体の重みは公開されておらず、提供はAPIです。
動画版も公開しています: https://youtu.be/3x8tkXi265k
3行まとめ
- 価格は入力0.15ドル・出力0.47ドル(100万トークンあたり・QwenCloud国際価格)。公式の推計では音声1時間の入力が1セント未満、音声付き動画は1時間0.20ドル。前世代Qwen3.5-Omni-Plus比で音声は98%超、音声付き動画は93%超の値下げと公式は書いている。
- 公式表で一番動いたのは複数話者の会議の文字起こし。AliMeetingの話者取り違え率DERが前世代の88.1から3.4、単語誤り率cpWERが89.6から17.2に下がった。Gemini 3.8 Flashは72.6/53.1。
- Gemini 3.8 Flashとの比較は音声系で上、音声付き動画の推論で下(公式の自己申告)。テキスト性能の比較相手はClaude-Opus-4.6(Max)で、Opus 5やFable 5.1との比較は表にない。
何が出たのか
| 項目 | 内容(出典) |
|---|---|
| 公開日 | 2026年9月18日(公式ブログ) |
| モデル | Qwen3.8-Omni-Flash(入力=文章・画像・音声・動画/出力=文章のみ)。会話用にQwen3.8-Omni-Flash-Realtime(WebSocket/WebRTC)(公式ブログ) |
| 土台 | Qwen3.8-Flash-Nextアーキテクチャ(QwenCloudモデルページ) |
| コンテキスト | 100万トークン。最大入力991K/最大出力131K(QwenCloudモデルページ) |
| 推論の深さ | reasoning_effort を xhigh(既定)/medium/low で指定。preserve_thinking は既定で有効(公式ブログ) |
| API | OpenAI互換のChat CompletionsとResponsesに対応。接続先は北京かシンガポール(公式ブログ) |
| 提供地域 | 中国(北京)・シンガポール・香港・東京・フランクフルト・バージニア(Alibaba Cloud Model Studio) |
| 重み | Hugging Face/ModelScopeへのリンクは公式ブログに無い。オープンソースなのは周辺のQwen-MM-Plugins(Apache-2.0)とQwen-Live Harness(筆者確認・後述) |
公式ブログは今回の狙いをこう書いています。
Today, we are launching Qwen3.8-Omni-Flash, our next-generation native omnimodal model. Its core objective is to strengthen agent capabilities in real-world productivity scenarios, advancing omnimodal models from "understanding omnimodal content" to "planning tasks, calling tools, and completing creative work." (本日、次世代のネイティブなオムニモーダルモデルQwen3.8-Omni-Flashを公開する。核となる目的は、実務の場面でのエージェント能力の強化であり、オムニモーダルモデルを「オムニモーダルな内容を理解する」から「タスクを計画し、ツールを呼び、創作作業を完了する」へ進めることだ)
価格──音声1時間の入力が1セント未満(公式推計)
QwenCloudのモデルページ(国際価格)では、入力0.15ドル・出力0.47ドル、暗黙キャッシュに当たった入力0.016ドル(いずれも100万トークンあたり)です。
公式ブログの比較図は、テキストのトークン単価に加えて「音声1時間」「音声付き動画1時間」の入力単価を並べています。
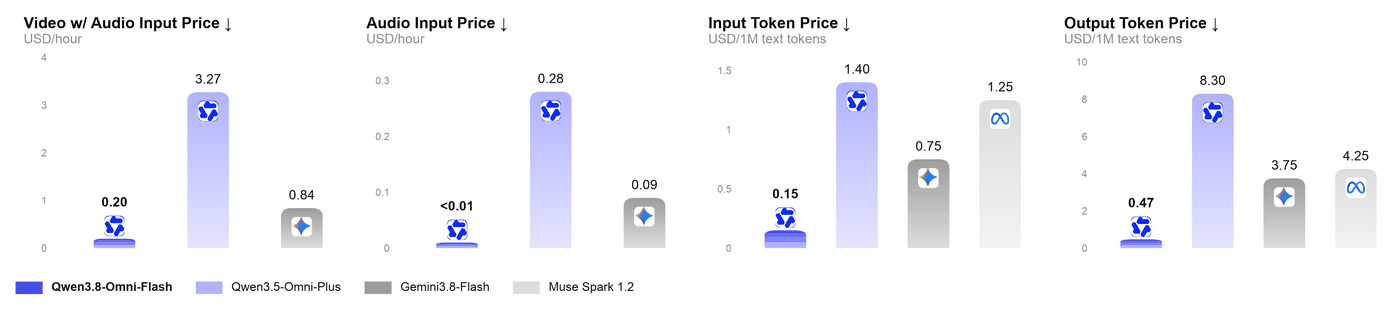
| 単価 | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| 音声1時間の入力 | 1セント未満 | 0.28ドル | 0.09ドル |
| 音声付き動画1時間の入力 | 0.20ドル | 3.27ドル | 0.84ドル |
| 入力(100万テキストトークン) | 0.15ドル | 1.40ドル | 0.75ドル |
| 出力(100万テキストトークン) | 0.47ドル | 8.30ドル | 3.75ドル |
時間あたりの単価は公式の推計で、脚注に条件が書かれています。2分の素材の入力コストを30倍して1時間に換算、動画は720p・毎秒1フレーム、Gemini 3.8 Flashは media_resolution=high の設定です。実際の請求は使い方で変わります。図にはMuse Spark 1.2の値(入力1.25ドル・出力4.25ドル)も載っています。
会議の文字起こし──DER 88.1から3.4へ
公式のベンチマーク表で桁が変わったのが、複数の人が喋る会議音声の認識です。中国語の会議データAliMeetingで、話者の取り違え率DERが3.4、単語誤り率cpWERが17.2でした(低いほど良い)。前世代のQwen3.5-Omni-Plusは88.1/89.6、Gemini 3.8 Flashは72.6/53.1です。
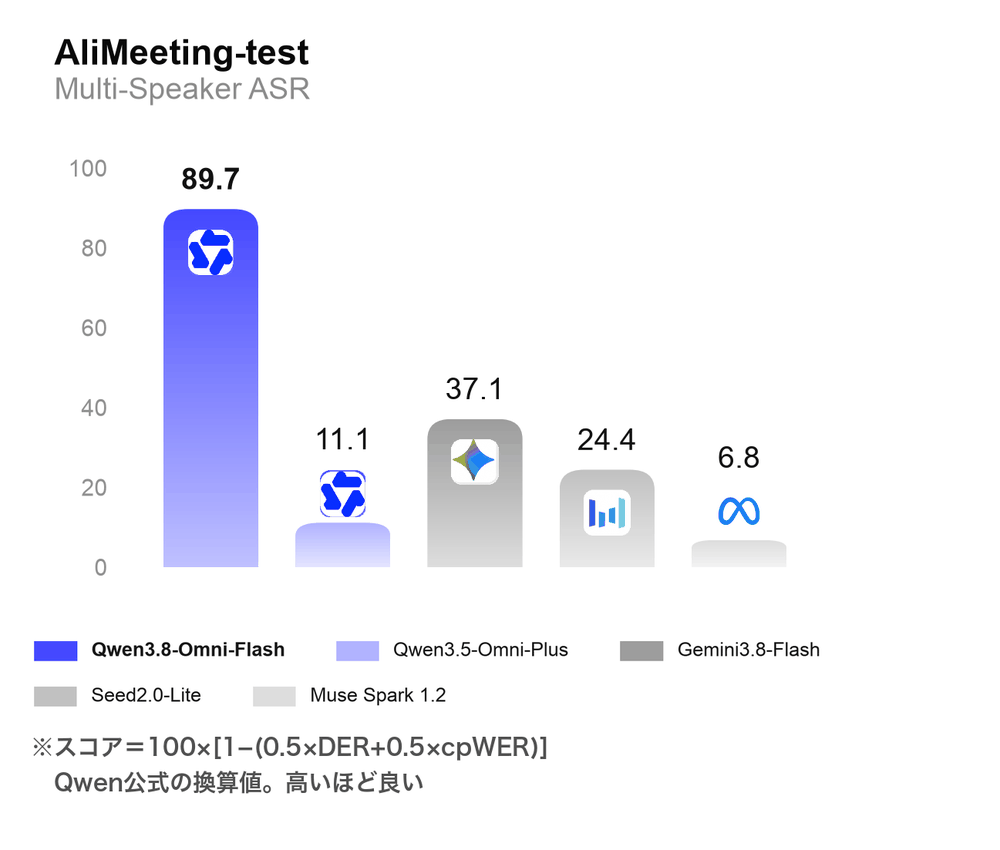
公式の比較図では、2つの誤り率を 100×[1−(0.5×DER+0.5×cpWER)] で1つの点数に換算しており、Qwen3.8-Omni-Flashが89.7、Gemini 3.8 Flashが37.1、前世代が11.1です。
| データセット | Qwen3.8-Omni-Flash | Qwen3.5-Omni-Plus | Gemini 3.8 Flash |
|---|---|---|---|
| AliMeeting(中国語会議) | 3.4 | 17.2 | 88.1 | 89.6 | 72.6 | 53.1 |
| AISHELL-4 | 2.8 | 11.2 | 100.0 | 100.0 | 66.4 | 56.9 |
| MagicData-RAMC | 5.7 | 14.1 | 98.4 | 97.1 | 67.9 | 33.8 |
| MLC-SLM(英語) | 4.0 | 14.2 | 68.6 | 63.9 | 60.8 | 26.6 |
(DER | cpWER。いずれも公式表の自己申告値)
公式ブログの説明では、1時間までの会議動画を丸ごと入れて、話者分離・文字起こし・映像による人物の照合を一度に行い、参加者の関係図、議事録、やること一覧、プロジェクトのリスクの洗い出しを出す例が挙がっています。ツール利用と組み合わせれば、会議の内容からメールを送る、タスクを整理する、コードを書き始める、まで進むとも書いています。
Gemini 3.8 Flashに勝った項目、負けた項目
公式表の比較相手はQwen3.5-Omni-Plus・Gemini 3.8 Flash・Seed 2.0 Lite・Muse Spark 1.2の4つです。Gemini 3.8 Flashとの差が出た行を抜き出します。
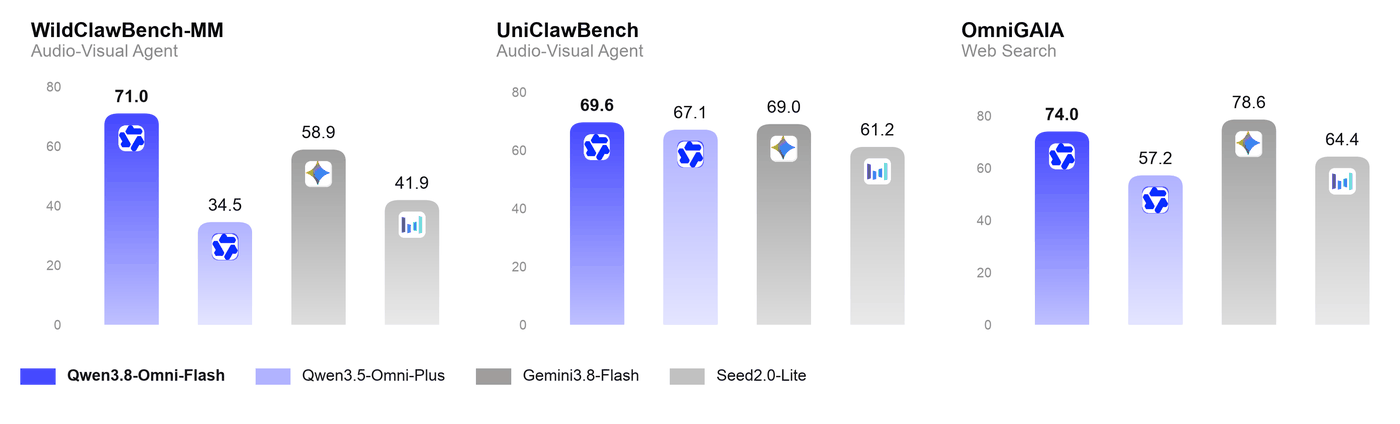
| ベンチマーク | Qwen3.8-Omni-Flash | Gemini 3.8 Flash | 勝敗 |
|---|---|---|---|
| WildClawBench-MM(音声映像エージェント) | 71.0 | 58.9 | 勝ち |
| UniClawBench(音声映像エージェント) | 69.6 | 69.0 | ほぼ並び |
| OmniGAIA(Web検索) | 74.0 | 78.6 | 負け |
| AgenticVBench(音声映像エージェント) | 36.8 | 45.0 | 負け(前世代14.5から22.3点上昇) |
| StreamingBench(音声映像インタラクション) | 80.8 | 79.9 | 勝ち |
| OmniVideoBench(音声映像推論) | 63.4 | 65.2 | 負け |
| Video-MME-v2(音声映像推論) | 65.0 | 71.0 | 負け |
| LVOmniBench(長尺動画推論) | 63.3 | 70.7 | 負け |
| LongAudioSpan(長尺音声推論・正答率) | 82.7 | 79.3 | 勝ち |
| SpotSoundBench(音の位置特定) | 67.2 | 39.7 | 勝ち |
| MuchoMusic-RUL/HumMusQA/MusTBench(音楽理解) | 72.6/75.8/50.6 | 53.7/71.2/40.3 | 勝ち |
公式ブログ自身の位置づけはこうです。
By scaling data, context, and agentic environments, Qwen3.8-Omni-Flash achieves audio-visual performance close to Gemini 3.8 Flash and overall audio performance that exceeds Gemini 3.8 Flash. (データ・コンテキスト・エージェント環境をスケールさせることで、Qwen3.8-Omni-FlashはGemini 3.8 Flashに近い音声映像性能と、Gemini 3.8 Flashを上回る音声性能全体を達成した)
表の脚注には評価条件があります。WildClawBench-MMはClaude Code、UniClawBenchはOpenClawをハーネスとして動かした結果で、OmniGAIAはハーネス無しです。公式は29個の評価の平均でQwen3.5-Omni-Plus比25%以上の改善とも書いていますが、その29個には上の会議音声のように桁が変わった項目が含まれます。
全部を読まずに探しに行く──エージェント型の動画理解
今回、数時間の動画を頭から全部処理するのではなく、質問から逆算してどこを見て聞くかをモデル自身が決め、粗く探してから細かく見る「エージェント型」の理解が入りました。公式の数字は次のとおりです。
| OmniVideoBench | 静的理解 | エージェント型理解 |
|---|---|---|
| 正答率(高いほど良い) | 63.4 | 67.8 |
| 1問あたりトークン(低いほど良い) | 145,736 | 79,117(−45.7%) |
公式はGemini 3.8 FlashにもQwen Codeというハーネスで同じ仕組みを当てて比べています。
| ベンチマーク | Qwen 静的 | Qwen+Qwen Code | Gemini 3.8 Flash 静的 | Gemini+Qwen Code |
|---|---|---|---|---|
| OmniVideoBench | 63.4 | 67.8 | 65.2 | 70.1 |
| Video-MME-v2 | 65.0 | 71.3 | 71.0 | 72.7 |
| LVOmniBench | 63.3 | 73.6 | 70.7 | 70.7 |
長尺動画のLVOmniBenchだけは、Geminiが70.7のまま動かず、Qwen3.8-Omni-Flashが73.6で逆転しています。
公式デモ4本と「モデルがモデルを鍛える」
公式ブログに載っているデモは、いずれも一文の指示から成果物までをエージェントが通す形です(当サイトは手元で動かしていません)。
- 映画の解説動画: 1時間52分34秒の映画を渡して、9分13秒の解説動画を出す(図1の時刻表示)。長尺理解・山場の抽出・解説の構成・ナレーションと音楽・編集・書き出し・検品までを含む
- 短編ドラマの翻訳: 中国語ドラマを英語版に。話者別の認識、会話としての翻訳、声のクローンによる吹き替え、音の混ぜ直し、検品
- Music2MV: 曲の構成・リズム・雰囲気・歌と楽器の変化から登場人物と場面とカットを設計。歌詞は行ごとにタイムスタンプ付きで出力
- Video2Note/Omni Skill Creator: 動画チュートリアルを手順・代表フレーム・文章入りのPDFノートにする。作業の録画から手順書を抜き出し、エージェントが再利用できるSkill.mdにする。いずれもQwen-MM-Pluginsの中でオープンソース
もう1つ、モデル開発そのものをやらせたデモがあります。Qwen3.8-Omni-Flashに「Qwen2.5-Omni-3Bの四川方言の音声認識を12時間で改善して使えるモデルを出せ」と頼み、評価セットの選定、基準の設定、音声を聞いての診断、狙った学習データ3,413例の作成、4ラウンドの学習と失敗時のロールバックまでを自律で回した、と公式は書いています。
Qwen2.5-Omni-3B's character error rate on the same evaluation set ultimately fell from 25.79% to 15.30%, a relative reduction of approximately 40.7%. (同じ評価セットでのQwen2.5-Omni-3Bの文字誤り率は最終的に25.79%から15.30%に下がり、相対で約40.7%の削減となった)
Claude CodeやCodexに差せるQwen-MM-Plugins
Qwen-MM-Pluginsはエージェント用のプラグイン集で、対応ハーネスはCodex・Claude Code・Qwen Code・Gemini CLI・Qoder・CodeBuddy・OpenClawの7つです。中身は6つあります。
| プラグイン | できること(公式表) |
|---|---|
| core | 画像・動画フレーム・PDF・Office文書・コード・データ・3Dファイルを読む |
| api | 画像理解・OCR・物体位置・音声動画の文字起こし・話者分離・イベント分析・画像分割 |
| omni-chatcut | MV制作・長編映画の解説・動画の音声翻訳 |
| omni-video2note | 動画チュートリアルをスクリーンショット付きPDFノートに |
| omni-skill-creator | 説明動画・画面録画・操作実演をSkill.mdに |
| omni-memory | 長尺動画の人物・会話・音・出来事の記憶 |
入れ方は2通りで、使っているエージェントに「このリポジトリからcore・api・omni系のプラグインを入れて」と一文で頼むか、公式のインストーラを1行走らせるかです。モデルの呼び出しにはQwenのAPIキー(環境変数 DASHSCOPE_API_KEY)が要ります。
公式資料の中で筆者が見つけた食い違い
この記事を書いている筆者は、9月18日昼に公式ブログ本文・比較図・図1・QwenCloudのモデルページ・Alibaba Cloud Model Studioのヘルプ・GitHub APIを順に確認しました。その過程で見つけたものです。
- 自己進化デモの数字が本文と図で違う。本文は25.79%→15.30%(相対−40.7%)、公式図1の結果パネルは25.79→15.52(−39.8% relative)と書かれています。どちらが正しいかは分かりません。本記事は本文の値を採り、図の値も併記します。
- 図1の結果パネルに「Qwen4-Next reference 14.81」という参照名がある。本文には一度も出てこない名前で、何を指すかは未確認です。
- Qwen-Live HarnessのGitHubリンクが404。公式ブログはgithub.com/QwenLM/Qwen-Live-Harnessにリンクしていますが、12:33(日本時間)の時点でGitHub APIは404を返しました。Qwen-MM-Pluginsの方は公開されています(Apache-2.0)。
まだ無いもの4点
- Realtime版の価格。QwenCloudのモデルページもAlibaba Cloud Model Studioのリアルタイムのヘルプも、この時点ではQwen3.8-Omni-Flash-Realtimeの価格を載せていません(ヘルプの最新記載はQwen3.5-Omni-Realtime)。
- Opus 5・Fable 5.1との比較。テキスト性能の表の相手はQwen3.8-Flash・Qwen3.8-27B・Qwen3.7-Plus・DeepSeek-V4-Flash-0731・Claude-Opus-4.6(Max)で、1世代前のClaudeが最上位です。
- 第三者の独立ベンチ。表の数字はすべてQwenの自己申告で、エージェント系はハーネスに依存します。
- Realtime版の「音の方向と距離で目標を探せる初のオムニモーダルモデル」の裏付け。公式ブログの自称で、比較データは載っていません。
本記事は続報があり次第更新します。
関連記事
出典・参照資料
この記事の解説動画
YouTubeで見る ↗AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事
AlibabaがQwen4の仕組みを先行公開──Qwen3.8-Flash-Next、動くのは6Bで最上位級の性能

Alibabaが最上位「Qwen3.8-Max」を発表──2.4兆パラメータの重みを来週公開。ベンチ86行を全部数えた
Google、Gemini 3.8 Flashと3.8 Flash Cyberを発表──6週間で3本目のFlash、Opus 5の7分の1の値段で金融・法務・長尺動画のベンチは上、汎用エージェントは19.1%対51.8%
DeepSeek-V4.1-Flash公開──出力100万トークン0.6ドル、KVキャッシュは1トークン890バイト
テンセントのHy4 previewはClaude Haikuより安い──公開ベンチ46行を数えたらKimi K3と23勝22敗だった
Gemini 3.8 Liveと3.8 Live Extended Thinking公開──話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位、音声は1分あたり入力$0.005・出力$0.018
GPT-6 Astra vs Claude Fable 5.1 比較──同じ$10/$50で何が違うか。公式ベンチの突合・独立指標・プラン別に使える条件・キャッシュ単価の4倍差を1枚に
