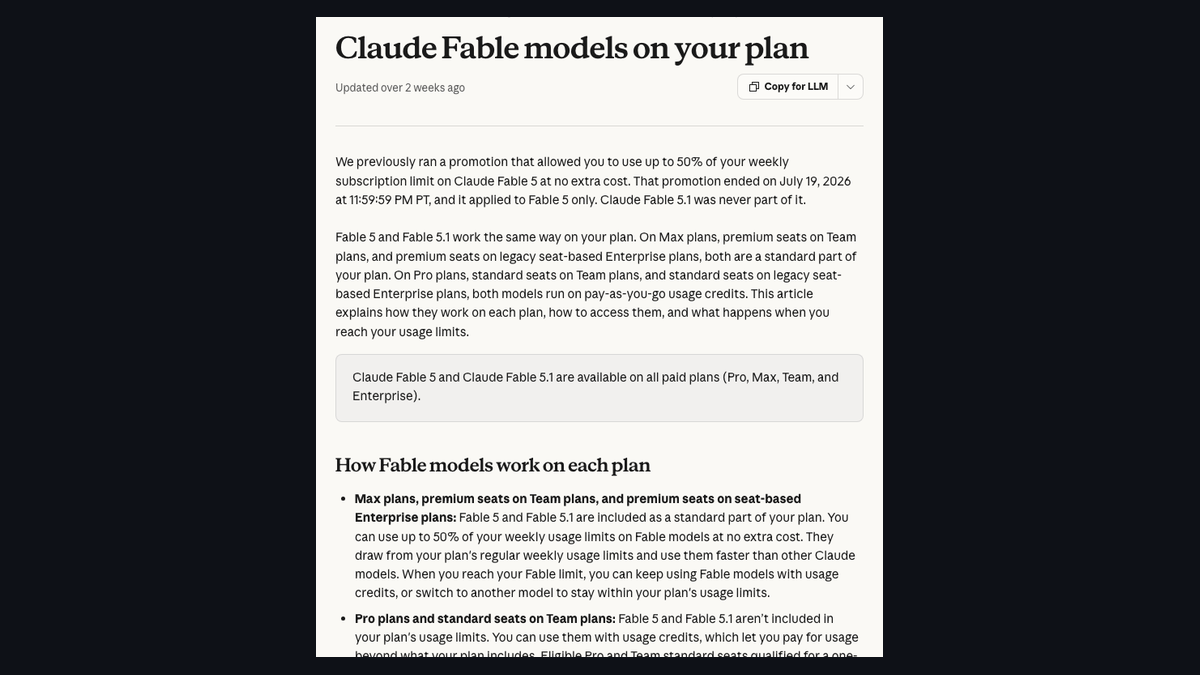
GPT-6 Astra vs Claude Fable 5.1 比較──同じ$10/$50で何が違うか。公式ベンチの突合・独立指標・プラン別に使える条件・キャッシュ単価の4倍差を1枚に
2026年9月に2日違いで出たOpenAIのGPT-6 AstraとAnthropicのClaude Fable 5.1を、両社の公式ページ・料金ページ・ヘルプの記載だけで突き合わせた。API価格は入力$10・出力$50で同額だが、キャッシュ読み込みはAstra $1.00に対しFable 5.1は$0.25で4倍の差。OpenAIの比較表ではAstraが科学研究64.6%対52.6%など多くの行で上、同じ表のArtificial Analysis指数ではFable 5.1が65.7対61.2で上。Fable 5.1の数字は両社の表で4行が一致している。ChatGPT Plusでは Work・Codexだけ、Claude Proでは従量クレジット、という「どのプランで使えるか」の違いと、筆者が9月5日に同じ課題を両方へ振ったときの使い分けも書く。
目次
2026年9月17日・日本時間時点の情報です。 2026年9月1日にAnthropicがClaude Fable 5.1を、その2日後の9月3日にOpenAIがGPT-6 Astraを出した(いずれも米国時間)。API価格はどちらも入力$10・出力$50(100万トークンあたり)で、真正面からぶつかる2本になった。この記事は、両社の公式ページ・料金ページ・ヘルプに書かれている数字だけで、「性能はどう違うのか」「同じ$10/$50で本当に同じ費用なのか」「自分のプランで使えるのか」の3つを突き合わせる。速報時の詳細はGPT-6 Astra公開とClaude Fable 5.1公開にあり、本記事はその2本をまたいで1枚にまとめ直したものである。
3行まとめ
- 公式ベンチは物差しで逆転する。 OpenAIの比較表ではAstraが科学研究のTerminal-Bench Science 64.6%対52.6%、業務自動化のAutomationBench 41.4%対31.4%など多くの行で上。同じ表に載ったArtificial AnalysisのIntelligence IndexはFable 5.1 65.7対Astra 61.2、Humanity's Last Exam(ツールあり)は65.0%対57.2%でFable 5.1が上。Fable 5.1の数字は、OpenAIの表とAnthropicの表で4行が一致している。
- トークン単価は同じ$10/$50でも、キャッシュ読み込みが4倍違う。 Astraは$1.00、Fable 5.1は$0.25。Astraは入力27.2万トークンを超えると入力2倍・出力1.5倍になり、Fable 5.1は100万トークンの全域が標準単価。知識カットオフはAstraが2026年4月30日、Fable 5.1が2026年6月。
- 使えるプランの形が違う。 ChatGPT Plus($20)はWorkとCodexだけでChatでは使えず、Pro $100/$200ならChatで「GPT-6 Pro」として週50通/200通。Claudeは無料プランで不可、Pro($20)は従量の使用量クレジット、Max 5x/20x($100/$200)は週間上限の50%まで標準搭載、と料金ページに書かれている。
まず1枚の表──公式資料の記載を並べる
| 項目 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 公開日(米国時間) | 2026年9月3日 | 2026年9月1日 |
| API価格(入力/出力・100万トークン) | $10/$50 | $10/$50 |
| キャッシュ読み込み | $1.00 | $0.25 |
| キャッシュ書き込み | $12.50 | $12.50(5分)/$20(1時間) |
| Batch | $5/$25(Flexも同額) | 50%オフ(料金ページの記載) |
| 長い入力の扱い | 27万2,000トークン超は入力2倍・出力1.5倍(そのリクエスト全体) | 100万トークンの全域が標準単価 |
| コンテキストウィンドウ | 105万トークン(最大入力92万2,000) | 100万トークン |
| 最大出力 | 12万8,000トークン | 12万8,000トークン |
| 知識カットオフ | 2026年4月30日 | 2026年6月 |
| effort(思考量)の段階 | low/medium/high/xhigh/max | low/medium/high/xhigh/max(既定はhigh・思考は常時オン) |
| 速いモード | Fast(最大2.5倍速・価格2倍) | 記載を確認していない |
| 安全装置が仕事を止めるとき | ChatGPT・Codexでは確認して続行、APIではそこで停止 | 遮断された依頼は既定でOpusに切り替えて答え直す(切り替えない設定あり) |
出典は、AstraがOpenAIのモデルページとAPI料金ページ、Fable 5.1がAnthropicの公式ドキュメントと料金ページ(9月17日取得)。
公式ベンチの突合──Fable 5.1の数字は両社の表で4行が一致する
OpenAIの公式ページの比較表にはClaude Fable 5.1の列があり、AnthropicのページはAstraより2日早く出ているのでAstraの列は無い。そこで、OpenAIの表に載ったFable 5.1の値と、Anthropicの表に載ったFable 5.1の値を横に並べる。両社が同じ数字を出している行は、比較の土台として使いやすい。
| ベンチマーク | GPT-6 Astra(OpenAI表) | Fable 5.1(OpenAI表) | Fable 5.1(Anthropic表) |
|---|---|---|---|
| Terminal-Bench Science 0.1(科学研究) | 64.6% | 52.6% | 52.6% |
| Terminal-Bench 4.0(ターミナル作業) | 57.7%(本文は57.9%) | 55.8% | 55.8%(Mythos 5.1は60.9%) |
| AutomationBench(業務自動化) | 41.4% | 31.4% | 31.4% |
| Humanity's Last Exam(ツールあり) | 57.2% | 65.0% | 65.0% |
| OSWorld 2.0(コンピュータ操作) | 72.6%(Offline) | — | 77.9%(partial)/41.7%(strict)※2026年8月版タスク |
| GPQA Diamond(大学院レベル科学) | 96.0% | 93.7% | — |
| FrontierMath Tier 4(数学) | 97.6% | 87.8% | — |
| DeepSWE v1.1(コーディング) | 74.1% | 67.4% | — |
| BenchCAD(設計・CADコード) | 95.9% | 84.3%(脚注: 評価に3つの変更) | — |
| HealthBench Professional | 63.4% | 56.6%(脚注11: OpenAIが測り直した値。公式Xの図は58.1%) | — |
| ARC-AGI-3(抽象推論) | 99.9%(脚注1: Responses APIのハーネスで設定を2つ変更) | — | — |
| CursorBench 3.2.0(エージェント型コーディング) | — | — | 73.4% |
| GDPval-AA v2(知識労働) | — | — | 1853 |
一致しているのはTerminal-Bench Science 0.1、Terminal-Bench 4.0、AutomationBench、Humanity's Last Exam(ツールあり)の4行。OSWorld 2.0はAnthropicが「2026年8月版のタスクで測ったので過去の公表値と直接比較できない」と脚注に書いており、OpenAIの表の「Offline」とは条件が違うので、この行は比べない。
OpenAIが本文で最も押しているのはTerminal-Bench Scienceで、64.6%対52.6%に「推定APIコストは約31%低い」を添えている。同じ公式ページのグラフ26枚のうち22枚は横軸がAPIコストか出力トークンで、絶対値の差より「同じ点に届くまでの費用」を見せる作りになっている。一方でAnthropicは、Fable 5.1の表に「本番セーフガードを有効にして評価し、介入したタスクは0点」という自分に不利な注記を付けている。同じ「52.6%」でも、OpenAIの表の注記は「点数はどの努力レベルでも最大値」、Anthropicの表の注記は「本番セーフガード有効で、介入したタスクは0点」と、付いている但し書きが違う。
Astraが下回る行と、独立指標
OpenAIの表そのものに、Astraが他社を下回る行が載っている。
| ベンチマーク | GPT-6 Astra | 上回ったモデル |
|---|---|---|
| Artificial Analysis Intelligence Index v4.1.1 | 61.2 | Fable 5.1 65.7、Opus 5 63.1、Fable 5 62.1 |
| Humanity's Last Exam(ツールあり) | 57.2% | Fable 5.1 65.0%、Fable 5 63.8%、Opus 5 63.6% |
| FrontierCode 1.1 Extended | 64.5% | Fable 5 64.9% |
| FrontierCode 1.1 Main | 53.3% | Fable 5 53.5%、Opus 5 53.4% |
| Artificial Analysis Coding Agent Index v1.4 | 67.0 | Opus 5 68.1、Fable 5 67.2 |
Artificial Analysisが9月3日に自分のアカウントで出した値(整数表記)では、Intelligence Index v4.1.1がAstra 61・Fable 5.1 66・Opus 5 63・Fable 5 62でAstraは5位、Coding Agent Index v1.4はCodex上のAstraが67、Claude Code上のFable 5.1が70、Opus 5が68、Fable 5が67で、こちらもAstraは5位である。本記事で参照した独立指標はこの1社ぶんだけで、順位は物差しで変わる。
「同じ$10/$50」の中身──キャッシュと長い入力で差が出る
トークン単価が同じでも、実際の請求は同じにならない。差が出るのは2か所ある。
キャッシュ読み込み。 同じ前置き(システムプロンプト・資料・過去の会話)を何度も送るエージェント用途では、入力の大半がキャッシュから読まれる。その単価がAstraは$1.00、Fable 5.1は$0.25で4倍違う。Anthropicは9月1日のブログで、Fable 5のキャッシュ読み込み$1.00を75%下げた効果として「通常のワークロードでFable 5比75、エージェント色の強いワークロードで55」という指数を出し、その根拠を「2026年8月の4週間の実使用・既定effort」と書いている。Astraの$1.00は、値下げ前のFable 5と同じ水準にあたる。
長い入力。 Astraのモデルページには、入力が27万2,000トークンを超えるプロンプトは「そのリクエスト全体について、入力とキャッシュの単価が2倍、出力が1.5倍」と書かれている(原文は使い方の記事に逐語で載せた)。境界を1トークン超えただけで全トークンが割増になる。Fable 5.1は100万トークンの全域が標準単価で、Anthropicのドキュメントに長さによる割増の記載は無い。長い文書やコードベースを丸ごと渡す使い方では、この差がトークン単価の同額より大きく響く。
逆にAstraにあってFable 5.1側で確認できなかったのが、Batch/Flexの半額($5/$25)が料金表に明記されている点と、Fastモード(最大2.5倍速・価格2倍)である。Claudeの料金ページにも「Save 50% with batch processing」の記載はあるので、Batchの半額は両方にある。
どのプランで使えるか──ChatGPT側は「どこで」、Claude側は「どれだけ」の制約
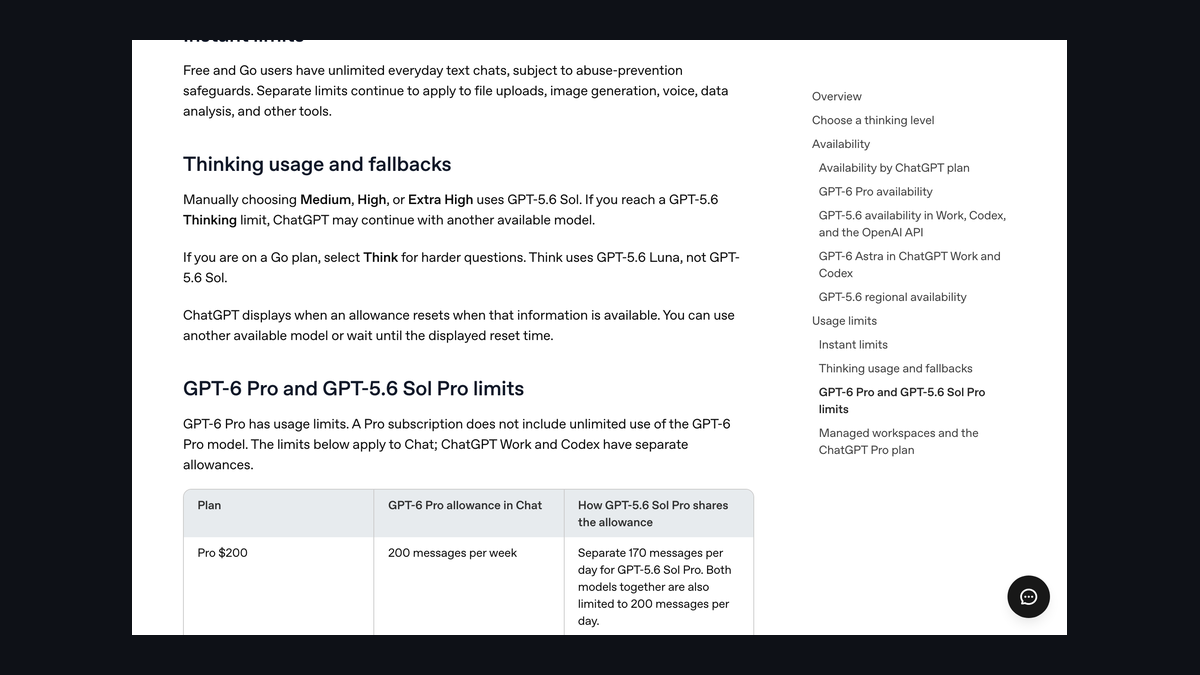
ChatGPT側は、OpenAIのヘルプ「GPT-5.6 and GPT-6 Pro in ChatGPT」に整理がある。Plus($20)に含まれるのはChatGPT WorkとCodexだけで、通常のChatではAstraを選べない。Chatで使えるのはPro $100・Pro $200・Business・Enterpriseで、表示名は「GPT-6 Pro」。上限はPro $200が週200通、Pro $100が週50通(GPT-5.6 Sol Proと共有)。Codexの5時間あたりの目安はPlusで5〜45通、Pro 5倍枠で25〜225通、Pro 20倍枠で100〜900通(GPT-5.6 Solの半分)。なおPro $200は2026年9月時点で新規申込を一時停止していると当サイトのChatGPT料金記事に整理した。
Claude側は、料金ページの「Models and usage」の表に「Fable」の行がある。9月17日に取得した記載では、Free「No」、Pro「Usage credits」(使用量クレジット=従量)、Max 5x/Max 20x「50% of weekly limits」(週間上限の50%まで)、Teamは「premium seatsで50% of weekly limits」、Enterpriseは「Yes」。つまりClaudeはどの画面でも選べるが、$20のProでは月額の枠に含まれず従量になり、Max($100/$200)でも週間上限の半分までという量の制約が付く。この表の行名は「Fable」で世代の表記は無く、同じページのAPI価格の欄では現行が「Fable 5.1」、「Fable 5」はレガシー欄に移っている。ヘルプ「Claude Fable models on your plan」(9月2日更新)はもう少し具体的で、Maxではプランの通常の週間上限から引かれ「他のClaudeモデルより速く消費する」、50%に達したら使用量クレジットで続けるか他のモデルに切り替える、Proでは最初から使用量クレジットで動き、Fable 5にあった7月の一時クレジットは「Fable 5.1には無い」と書いている。Claude CodeでFable 5.1を選ぶにはバージョン2.1.255以上が必要。Claude Codeの週間上限そのものは、@ClaudeDevsが9月14日から恒久的に+25%にすると告知している(整理記事)。
| ChatGPT(GPT-6 Astra) | Claude(Fable 5.1) | |
|---|---|---|
| 無料 | 記載なし(Codexの表にAstraの列が無い) | No |
| $20(Plus/Pro) | WorkとCodexのみ。Chatでは不可 | 使用量クレジット(従量) |
| $100(Pro $100/Max 5x) | Chatで「GPT-6 Pro」週50通。Codex 25〜225通/5時間 | 週間上限の50%まで |
| $200(Pro $200/Max 20x) | Chatで週200通。Codex 100〜900通/5時間 | 週間上限の50%まで |
| API | gpt-6-astra |
claude-fable-5-1 |
安全装置の違い──止まり方が違う
両社とも、最上位モデルには仕事を止める仕組みがある。止まり方が違う。
Astraは、ChatGPTのリリースノート(9月3日)に「指示を取り違えた可能性を検知する監視が追加され、検知時は会話が一時停止または停止して確認を求める」とある。公式ページは「追加の安全チェックは、防御目的のサイバーセキュリティを含む正当な作業を、遅らせたり、一時停止したり、止めたりすることがある」と明記し、ChatGPTとCodexでは内容を確認して続行できるが、APIではタスクがそこで停止する。公開版は脆弱性の実証コードの作成を拒否し、防御側向けの緩い設定は「Daybreak」を通じて数週間かけて広げるとしている。
Fable 5.1は、Anthropicの説明では「Claude Code利用時のサイバーセーフガードの介入がFable 5比で1セッションあたり平均約60%減」「初歩的な生物学・医学の質問での誤検知が85%減」と緩んだ側が中心で、締まったのは蒸留対策(2026年8月31日以降に作った新規APIアカウントで、過去の会話を書き換えつつ思考の記録を保持する操作が不可。Claude Code・Cowork・claude.aiの利用者は影響なし)。ベンチマークは本番セーフガード有効で測っており、介入したタスクは0点で計上されている。安全装置の少ない版はMythos 5.1で、審査を通った組織だけが使える。
止まり方の違いはヘルプに書かれている。Anthropicのヘルプ「Why Claude switched models in your conversation with Fable 5 or Fable 5.1」(9月1日更新)によると、Fable 5.1で遮断された依頼は既定でOpusに自動で切り替わって同じ会話の中で答え直され、切り替わった旨の表示と、答えたモデルのラベルが付く(生物・化学系はOpus 5、攻撃的サイバー系はOpus 4.8)。設定(Settings > Capabilities、Claude Codeでは Config > MODEL & OUTPUT)で「Switch models when a message is flagged」を切ると、切り替えずに会話が止まる。課金は、入力の時点で遮断されたらOpusの単価だけ、途中で遮断されたらそこまでがFableの単価。つまりAstraは「止まって確認を求める(APIでは停止)」、Fable 5.1は「別のモデルに切り替えて続ける(切れる設定あり)」が既定の挙動である。
筆者が同じ課題を両方に振って決めた使い分け
ここからは公式資料ではなく、筆者の観測である。
9月5日、筆者は3Dシーンを組む制作課題を、Claude Fable 5.1とGPT-6 Astraの両方に同じ題材で振った。そのとき決めた使い分けは、**「最初の目標点を決め、構想から叩き台までがFable 5.1。その叩き台から100に持っていく作業がGPT-6 Astra」**である。理由は挙動の差にあった。Fable 5.1は成功しやすい題材を逆算して無難に組み上げ、Astraは存在しない題材に挑んで仕上げまで持っていった。どちらが上という話ではなく、Fableはゴールと採点基準を先に渡すと強く、Astraは叩き台がある状態で伸びる、というのが筆者の主観的な判定である(1件の課題での判断で、統計ではない)。
Fable 5.1については、370年未解決だった暗号を解いた件を、当サイトが出典の1834年版の本で数え直して64文字中64文字の一致を確認した(検証記事)。Astraについては、9月5日05:32に筆者環境(ChatGPT Pro)のCodexでモデル欄に「GPT-6 Astra」が出ていたことと、公式ガイドの「癖5つ」に沿って設定を減らした運用の記録が公式ガイドの記事にある。effortについては、Fable 5.1のxhighがFable 5のmaxに相当する感覚で、普段はオーバースペック、lowでも十分に働く、というのが筆者の所感(プロンプトガイドの記事)。Astraのeffortの段階ごとの感触は、本記事の時点では同じ密度で試していない。
同じ物差しに見えて揃っていない5か所
比較表を作る過程で、揃っているように見えて揃っていない箇所が5つあった。
- Terminal-Bench 4.0のAstraの値は、OpenAIの公式ページの本文と公式Xの図が57.9%、比較表が57.7%。本記事は比較表の値を使い、本文の値を併記した
- HealthBench ProfessionalのFable 5.1の値は、OpenAIの比較表が56.6%(脚注11: OpenAIが独自に測り直した値)、公式Xの図が58.1%。Anthropicの表にはこの項目が無い
- BenchCADのClaudeの値は「評価に3つの変更を加えた測定」(OpenAI脚注)、**ARC-AGI-3の99.9%**は「Responses APIのハーネスで2つの設定を変えて測定」(脚注1)。モデル単体でなく周りの仕組み込みの値である
- OSWorld 2.0は、Anthropicが2026年8月版タスクで測り「過去の公表値と直接比較できない」と書き、OpenAIの表は「Offline」の値。同じ名前だが同じ試験ではない
- Fable 5.1の測定条件が、Anthropic側は「本番セーフガード有効・介入は0点」、OpenAI側は「点数はどの努力レベルでも最大値」。4行で数字が一致している理由(OpenAIが測り直したのか、公表値を載せたのか)は本記事では扱わず、一致という事実だけを書く
加えて、外部の追試として参照できたのはArtificial Analysisの指数だけである。SWE-benchやLMArenaのような他の独立指標にAstraとFable 5.1が並んで載ったかどうかは、本記事の確認範囲に入れていない。
参照した資料と確認日
- GPT-6 Astraの数値・引用は、OpenAI公式ページ「GPT-6 Astra: A new generation of intelligence」(本文・比較表・脚注)、モデルページ、API料金ページ、ヘルプ「GPT-5.6 and GPT-6 Pro in ChatGPT」、Codex料金ページによる。いずれも当サイトの速報(9月4日)と使い方の記事(9月17日)で確認した内容を再掲している
- Claude Fable 5.1の数値・引用は、Anthropic公式ブログ「Introducing Claude Fable 5.1 and Claude Mythos 5.1」、公式ドキュメント(モデル概要・effort)、料金ページ(2026年9月17日取得)、ヘルプセンターの「Claude Fable models on your plan」「Why Claude switched models…」(同日取得)による。料金ページのプラン表の行名は「Fable」で、世代の表記は無い
- Artificial Analysisの整数の値は同社の公式X(9月3日)、小数1桁の値はOpenAIの比較表に載ったもの
- 筆者の使い分けは9月5日の1件の課題にもとづく主観で、追試はしていない。本記事は両社の次のモデルや価格改定があれば更新する
出典・参照資料
- 一次資料GPT-6 Astra: A new generation of intelligence — OpenAI公式ブログ(比較表・脚注・2026-09-03) ↗
- 一次資料Introducing Claude Fable 5.1 and Claude Mythos 5.1 — Anthropic公式ブログ(比較表・脚注・2026-09-01) ↗
- 一次資料GPT-6 Astra — OpenAI API モデルページ(コンテキスト・上限・知識カットオフ) ↗
- 一次資料Pricing — OpenAI API(gpt-6-astra の Standard / Batch / Flex / Fast 料金) ↗
- 一次資料GPT-5.6 and GPT-6 Pro in ChatGPT — OpenAI Help Center(プラン別の提供・上限) ↗
- 一次資料Codex pricing — OpenAI Developers(プラン別の5時間あたり目安) ↗
- 一次資料Claude Fable 5.1 — Anthropic公式ドキュメント(モデルID・価格・知識カットオフ) ↗
- 一次資料Effort — Anthropic公式ドキュメント(effortの5段階) ↗
- 一次資料Claude 料金ページ(プラン別のFableの扱い・API価格・2026-09-17取得) ↗
- 一次資料Claude Fable models on your plan — Anthropicヘルプセンター(2026-09-02更新) ↗
- 一次資料Why Claude switched models in your conversation with Fable 5 or Fable 5.1 — Anthropicヘルプセンター(2026-09-01更新) ↗
- 二次資料Artificial Analysis 公式X(Intelligence Index v4.1.1/Coding Agent Index v1.4・2026-09-03) ↗
- 一次資料@ClaudeDevs 公式X(Claude Codeの週間上限を9月14日から恒久的に+25%) ↗
AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事
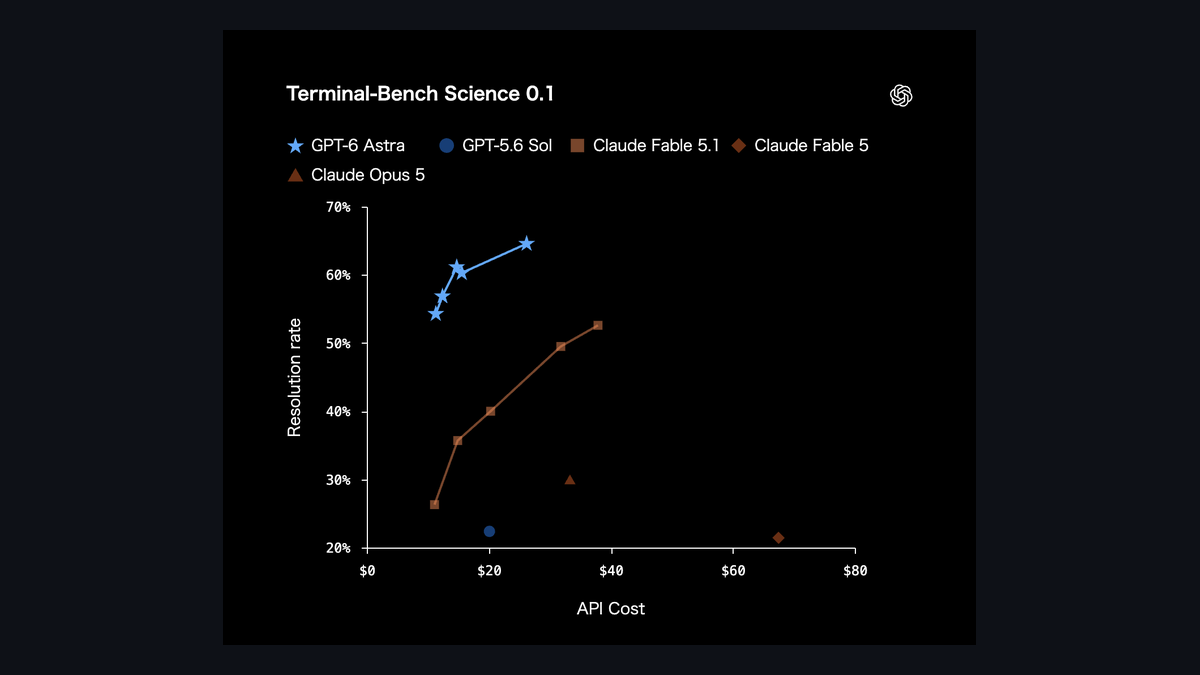
GPT-6 Astra公開──自社比較表では首位、独立指標では5位、価格はFable 5.1と同額の$10/$50
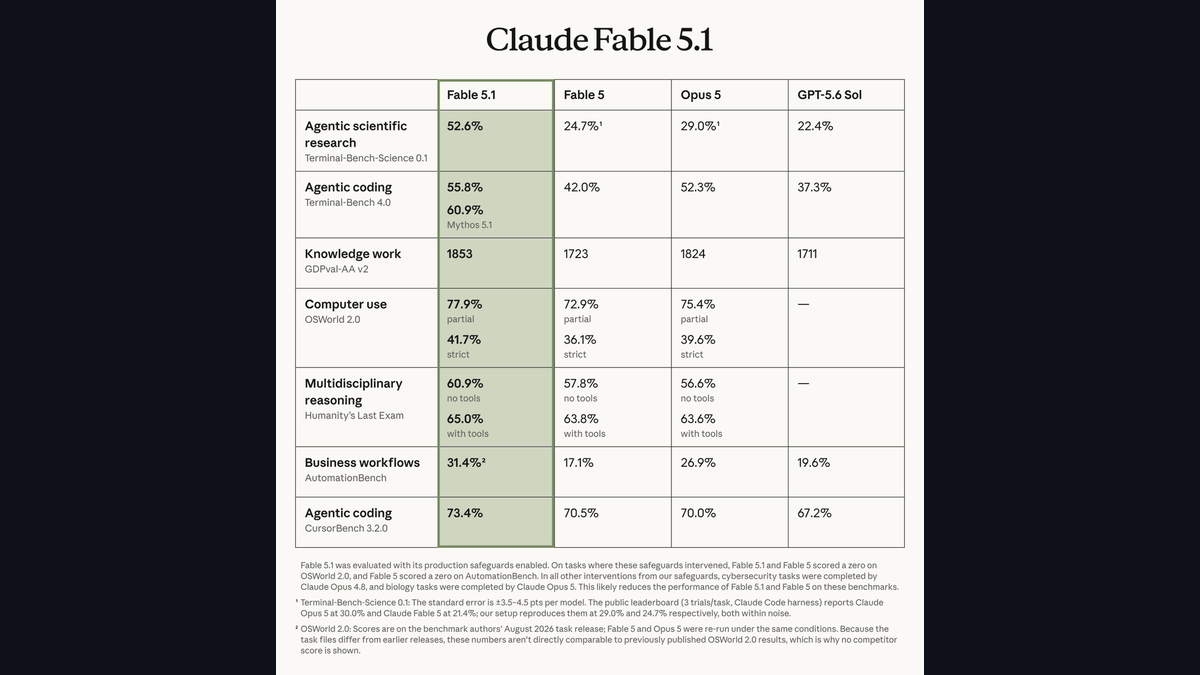
Claude Fable 5.1公開──科学研究ベンチが24.7%から52.6%へ、価格据え置きで実質25%安
GPT-6 Astraの使い方──どのプランで、どこで使えて、週に何通まで送れるか(ChatGPT・Work・Codex・API)
Claude Fable 5.1公式プロンプトガイド全17項目を読む──effortは5段階で既定はhigh、「箇条書きを使うな」「見つけたことは最後まで取っておけ」の旧指示が今は逆効果、公式が配る貼るだけの文面11本

Claude 料金・性能比較・ChatGPTとの違い【2026年最新版】

ChatGPT vs Claude どっちがいい?用途別使い分けガイド【2026年】

Fable 5のプロモーション期間が7月12日まで延長──GPT-5.6一般公開直前の5日間