DeepSeek-V4.1-Flash公開出力100万トークン0.6ドル、KVキャッシュは1トークン890バイト
日刊AIニュース10月25日(日)号:前日のAIのニュース2本を短くまとめました(約4分)›
DeepSeekが2026年9月10日にV4.1-Flashを公開した。MITライセンスで重みを公開し、552BのマルチモーダルMoEで100万トークンのコンテキストに対応する。出力は100万トークンあたり0.6ドル(オフピーク)。技術レポートのタイトルは「KVキャッシュ圧縮の限界を押し広げる」で、1トークンあたりのKVキャッシュを890バイトまで削っている。
目次
DeepSeekが2026年9月10日、DeepSeek-V4.1-Flashを公開した。ライセンスはMITで、重みはHugging Faceに置かれている。同日のChange Logによると、これは「新しいアーキテクチャ一族で最も小さいモデル」で、ネイティブのマルチモーダル視覚理解を持つ。本記事は日本時間2026年9月10日夕方時点の公式情報にもとづく。
【更新:2026年9月25日】 公開時点でModels & Pricingページにあった、
deepseek-v4-proへのリクエストを9月14日からV4.1-Flashへ回すという方針は、9月14日を待たずに撤回された。DeepSeekの告知によるとdeepseek-v4-proの提供は続き、Models & Pricingページの価格も公開時点と同じである。詳細は「V4-Pro統合は撤回」の節に追記した。あわせて、ピーク時間帯の注記に中国の祝日の扱いが加わっていたので「仕様と価格」の節に追記した。
動画版はこちら: DeepSeek-V4.1-Flash速報
DeepSeek公式の発表によると、V4.1-Flashは552BバックボーンのマルチモーダルMoEで、コンテキストは100万トークン、最大出力は384K。API価格はオフピークで出力100万トークンあたり0.6ドル、入力はキャッシュヒットで0.003ドル。技術レポートによると、常時HBMに置くKVキャッシュを1トークンあたり890バイトまで圧縮しており、これはDeepSeek-V4-Flashの約4分の1、初代V1の437分の1にあたる。
仕様と価格
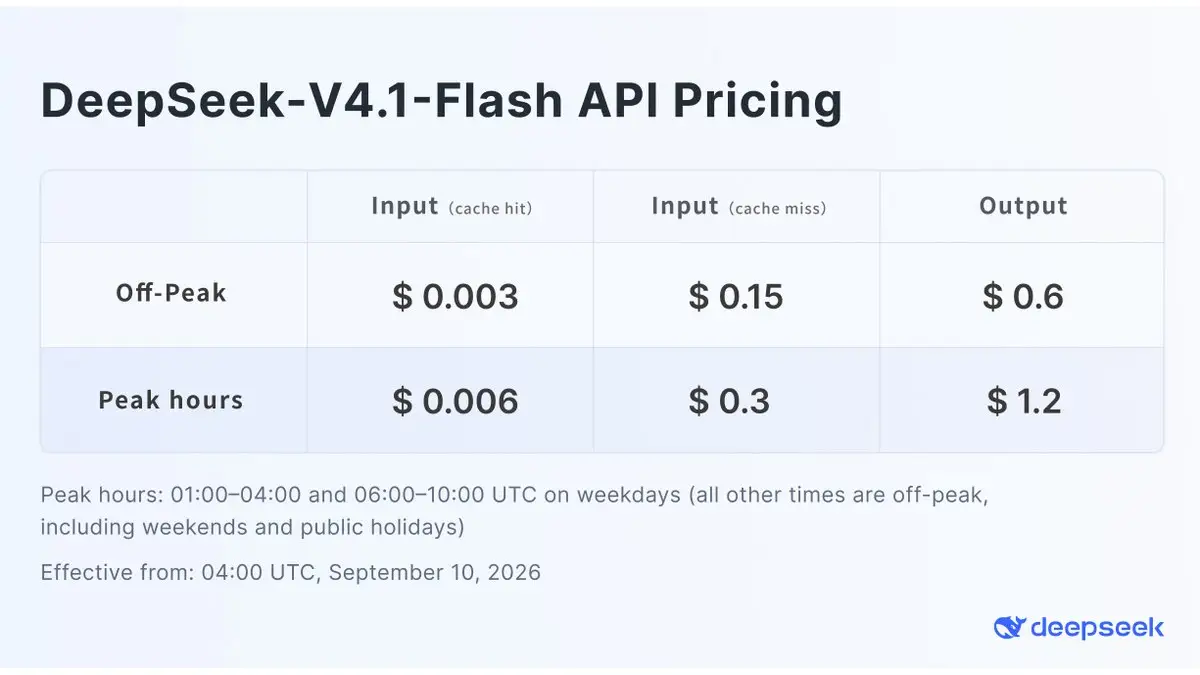
Models & Pricingページの記載は以下のとおり。価格は100万トークンあたり。
| 項目 | DeepSeek-V4.1-Flash |
|---|---|
| モデル名 | deepseek-flash |
| コンテキスト長 | 1M |
| 最大出力 | 384K |
| 視覚入力 | 対応 |
| 入力(キャッシュヒット) | オフピーク $0.003 / ピーク $0.006 |
| 入力(キャッシュミス) | オフピーク $0.15 / ピーク $0.3 |
| 出力 | オフピーク $0.6 / ピーク $1.2 |
| 同時実行上限 | 2500 |
ピーク時間帯は同ページに「平日の協定世界時1時から4時と、6時から10時。それ以外はすべてオフピーク」と書かれている。価格の適用開始は公式画像によると協定世界時9月10日4時。
(2026年9月25日追記:同じ注記には現在 "excluding Chinese public holidays"(中国の祝日を除く)が加わり、"including weekends and Chinese public holidays in full"(土日と中国の祝日は終日オフピーク)と明記されている。Internet Archiveに残る9月10日〜17日の保存版の注記には、この文言はなかった)
KVキャッシュを890バイトまで削った──技術レポート原題「Pushing the Limits of KV Cache Compression」
技術レポートの表題は "DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression"(KVキャッシュ圧縮の限界を押し広げる。PDFを直接開く)。値下げの告知ではなく、圧縮の論文として出されている。
アブストラクトの記述はこうだ。
To push the limits of KV cache compression, DeepSeek-V4.1-Flash combines cross-layer KV cache reuse in Compressed Sparse Attention 2 (CSA2) with FP4 KV caching. These designs reduce its global KV cache footprint (always in HBM) to 890 bytes per token, roughly 1/4 of the corresponding footprint of DeepSeek-V4-Flash.
(KVキャッシュ圧縮の限界を押し広げるため、DeepSeek-V4.1-FlashはCompressed Sparse Attention 2における層をまたいだKVキャッシュ再利用と、FP4のKVキャッシュを組み合わせている。これらの設計により、常時HBMに置くグローバルKVキャッシュの専有量は1トークンあたり890バイトとなり、DeepSeek-V4-Flashの約4分の1になった)
Figure 1(b)に世代ごとの数値が載っている。初代V1(2023年11月)が389,120バイト、V3.2(2025年12月)が48,068バイト、V4-Flash(2026年4月)が3,514バイト、そしてV4.1-Flash(2026年9月)が890バイト。レポートはV1比で437分の1と書いている。
SSDやホストメモリに常駐する永続KVキャッシュについては、SWA Bounded Replayという配備上の工夫でV4-Flashの約8分の1になったとしている。
もうひとつがCausal Encoder-Decoder(CED)で、552Bのうち出力を書くデコード時は16B、入力を読み込むプリフィル時は8Bしか活性化しない。レポートによると、コンテキストを4Kから100万トークンへ256倍に伸ばしてもデコードのFLOPsは4分の1しか増えない。
事前学習は45兆トークンのマルチモーダルコーパス。疎なアテンションは64Kのシーケンス長でゼロから学習しており、密なアテンションによるウォームアップ段階を挟んでいないとレポートに書かれている。
ベンチマークを数え直すと5勝10敗だった
Change Logと技術レポートTable 3に19項目の数値が載っている。目立つのは、勝ち負けが項目のタイプできれいに分かれている点だ。
そこで、Table 3で両者に数値がある項目だけを取り出して数えてみた。以下は筆者が表から手作業で集計したもので、DeepSeekが出している数字ではない。
| 相手 | 勝敗 | 10ポイント以上離された項目 |
|---|---|---|
| Opus 5 | 5勝10敗(15項目) | Terminal-Bench 4.0 (-20.6)、HLE (-19.5)、ProgramBench (-16.7)、Terminal-Bench 3.0 (-13.3) |
| GPT-5.6-Sol | 7勝9敗(16項目) | ExploitGym (-18.4)、SEC-Bench Pro (-11.5) |
上に出た項目はTerminal-Bench 2.1(90.6対89.1)、Automation-Bench(54.8対50.3)、Agents' Last Exam(31.8対28.6)、CyberGym(88.1)など、エージェントを動かす系に寄っている。逆に大きく離されたのはHLE(36.8対56.3)やProgramBench(20.3対37.0)といった難問系と、新しいTerminal-Bench 3.0 / 4.0だった。
なおOpus 5に勝った5項目のうち2つは、DeepSWE v1.1が+0.2、HLE w/toolsが+0.3で、実質は横並びである。
DeepSeek自身はレポート本文でこう書いている。
Despite its compact nature, DeepSeek-V4.1-Flash demonstrates state-of-the-art agentic capabilities, substantially closing the gap with frontier closed-source models while establishing clear advantages among open-source alternatives.
(コンパクトでありながら、DeepSeek-V4.1-Flashは最先端のエージェント能力を示し、フロンティアの非公開モデルとの差を大きく詰めつつ、オープンソースの選択肢のなかでは明確な優位を確立した)
「差を詰めた」であって「並んだ」とは書いていない。
Codeforcesのレートは3471で、これはV4-Flashの3289、V4-Proの3348を上回る数字だが、Table 3ではOpus 5とGPT-5.6-Solの欄が「-」なので他社との比較はできない。
測定に使ったハーネスが項目ごとに違う
エージェント系ベンチマークは、モデルの外側に着せるスキャフォールド(ハーネス)で点数が変わる。レポートの評価設定にはこう書かれている。
For code agents, we evaluate DeepSeek-V4.1-Flash using the Minimal mode of DeepSeek Harness with a 1M-token context window, temperature set to 1.0, and top-p set to 0.95. To align with official setup requirements, we employ the mini-SWE harness for DeepSWE v1.1. For SEC-Bench Pro, we utilize the Claude Code harness specifically for its session compact design. For visual agent tasks, we evaluate using the Claude Code harness with a 512k-token context window.
自社ハーネスで統一したのではなく、DeepSWE v1.1はmini-SWE、SEC-Bench Proと視覚エージェント系はClaude Codeを使ったと明記している。Agents' Last ExamとAutomation-Benchは各公式スキャフォールドとある。
またレポートは、6系統8構成のスキャフォールド(Claude Code、Codex、OpenCode、Pi、mini-SWE、DeepSeek HarnessのMinimal / Standard / PTCモード)で測り直した結果をTable 4に載せている。コーディングエージェント評価での報酬ハッキングを抑えるため、インターネットアクセスを遮断しGit履歴を削除したとも書かれている。
V4-Pro統合は撤回──独立モデルとして併売が続く
本記事を公開した2026年9月10日時点、Models & Pricingページの注記(2)にはこう書かれていた。
After extensive testing, V4.1 Flash has comprehensively surpassed V4 Pro in performance, cost, speed, and total time, so we plan to retire V4 Pro in an orderly manner. From 12:00 Beijing Time on September 14, 2026, and until V4.1 Pro is released in the future, requests to deepseek-v4-pro will all be routed to V4.1 Flash and billed at the V4.1 Flash price.
(広範なテストの結果、V4.1 Flashは性能・コスト・速度・総所要時間のすべてでV4 Proを上回ったため、V4 Proを順次終息させる予定である。2026年9月14日の北京時間12時から、将来V4.1 Proがリリースされるまでのあいだ、deepseek-v4-proへのリクエストはすべてV4.1 Flashにルーティングされ、V4.1 Flashの価格で課金される)
この方針は9月14日を待たずに撤回された。DeepSeek公式Change Logの同じ2026年9月10日付エントリでは、V4-Proの終息を告げていた段落が次の一文に差し替えられている(Models & Pricingページの注記(2)も一時期、同じ文面に置き換わっていた)。
In response to user demand, we have decided to continue providing API services for DeepSeek V4 Pro after September 14, 2026, with the billing method remaining unchanged. We will provide further notice should there be any changes.
(ユーザーの要望を受け、2026年9月14日以降もDeepSeek V4 ProのAPIサービス提供を継続し、課金方法も変更しないことを決定した。変更がある場合は改めて案内する)
いつ差し替わったかは、Internet Archiveの保存版で絞り込める。Models & Pricingページの注記は、協定世界時9月11日7時47分の保存版では終息予定の文面、同日16時55分の保存版では継続の文面だった。Change Logは9月11日10時15分の保存版で終息予定、9月13日10時43分の保存版で継続になっている。保存の間隔より細かい時刻は分からない。
2026年9月24日にModels & Pricingページを開き直すと、deepseek-v4-proはdeepseek-flashと並ぶ独立したモデルとして掲載されており、V4-Proの扱いに触れた注記はなくなっていた(現在の注記(2)はピーク時間帯の説明)。価格は、9月10日時点の保存版と比べて変わっていない。
| 項目 | deepseek-v4-pro(DeepSeek-V4-Pro-0813) |
|---|---|
| コンテキスト長 | 1M |
| 最大出力 | 384K |
| 視覚入力 | 非対応 |
| 入力(キャッシュヒット) | オフピーク $0.022 / ピーク $0.044 |
| 入力(キャッシュミス) | オフピーク $0.66 / ピーク $1.32 |
| 出力 | オフピーク $1.98 / ピーク $3.96 |
| 同時実行上限 | 500 |
V4-Proの出力価格はV4.1-Flashの3.3倍にあたる(オフピーク・ピークとも)。継続の理由として告知にあるのは「ユーザーの要望を受け」の一言で、本記事が確認したChange LogとModels & Pricingページには、それ以上の説明はなかった。
前世代のdeepseek-v4-flashとdeepseek-v4-flash-vision-expはすでに退役済みで、モデル名は受け付けるがV4.1-Flashが応答する、と同ページに書かれている(V4-Flash-Vision-Expの記事)。こちらは2026年9月24日時点のページでも同じ記載のままである。
呼び出し側で指定するモデル名は、Your First API Callページによるとdeepseek-flashとdeepseek-v4-proの2つ。公開時点の同ページにも2つ載っていたが、deepseek-v4-proには9月14日からV4.1 Flashへ回すという注記が付いており、本記事は当初これを先取りして「deepseek-flashひとつ」と書いていた(冒頭の訂正を参照)。上記の撤回で、現在も2つのままである。Anthropic互換のエンドポイントhttps://api.deepseek.com/anthropicが用意されており、同ページには「Claude Code、GitHub Copilot、OpenCodeのようなツールを使っているなら、DeepSeekをバックエンドモデルとして直接使える」と記載がある。DeepSeek Harnessは開発者プレビューとして案内されている。ログイン方法・思考モードの切り替え・ピーク時間帯まで含めた使い方はDeepSeekの使い方ガイドにまとめてある。
データの扱いについては2点ある。DeepSeekのプライバシーポリシー(2026年2月10日最終更新)は「当社が収集した情報を中華人民共和国にある安全なサーバーに保存します」と書いている(中国系AIラボの規約を原文で読んだ記事)。もう1点は、Anthropicが2026年9月10日に公開した脅威レポートの記載である。報告書によると、DeepSeekは自社の顧客に知らせずにリクエストをClaudeへ中継しており、対象にはClaude Code・Claude Agent SDK・OpenCodeといったハーネス経由でDeepSeekのモデルを使っていた利用者が含まれる。リクエスト内の文字列からそうした利用者に印を付け、印の付いた利用者のうち一部のリクエストをClaude Opusへ回していたという。報告書の対象期間は2025年12月から2026年8月までで、V4.1-Flashの公開より前にあたる。これはAnthropic側の記載で、DeepSeek側の説明は本記事では確認していない(Anthropicの154ページの脅威レポートを読んだ記事)。
速度について確認できたこと、できなかったこと
Change Logは新アーキテクチャを「より高い能力の天井、より速い推論、より高いスループット」のために設計したと書いている。ただし本記事が確認した範囲では、公式ドキュメントと技術レポートに実測のトークン毎秒は見当たらなかった。
数字として取れたのは設計上の指標だけである。コンテキストを256倍にしてもデコードFLOPsが4分の1増にとどまること、同時実行上限が2500(V4-Proは500)であること、DSparkという投機デコード(半自己回帰のドラフト生成と確信度スケジュール検証)が入っていること。
Hugging Faceのモデルページには、DeepSeek公式ではない第三者の推論プロバイダーごとに、トークン毎秒と出力価格が表示されている。2026年9月24日に確認し、25日に見直しても同じだった値は、novita 108.6トークン/秒(出力100万トークンあたり$1.2)、fireworks-ai 59.8トークン/秒、deepinfra 48.5トークン/秒($0.6・表示中で最安)、baseten 33.7トークン/秒($1.2)。featherless-aiも提供元に並んでいたが、速度の値は付いていなかった。重みがMITライセンスで公開されているので各社が自前でホストしており、表示される値は時期によって変わりうる。DeepSeek自身のAPIでの速度でもない。体感速度を知りたい場合は、この数字と、実際に叩いた人の報告をあわせて見るのがよい。
ベンチマークの数値は、比較対象のOpus 5やGPT-5.6-Solの分も含めてすべてDeepSeekがTable 3に掲載したものである。第三者による再現ではない。
出典と、この記事で確認していないこと
上記frontmatterのうち、DeepSeekとHugging Faceの5つの公式ソースを2026年9月10日15時台(日本時間)にすべて取得し、記事中の数値はそれらに突合した。勝敗の集計だけは筆者がTable 3から手作業で数えたもので、公式が出している数字ではない。
この記事の改修にあわせて、2026年9月24日と25日にChange Log・Models & Pricing・Your First API Callの3つを開き直し、公開後の文面の移り変わりをInternet Archiveの保存版(9月10日〜23日)で確かめた。変わっていたのはV4-Proの扱いと、ピーク時間帯の注記に加わった中国の祝日の扱いの2点である。技術レポートPDFとHugging Faceのモデルカード本文は再突合していない。Hugging Faceのコミット履歴では、PDFの最後のアップロードは協定世界時9月10日5時51分、リポジトリの最終コミットも同日8時18分で、それ以降の更新はなかった(9月25日確認)。
確認していないのは次の3点。DeepSeek公式による実測のトークン毎秒(上記のとおり第三者プロバイダーの数字は見つかったが公式の数字ではない)、第三者によるベンチマークの再現、そしてV4.1 Proの扱いである。3つ目は9月10日時点では「将来V4.1 Proがリリースされるまで」とModels & Pricingページに書かれていたが、この注記はその後V4-Pro継続の文面に差し替えられ、さらに注記ごとなくなった。2026年9月24日時点では「V4.1 Pro」という名称はページ全体を検索しても見つからない。技術レポートのほうも、本記事がV4.1 Pro・V4.1-Pro・Pro model・larger models の4語で全文検索した範囲では、V4.1 Proという名称自体が出てこなかった(この点は9月10日時点から変わっていない)。「モデルアーキテクチャ・事前学習・事後学習の合同スケーリングを追求する」という記述はあるが、これは導入部(7ページ)のもので、結論部(37ページ)の結びは「今後のモデル知能の進歩は、データ・モデル容量・強化学習の協調したスケーリングにかかっている」(原文 "further advances in model intelligence will depend on the coordinated scaling of data, model capacity, and RL")である。
本記事は続報があり次第更新する。実際に触った感触や、上の集計への異論があれば、動画のコメント欄で教えてほしい。次の記事に反映する。
関連記事
出典・参照資料
- 二次資料DeepSeek公式 Change Log(Date: 2026-09-10) ↗
- 二次資料DeepSeek公式 Models & Pricing ↗
- 二次資料DeepSeek公式 Your First API Call ↗
- 二次資料DeepSeek-V4.1-Flash Technical Report(PDF) ↗
- 二次資料Hugging Face: deepseek-ai/DeepSeek-V4.1-Flash ↗
- 二次資料Internet Archive保存版 Models & Pricing(2026-09-11 07:47 UTC・V4-Pro終息予定の注記) ↗
- 二次資料Internet Archive保存版 Models & Pricing(2026-09-11 16:55 UTC・V4-Pro継続の注記) ↗
- 二次資料Internet Archive保存版 Change Log(2026-09-11 10:15 UTC・終息予定の文面) ↗
- 二次資料Internet Archive保存版 Change Log(2026-09-13 10:43 UTC・継続の文面) ↗
- 二次資料Internet Archive保存版 Your First API Call(2026-09-10 13:35 UTC) ↗
- 一次資料Anthropic: Detecting and countering misuse of AI: September 2026(PDF・2026年9月10日公開) ↗
- 二次資料DeepSeekプライバシーポリシー ↗
更新・訂正履歴
- API呼び出し時のモデル指定について「Your First API Callページによると`deepseek-flash`ひとつ」と書いていたが、Internet Archiveに残る2026年9月10日の保存版(協定世界時13時35分)では、同ページのモデル欄に`deepseek-flash`と`deepseek-v4-pro`の2つが載っていた。`deepseek-v4-pro`には、9月14日からV4.1 Flashへルーティングするという注記が付いており、本記事はこの予定を先取りして「ひとつ」と書いていた。本文を当時のページの記載どおりに直した。
- 技術レポートの引用位置と中身を訂正。「結論部にあるのは『モデルアーキテクチャ・事前学習・事後学習の合同スケーリングを追求する』という記述までである」と書いていたが、PDFをテキスト化して確認したところ、その記述は導入部(7ページ)にあり、結論部(37ページ)の結びは「further advances in model intelligence will depend on the coordinated scaling of data, model capacity, and RL」だった。該当箇所を実際の位置と文言に直した。なお「技術レポートにV4.1 Proという名称が出てこない」という記述自体は、全文を再検索して0件であることを確認済み(誤りではない)。

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
DeepSeekの使い方【2026年9月版】 無料アプリ・Web版のログイン方法と機能、API(deepseek-flash/deepseek-v4-pro)の始め方とピーク・オフピーク料金、Claude Code・Codexから使う方法、データが中国のサーバーに置かれる点まで
DeepSeekの使い方【2026年9月版】無料アプリ・Web版のログイン方法と機能、API(deepseek-flash/deepseek-v4-pro)の始め方とピーク・オフピーク料金、Claude Code・Codexから使う方法、データが中国のサーバーに置かれる点まで
中国AIモデルまとめ【2026年9月版】 DeepSeek・Qwen・Kimi・GLM・MiniMax・Tencentの現行モデル、API価格、重みの公開状況(Hugging Faceで確認)、ライセンスの条件、データの保存先。覆面モデルOx Alpha(GLM-5.3-Flash)とUnion Alpha(UnbiasedのPareto)の正体まで
中国AIモデルまとめ【2026年9月版】DeepSeek・Qwen・Kimi・GLM・MiniMax・Tencentの現行モデル、API価格、重みの公開状況(Hugging Faceで確認)、ライセンスの条件、データの保存先。覆面モデルOx Alpha(GLM-5.3-Flash)とUnion Alpha(UnbiasedのPareto)の正体まで
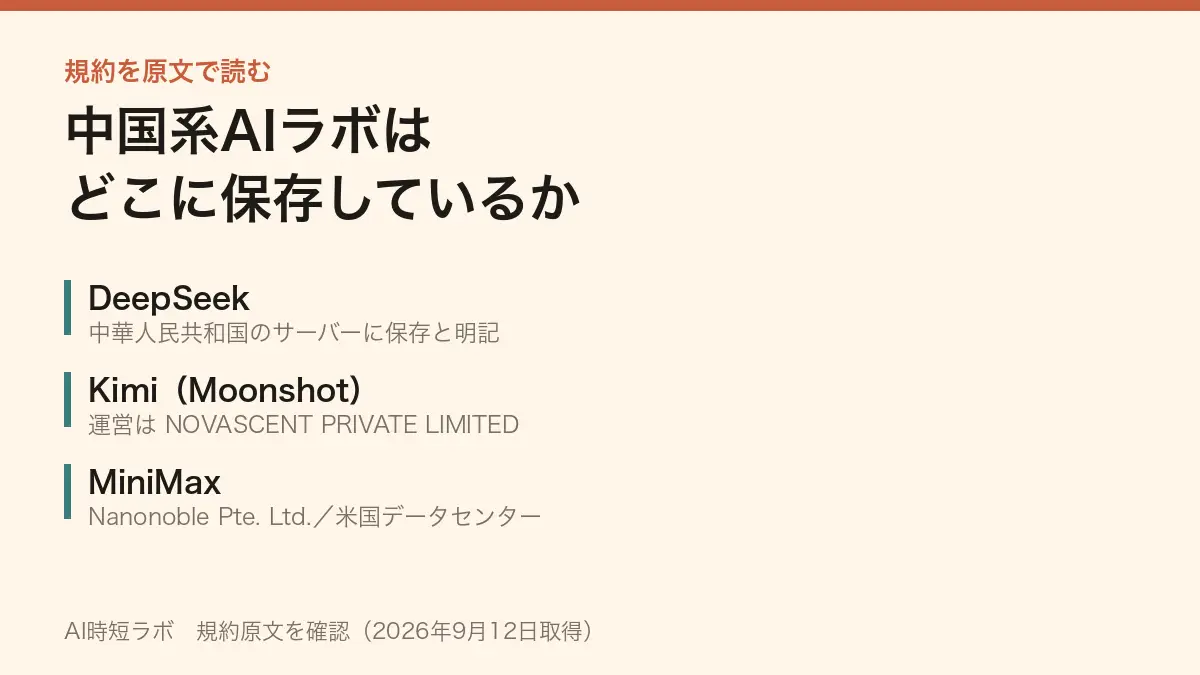
DeepSeekは中国のサーバーに保存、KimiとMiniMaxは社名の違う海外法人が運営 中国系AIラボの規約を原文で読む
DeepSeekは中国のサーバーに保存、KimiとMiniMaxは社名の違う海外法人が運営中国系AIラボの規約を原文で読む
 動画
Anthropicが154ページでClaudeの悪用事例を公開 中国7ラボを実名、マリの2500万SIM監視、生物兵器開発への悪用の証拠を「民間企業として初めて」と述べて開示
Anthropicが154ページでClaudeの悪用事例を公開中国7ラボを実名、マリの2500万SIM監視、生物兵器開発への悪用の証拠を「民間企業として初めて」と述べて開示
 動画
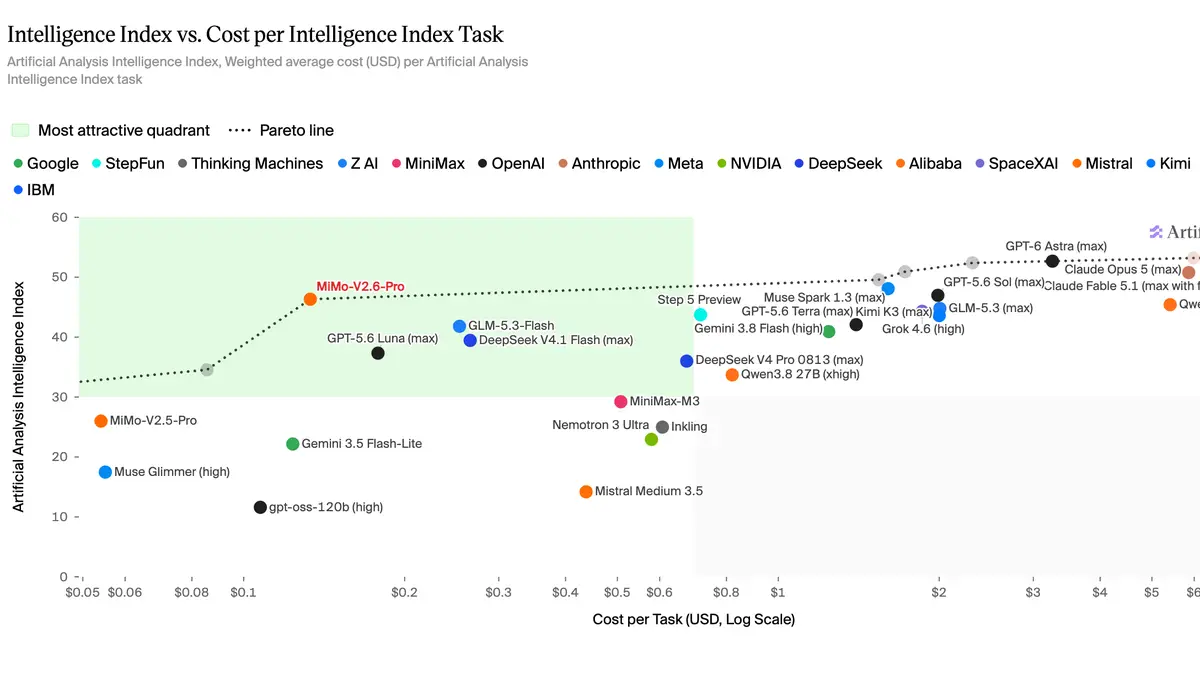
XiaomiがMiMo-V2.6を公開 1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
XiaomiがMiMo-V2.6を公開1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
 動画
テンセントのHy4 previewはClaude Haikuより安い 公開ベンチ46行を数えたらKimi K3と23勝22敗だった
テンセントのHy4 previewはClaude Haikuより安い公開ベンチ46行を数えたらKimi K3と23勝22敗だった
 動画
DeepSeek(ディープシーク)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開 Terminal-Bench 4.0は31.2から42.3、表の11項目すべてで旧版を上回る(同社掲載の数字)
DeepSeek(ディープシーク)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開Terminal-Bench 4.0は31.2から42.3、表の11項目すべてで旧版を上回る(同社掲載の数字)