Google ADKに「ライブ・音声エージェントの評価」模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
日刊AIニュース10月31日(土)号:前日のAIのニュース8本を短くまとめました(約6分)›
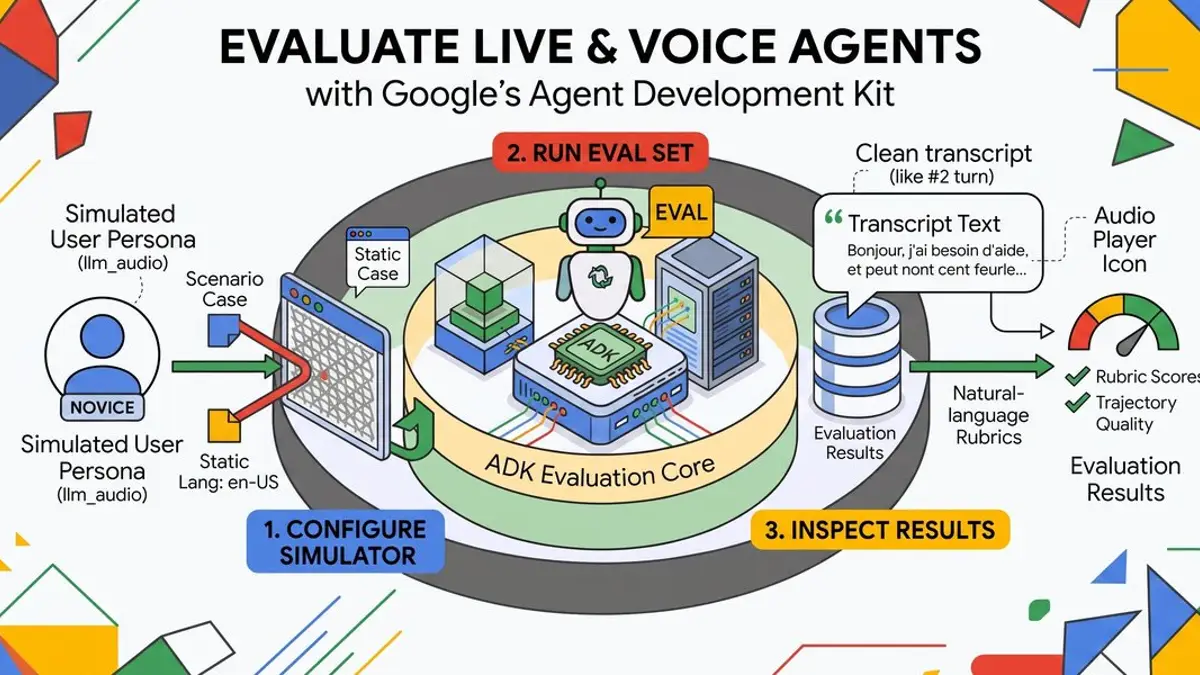
GoogleのStephen Allen氏は2026年8月24日、ADKにライブ(音声)エージェントのネイティブ評価が入ったと解説した。プロンプトの微調整やモデル更新でツールが発火しなくなる、ターン間で文脈が抜ける、割り込みを無視する、といった回帰を、テキストエージェントと同じ評価ループで捕まえる。例はgemini-live-2.5-flash-native-audioの3つのライブエージェント(本人確認→生年月日を検証ツールで照合→予約案内)をWorkflowで直列にしたもの。評価セットは「会話シナリオ」(会話計画とペルソナを書き、模擬ユーザーが即興し計画達成で自ら終話)と「固定会話」を混ぜられる。test_config.jsonでlive_model_configを入れ、模擬ユーザーをllm_audio(ターン制御gemini-3.7-flash、音声合成gemini-3.1-flash-tts-preview)にし、ルーブリック判定(閾値0.7)で「予約を明かす前に本人確認したか」を採点。adk evalで回しCI/CDにも。
2026年9月18日・日本時間時点の情報です。 Google Developersのブログ(8月24日)を読んだ。音声エージェントは「デモでは良かったのに本番で崩れる」が起きやすく、その回帰を測る道具が公式に入った記事。ADKの周辺はKotlin 1.0、Liveモデル側はGemini 3.8 Liveに。
3行まとめ
- 何が入ったか。 ADKにライブ評価がネイティブに入り、模擬ユーザーが発話を音声として話し、音声の返答を採点する工程を、テキストエージェントと同じ評価ループの中で回せる。背景は、昨日まで完璧に聞こえた振る舞いがプロンプトの微調整やモデル更新で静かに変わる(ツールが発火しない・ターン間で文脈が抜ける・割り込みが無視される)問題。
- 例の構成。 gemini-live-2.5-flash-native-audioで動く3つの単機能ライブエージェント──①「Sam」として挨拶しJohn Doe本人か確認、②生年月日を聞いて読み返し、
validate_date_of_birthをYYYY-MM-DD形式で呼ぶ(モックで1985-07-12と照合)、③本人確認済みとして火曜16日15時のDr. Exampleの予約を案内し「Goodbye」で終話──をWorkflowのedgesで直列にする。引き継ぎの間も音声ストリームは開いたままで、セッション状態と履歴が次のエージェントに渡る。評価セット(JSON)は2種類を混ぜられる。会話シナリオはstarting_prompt・conversation_plan(「あなたはJohn Doe。生年月日を聞かれたら1985年7月12日と答え、予約の説明を聞いたら持ち物を尋ね、質問なしと言って終わる」)・user_persona(NOVICE=高レベルの目的しか言わず、エージェントが会話を主導できるかを試す。ペルソナはプロンプト駆動で追加可)を書き、模擬ユーザーが計画を満たしたら自分で終話、max_allowed_invocationsで上限。固定会話は発話を台本どおり並べる。- 設定と実行。
test_config.jsonにlive_model_config(timeout 300秒)を入れ、user_simulator_configを**llm_audioに(model=gemini-3.7-flashがターン制御、audio_model=gemini-3.1-flash-tts-previewが音声合成、voice_name「Kore」やlanguage_code「en-US」を変えて声や訛りへの耐性も試せる)。採点はrubric_based_multi_turn_trajectory_quality_v1(判定モデルgemini-3.7-flash・閾値0.7)で「通話全体で、予約の詳細を明かす前に名前を確認し生年月日を検証したか」のような自然言語ルーブリックを会話全体に当て、ターン単位の指標も付けられる。live_model_configを外せば同じケースがテキストモードで走る**。uv run adk eval …のCLIかAgentEvaluatorから呼べ、CI/CDに組み込める。ADK Webでも対話的に確認できる。
文字列一致でなくルーブリックで判定
- 音声の返答は「正しい言い方が何百通りもある」ので、文字列一致でなく**ルーブリック(自然言語の判定基準)**で意図を判定する、という設計。ハーネス・エンジニアリングの解剖の「複雑な課題はLLM判定で緩く」に対応する
- 模擬ユーザー側にも2つのモデル(ターン制御とTTS)が要り、評価1回でLive API・TTS・判定の3系統の課金が発生する。回数の見積もりは要る
- 日本語の声(
language_code=ja-JP)での動作は本文にない。Gemini TTSの対応言語次第で、筆者は確認していない - 本人確認→ツール呼び出し→案内、という例は、コールセンター系のADKのReflectAndRetryと組み合わせる用途が想像しやすい
原文の設定値だけ確認し実行はせず
この記事の下調べで、筆者は9月18日にGoogle Developersのブログを取得し、モデル名・設定キー・ペルソナ名・閾値・CLIのコマンドがその原文にあることを確認した。ADKのサンプル(contributing/samples/live/live_workflow)は開いていない。筆者はADKのライブ評価を動かしていない。
日本語音声対応と費用は本文になし
- 対応するADKのバージョン
- 日本語音声での評価
- 評価1回あたりの費用
参照はGoogle Developers公式記事1本
- How to Evaluate Live & Voice Agents in ADK(Google Developers・2026年8月24日)
関連記事
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Google「ADK for Kotlin 1.0」が正式版 Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
Google「ADK for Kotlin 1.0」が正式版Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
Gemini 3.8 Liveと3.8 Live Extended Thinking公開 話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位(9月時点)、音声は1分あたり入力$0.005・出力$0.018
Gemini 3.8 Liveと3.8 Live Extended Thinking公開話しながら裏で考えて道具を動かす音声モデル、Artificial Analysisの音声対話指数で首位(9月時点)、音声は1分あたり入力$0.005・出力$0.018
Google「ハーネス・エンジニアリングの解剖」 Terminal-BenchやDeepSWEの総合点が数ポイント動いても「なぜ」は分からない。「曖昧な指示で聞き返すか」「ビルドファイルを変えたら検証を回すか」を単体テストのように断言する「行動評価」を、Antigravity SDK+pytestで5秒以内に回す。評価は「ドッグフーディングで自分のコードベースを扱えるようになった後」から
Google「ハーネス・エンジニアリングの解剖」Terminal-BenchやDeepSWEの総合点が数ポイント動いても「なぜ」は分からない。「曖昧な指示で聞き返すか」「ビルドファイルを変えたら検証を回すか」を単体テストのように断言する「行動評価」を、Antigravity SDK+pytestで5秒以内に回す。評価は「ドッグフーディングで自分のコードベースを扱えるようになった後」から
AIエージェントの作り方【2026年9月版】 ノーコード(Dify・Lindy)、SDK(Claude Agent SDK・OpenAI Agents SDK・Google ADK・LangGraph)、任せる型(OpenAI Agents API・Claude Managed Agents)の3段階と、最初の1本を動かすまでのコード、暴走と課金を止める4つの安全装置
AIエージェントの作り方【2026年9月版】ノーコード(Dify・Lindy)、SDK(Claude Agent SDK・OpenAI Agents SDK・Google ADK・LangGraph)、任せる型(OpenAI Agents API・Claude Managed Agents)の3段階と、最初の1本を動かすまでのコード、暴走と課金を止める4つの安全装置
壊れたツール呼び出しを、モデル自身に「もう一度考えさせて」直させる GoogleのADKが標準搭載したReflectAndRetryModelPlugin
壊れたツール呼び出しを、モデル自身に「もう一度考えさせて」直させるGoogleのADKが標準搭載したReflectAndRetryModelPlugin
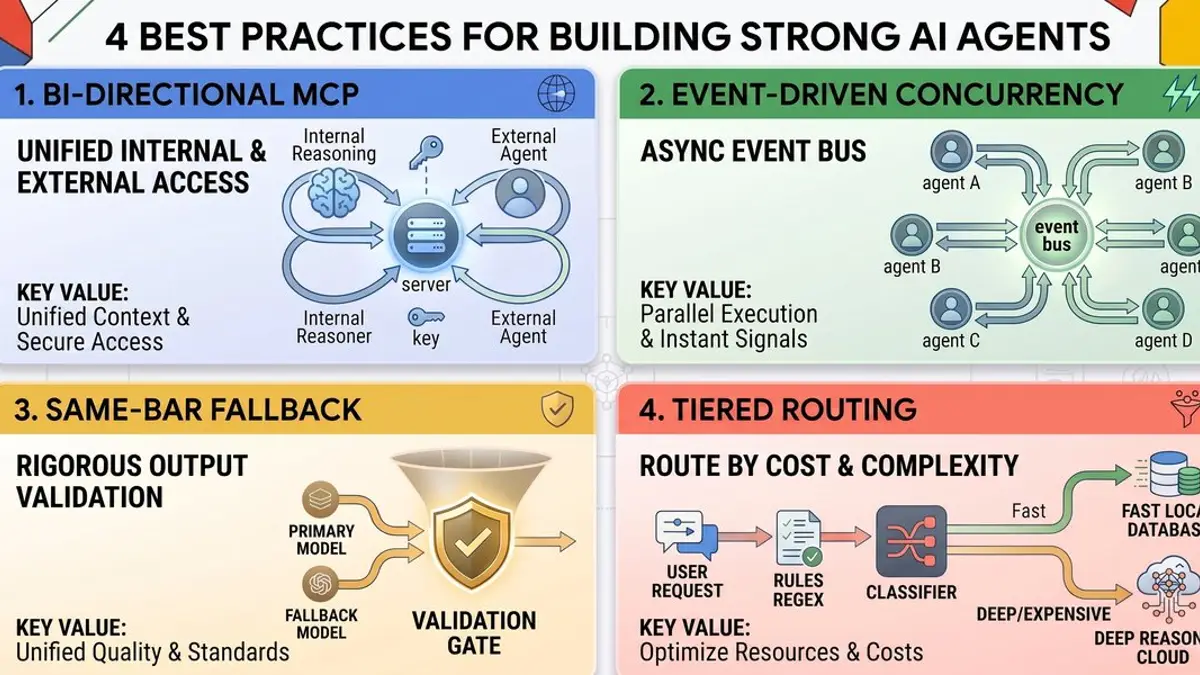
Google「AI Agents Challenge」上位に共通した4つの設計 ①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google「AI Agents Challenge」上位に共通した4つの設計①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google DeepMind「クライアントSDKの生成はオープンであるべき」 2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守
Google DeepMind「クライアントSDKの生成はオープンであるべき」2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守