Google「ハーネス・エンジニアリングの解剖」Terminal-BenchやDeepSWEの総合点が数ポイント動いても「なぜ」は分からない。「曖昧な指示で聞き返すか」「ビルドファイルを変えたら検証を回すか」を単体テストのように断言する「行動評価」を、Antigravity SDK+pytestで5秒以内に回す。評価は「ドッグフーディングで自分のコードベースを扱えるようになった後」から
日刊AIニュース11月3日(火)号:前日のAIのニュース2本を短くまとめました(約4分)›
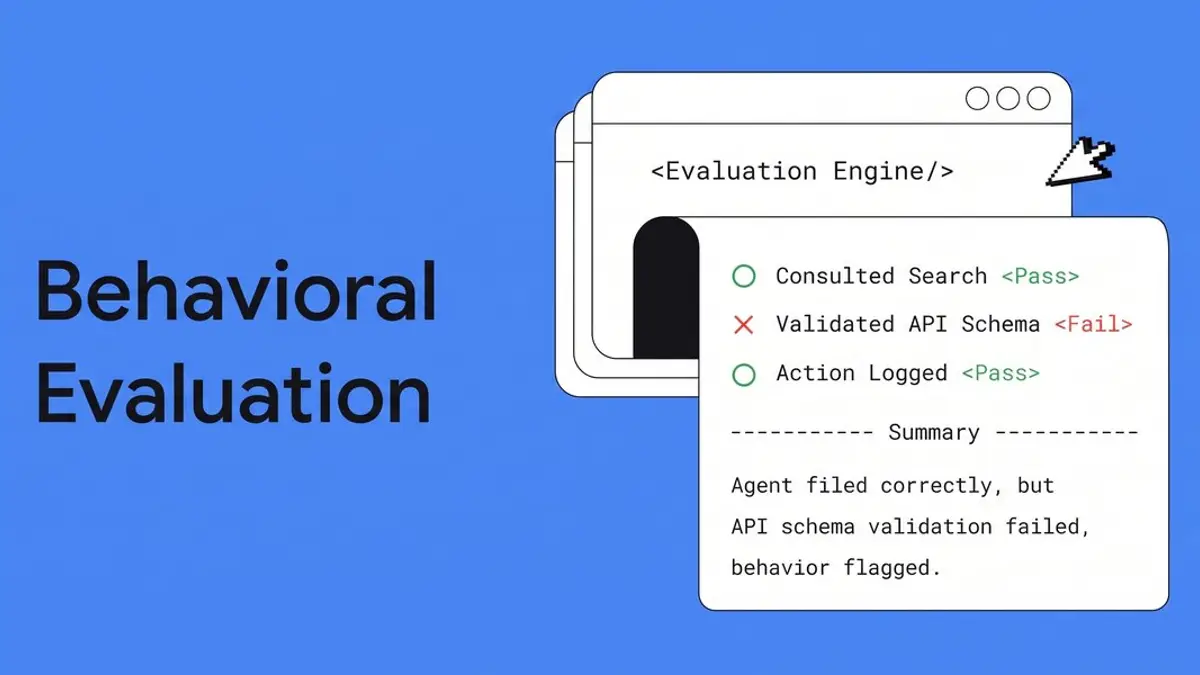
GoogleのTaylor Mullen氏(Principal Engineer)とChristian Gunderman氏は2026年9月9日、AIコーディングエージェントのハーネスを作る際の評価の考え方を公開した。Terminal-BenchやDeepSWEのようなエンドツーエンドのベンチマークは総合点が動いた理由(曖昧な指示で過信したのか、テストを回し忘れたのか、CLIのフラグを捏造したのか)を教えない。代わりに「曖昧な指示で聞き返すか」「ビルドファイルを変えたら検証を回すか」「文書に正規のリポジトリリンクを付けるか」といった観測可能な行動を統合テストのように断言する「行動評価」を勧める。例はAntigravity SDKとpytestで、天気を聞かれたらSEARCH_WEBを呼んだかをツール呼び出しで確認する。評価はドッグフーディングで自分のコードベースを扱えるようになった後に導入し、直近の失敗を1つ選ぶ→単純な課題は厳格な断言、複雑な課題はLLM判定→バッチで合格率の推移を見る。エンドツーエンドの補完であって置き換えではない。
2026年9月18日・日本時間時点の情報です。 Google Developersのブログ(9月9日)を読んだ。当サイトのハーネス・エンジニアリングとはで概念を扱ったが、「作ったハーネスをどう測るか」の実務はこの記事が具体的なので残す。
3行まとめ
- 問題の立て方。 ハーネスを作り始めた開発者は、Terminal-BenchやDeepSWEのようなエンドツーエンドのベンチマークを回し、総合点が数ポイント動くのを見て、なぜ動いたか分からないという罠に落ちる。点が下がった時、曖昧な指示にモデルが過信したのか、提出前にテストを回し忘れたのか、CLIのフラグを捏造したのか──総合点は答えない。エージェントを「試験を受ける学生」のように採点するのをやめ、ハーネスを単体・統合テストが要る普通のソフトウェアとして扱え、というのが主張。
- 行動評価とは。 複数ファイルのリファクタを解けたかではなく、離散的で観測可能な行動を断言する。「指示が曖昧なとき、推測せず聞き返すか」「ビルドファイルを変えたとき、完了を宣言する前にローカルの検証を回すか」「文書を生成するとき、正規のリポジトリリンクを付けるか」。例はAntigravity SDK+pytestで、「Mountain Viewの天気は」と聞いて
response.tool_callsにSEARCH_WEBが含まれるかを断言する(応答の文面ではなくツール呼び出しを見る)。行動評価が揃えば、LLMに自分のシステムプロンプトを書き換えさせ、落ちているテストが通るまで回す一方で他のテストをCI風のガードレールにする、というプロンプト工学の自動化もできる。- いつ・どう始めるか。 最初から評価基盤を組まず、まず勘とドッグフーディングで進める。エージェントが自分のコードベースを扱い、ボイラープレートを処理し、自前のMarkdownレンダラーを書き、日常の開発作業をこなせるようになるまで、評価を回す意味はない。評価は第2段階の道具で、目的は「2%良くなった」と喜ぶことではなく、プロンプトの微調整・ツールスキーマの変更・モデルの更新が全体を悪くしていないという確信。手順は3つ。①直近の失敗を1つ選ぶ(テストを回さず完了にした等)。②単純な課題は「テストランナーを呼んだか」の厳格な単発断言、複雑な課題は正しい別経路があり得るので固定のツール順序を強制せずLLM-as-a-judgeで結果を緩く判定。③モデルは非決定的なのでPR単位の単発評価でブロックせず、バッチで合格率の推移を追う。ローカルの行動評価は
pytest evals/behavioral/ -vで5秒以内。
総合ベンチを補う位置づけ
- 「聞き返すか」「検証を回すか」は当サイトがCodexの使い方やAIエージェントの作り方で書いてきた運用上の悩みそのもので、それをテストコードに落とす、という話
- AI Agents Challengeの4設計にあった「フォールバックも同じ検証を通す」は、ここでいう行動評価の対象になる
- 総合ベンチマークの限界はSWE-Benchの監査でも別の角度から出ている。記事自身も「行動評価はエンドツーエンドの置き換えではなく補完」と結ぶ
- 例はAntigravity SDK固有だが、断言の対象(ツール呼び出し・ファイル変更)は他のSDKでも同じ
コード例は確認、自分では未実装
この記事の下調べで、筆者は9月18日にGoogle Developersのブログを取得し、行動評価の3つの例・pytestのコード・3ステップ・「5秒以内」の記述がその原文にあることを確認した。リンク先のリポジトリは開いていない。筆者はAntigravity SDKで評価を書いていない。
件数・判定コスト・スコアは不明
- Google社内で行動評価が何件あるか
- LLM-as-a-judgeに使うモデルと費用
- Terminal-Bench・DeepSWEの具体的なスコア
参照したハーネス評価の原文
- The Anatomy of Harness Engineering: How to Evaluate, Iterate, and Guard AI Coding Agents(Google Developers・2026年9月9日)
関連記事
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
ハーネスエンジニアリングとは何か 「エージェント=モデル+ハーネス」という考え方
ハーネスエンジニアリングとは何か「エージェント=モデル+ハーネス」という考え方
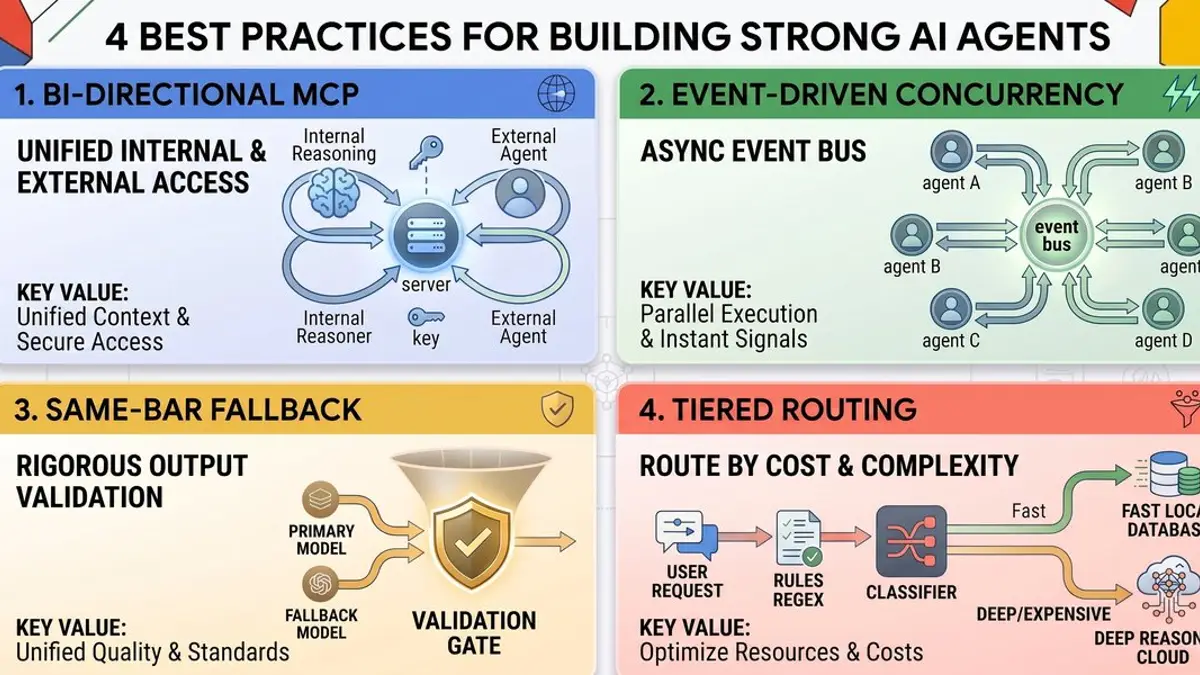
Google「AI Agents Challenge」上位に共通した4つの設計 ①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google「AI Agents Challenge」上位に共通した4つの設計①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
 動画
AIコーディングベンチマークの3割は壊れていた OpenAIが自ら暴いたSWE-Bench Proの監査結果
AIコーディングベンチマークの3割は壊れていたOpenAIが自ら暴いたSWE-Bench Proの監査結果
Codex(コーデックス)とは OpenAIのコーディング用AIエージェント、FreeとGoでも使えるが量に上限、料金はPlus月3,000円・Pro月16,800円から。使い方・アプリ・CLI【2026年10月版】
Codex(コーデックス)とはOpenAIのコーディング用AIエージェント、FreeとGoでも使えるが量に上限、料金はPlus月3,000円・Pro月16,800円から。使い方・アプリ・CLI【2026年10月版】
AIエージェントの作り方【2026年9月版】 ノーコード(Dify・Lindy)、SDK(Claude Agent SDK・OpenAI Agents SDK・Google ADK・LangGraph)、任せる型(OpenAI Agents API・Claude Managed Agents)の3段階と、最初の1本を動かすまでのコード、暴走と課金を止める4つの安全装置
AIエージェントの作り方【2026年9月版】ノーコード(Dify・Lindy)、SDK(Claude Agent SDK・OpenAI Agents SDK・Google ADK・LangGraph)、任せる型(OpenAI Agents API・Claude Managed Agents)の3段階と、最初の1本を動かすまでのコード、暴走と課金を止める4つの安全装置
 動画
Gemini 4 Argon(ジェミニ4 アルゴン)の使い方 考える強さは3段階で試して一番低い段階、temperatureは無視、出力の上限は3万2768以上、Googleが/goalで11時間走らせた頼み方
Gemini 4 Argon(ジェミニ4 アルゴン)の使い方考える強さは3段階で試して一番低い段階、temperatureは無視、出力の上限は3万2768以上、Googleが/goalで11時間走らせた頼み方
Google Labs「Julesで測るべきもの」 コーディングエージェントは「頼まれたタスク」から「目標」へ。SWE-Benchは課題の完了しか測れないので、社内の705件のバグ(1,178 CL)を時間的近接と意味的類似で束ねて「目標」の正解を作り、修正前の状態に戻してエージェントに探索させLLMで5段階採点。1回の探索で平均4.5、探索を2回→3回にするとHit@5が33%→57%
Google Labs「Julesで測るべきもの」コーディングエージェントは「頼まれたタスク」から「目標」へ。SWE-Benchは課題の完了しか測れないので、社内の705件のバグ(1,178 CL)を時間的近接と意味的類似で束ねて「目標」の正解を作り、修正前の状態に戻してエージェントに探索させLLMで5段階採点。1回の探索で平均4.5、探索を2回→3回にするとHit@5が33%→57%