Gemini 4 Argon(ジェミニ4 アルゴン)の使い方考える強さは3段階で試して一番低い段階、temperatureは無視、出力の上限は3万2768以上、Googleが/goalで11時間走らせた頼み方
Googleの公式ドキュメントによると、Gemini 4 Argonの考える強さ(thinking_level)はlow・medium・highの3段階で既定はmedium。3段階で試して品質に届く一番低い段階を選ぶよう勧めている。temperature・top_p・top_kは無視され、thinking_budgetなど5つの設定はエラーになる。出力の上限は考える分を含むので3万2768以上が推奨。Google Developers Blogは、1段落のゴールとチームの決まりと/goalでArgonを11時間無人で走らせ、ADKの下準備を約40%短くした頼み方を原文つきで公開した。
目次
2026年10月14日朝・日本時間時点の情報です。Googleは、10月14日に一般公開した Gemini 4 Argon(ジェミニ4 アルゴン) をうまく使うための推奨を、Gemini APIとGoogle Cloudの開発者向けドキュメントに載せている。Google Developers Blogには、Googleの社員がArgonに20万行を超えるPythonのコードを一晩で速くさせた時のプロンプトの原文も出た。この記事では、それらをAI時短ラボが突き合わせて、考える強さの選び方、無視される設定、出力の上限、長い出力、プロンプトの書き方、Googleの頼み方の順に整理した。同じ内容を動画でも解説している。
3行まとめ
- 考える強さ(thinking_level)はlow・medium・highの3段階で既定はmedium。Googleは「3段階で試して、品質に届く一番低い段階を選ぶ」よう勧めている。考えた分も出力として課金される。
- temperature・top_p・top_kは無視され、thinking_budget・MINIMALなど5つの設定はエラーになる。出力の上限(max_output_tokens)は考える分を含むので3万2768以上にし、減らしたい時は考える強さを下げる。
- Googleは、1段落のゴール+チームの決まり(.agents/skills)+Antigravityの/goal+「前後の数字つきのプルリクエストを1本」の2文で、Argonを11時間無人で走らせた。ADKの長い会話の下準備は約40%短くなった。
| 項目 | 内容(出典) |
|---|---|
| モデルID | gemini-4-argon(Gemini API・Google Cloud) |
| 考える強さ | low/medium(既定)/high(What's new in Gemini 4 Argon) |
| 窓の大きさ | 入力・思考・出力で分け合う1,048,576トークン(同) |
| 1回の出力 | 考える分を含めて既定・最大65,536トークン。backgroundで最大100万トークンまでつなげる(Thinking・Long decode) |
| 無視される設定 | temperature・top_p・top_k(Prompting strategies・Google Cloud) |
| エラーになる設定 | thinking_budget・MINIMAL・frequency_penalty・presence_penalty・candidate_count(Google Cloud) |
| キャッシュ | 手動のキャッシュは使えない。同じ書き出しは自動でキャッシュされ、入力が95%引き(What's new) |
| API料金 | 2026年11月30日まで入力2ドル・出力10ドル、12月1日から入力4ドル・出力20ドル(100万トークンあたり・出力は考えた分を含む/What's new) |
材料はどこから──Gemini 4向けの節は、設定の話だけ
中心になるのは、Gemini APIのドキュメントにある「What's new in Gemini 4 Argon」というページだ。そこから「Long decode(長い出力)」と「Thinking(考える強さ)」のページにつながっている。Google Cloud側には「Developer's guide to Gemini 4 Argon」があり、エラーになる設定や会話の決まりはこちらのほうが細かい。
プロンプトの書き方については、10月14日朝に取得したGemini APIの「Prompting strategies」のページでは、書き方の節の見出しは「Gemini 3」のままだった。このページの書き方の中身でGemini 4の名前が出るのは、temperatureなどの設定が無視されるという注意書きだけだ。なので、書き方はGemini 3向けの節を使うことになる。
ドキュメントの多くはAPIで使う開発者向けだが、考える強さの選び方はAntigravityで使う人にも関係する。AI時短ラボのGoogle AI Ultraの環境では、AntigravityでArgonの考える強さをLow・Medium・Highの3つから選べた。
考える強さ(thinking_level)──3段階で試して、品質に届く一番低い段階を選ぶ
What's new in Gemini 4 Argonの表をまとめるとこうなる。
| 段階 | 使う量と速さ | 向いている仕事 |
|---|---|---|
| low | トークンが最少・返事が最速 | 簡単な仕事・費用を抑えたい仕事。軽く考えれば済む分析や文章にも使える。難しい仕事では質が落ちることがある |
| medium(既定) | バランス | 複雑なコードやエージェントの仕事を含む、ほとんどの仕事 |
| high | トークンが最多・最初の1文字が最も遅い | 難しい推論、難しい数学や科学、一番難しいコードやエージェントの仕事。長い出力と組み合わせる |
Google Cloudのガイドはもう少し具体的で、highは何ファイルにもまたがるソフトウェア開発・証明・設計・脆弱性探し、mediumは普段のコード・道具を使う仕事・資料への質問・動画の理解、lowは分類・要約・メタデータの抜き出し、と書いている。
迷ったら全部highにすればよさそうに見えるが、公式の勧めは逆だ。
Run your evaluations at all three levels, then pick the lowest level that meets your quality bar.
(3つの段階すべてで評価を回して、品質の基準を満たす一番低い段階を選んでください。)
料金の面でも理由がある。What's newの料金欄では、出力の料金に考えた分のトークンが含まれる("Output tokens, including thinking tokens")。強さを上げれば、そのぶん払う。
Argonで無視される設定と、エラーになる設定
ここからはAPIで使う人向けの話だ。
- 無視される: temperature・top_p・top_k。Gemini APIの「Prompting strategies」によると、Gemini 4とGemini 3.6以降は入れた値を無視して、使わなくなる予定だという警告のヘッダーを返す。将来のリリースではエラーになると書かれている。答えの調整は、考える強さと構造化出力(response_schema)で行うようGoogle Cloudのページが案内している。
- エラーになる: thinking_budgetとMINIMALはHTTP 400エラー。Google Cloudの移行の表では、Gemini 3.1 Proは thinking_budget を近い段階に読み替えていたが("Mapped to a thinking level")、Argonでは読み替えずにエラーを返す。frequency_penalty・presence_penalty・candidate_countもエラーになるので、リクエストから消す。
- 手動のキャッシュは使えない: そのかわり、前と同じ書き出しは自動でキャッシュされ、キャッシュから読んだ入力は95%引きになる。毎回同じ長い資料(コードや文書)は、プロンプトの先頭に置くと得になる。
- 会話の決まり: Google Cloudのガイドによると、AIの返事の書き出しをこちらで先に書いておく使い方(プリフィル)はできず、会話の履歴をAIの発言で終わらせることもできない。
出力の上限は3万2768以上──減らしたい時は上限でなく考える強さを下げる
max_output_tokensは、考えた分と答えの分を合わせた上限だ。What's newはこう書いている。
Gemini 4 Argon can spend more of the limit on thinking than earlier models.
(Gemini 4 Argonは、前のモデルより上限の多くを考えることに使うことがあります。)
そのため、今の上限が3万2千より低いアプリは3万2768以上に上げるよう勧めている。Long decodeのページは、8192のような低い値だと考えている途中で止まると書く。上限を下げても考え方は短くならない。
Lowering it doesn't make the model think more concisely, and instead cuts the response off sooner.
(上限を下げても、モデルが短く考えるようにはなりません。返事が早く途切れるだけです。)
トークンを減らしたい時は、考える強さを下げる。
6万5536トークンを超える長い出力の出し方と、使わない方がいい場面
1回で出せるのは、考えた分と合わせて65,536トークンまで。それを超える時は、続きを何回かに分けてつなぎ、入力の分を引いた100万トークンまで伸ばせる。Gemini APIでは、backgroundをオンにして上限を65,536より大きくすると、つなぎはサーバーが自動でやる。backgroundをオンにしても上限を決めていないと、64Kトークンで止まる。
Long decodeのページの目安はこうだ。
| 仕事 | 上限の目安 | background |
|---|---|---|
| 今の上限が3万2千より低いアプリ | 32,768に上げる | いらない |
| 長いコーディング・エージェントの仕事 | 65,536(既定)から | いらない |
| 難しい推論・数学・科学・証明 | 262,144から(最大は100万から入力を引いた分) | オン |
What's newのページは「Complex reasoning and coding」を131,072か262,144としていて、コーディングの目安がLong decodeのページと一段ずれている。この記事の表はLong decodeのページに合わせた。
逆に、この長い出力を使わない方がいい場面も書かれている。チャット・質問への答え・要約・分類・抜き出しは3万2千トークンよりずっと手前で終わる。道具を細かく何度も呼ぶエージェントは、1回ごとの出力が大きいと分け合う100万の枠がすぐ埋まる。すぐ返事がほしい用途は、長い出力が数分かかることがあるので向かない。待つ時間の上限は15分以上にするか、backgroundで動かすよう書かれている。
文字数の指定にも注意がいる。Long decodeの表では「70万語の本を書いて」のような依頼に、こう添えている。
The model doesn't follow length targets.
(モデルは長さの目標に従いません。)
だから頼む時は、何文字で、ではなく、何をどんな構成で書くかを伝えるほうが確かだ(ここはAI時短ラボの読み)。途中で切れた時も、「続けて」と送ったり途中までの答えを会話に足したりはせず、続き用のトークン(continuation_token)を付けて最初と同じ依頼を送り直す、とGoogle Cloudのガイドにある。公式のSDKはこれを自動でやる。
プロンプトの書き方──公式ページのGemini 3向けの節
前の節のとおり、Argon専用の節ではなくGemini 3向けの節の内容だ。
- 狙いをはっきり短く書く。相手を説得するような余計な言葉は入れない
- XMLのタグ(
<context>や<task>)か、Markdownの見出しで、指示・資料・質問を区切る。1つのプロンプトの中ではどちらかに統一する - 大事な制約・役割・答えの形は、システム指示かプロンプトの一番最初に置く
- 長い資料は先に全部渡し、質問は一番最後に置く。間に「Based on the information above...(上の情報をもとに)」のような一言を入れてつなぐ
- 何も言わないと、直接的で無駄のない答えを返す。詳しく、会話っぽく答えてほしい時はそう書く
- モデルが自分で考えるので、答えの中に計画や手順を書かせる必要は基本的にない。難しい問題なら「Think very hard before answering」のような簡単な一言で良くなることがあり、そのぶん考えるトークンは増える
4つ目の並べ方は、自動キャッシュのために長い資料を先頭に置く話と同じ向きになる。
Googleの社員がArgonを一晩11時間走らせた時の頼み方
Google Developers Blog(10月13日)は、GoogleがオープンソースのADK(エージェントを作るための道具)を、Argonに速くさせた記録を出している。約20万5千行・約800ファイル・約1万7千個のテストがあるPythonのコードだ。
1回目は、リポジトリの決まりを何も渡さず、1段落の指示だけで頼んだ。
Make ADK add no noticeable overhead to any agent: at startup, in long sessions, in multi-agent and workflow setups. Keep what the model receives and the public API unchanged, and back each change with a test that would catch a regression.
(どんなエージェントでも、起動時・長いセッション・複数エージェントやワークフローの構成で、ADKのせいで目立つ遅れが出ないようにして。モデルが受け取る中身と公開しているAPIは変えず、変更ごとに、壊れたら気づけるテストを付けて。)
記事によると、Argonは7分で速さを測るプログラムを書き、ADKのコードを最初に直したのは70分後だった。約2時間で本当に遅い所を見つけ、その一部は最終的に取り込まれた。一方で、チームの決まりを知らないまま認証の設定の公開しているJSONの形を変え、テストは近くの216個しか回さず、変更の説明に数字を書かなかった。
2回目は、2つを足した。 1つ目は、チームの決まりを .agents/skills に置いたこと。入口のSKILL.mdは短い目次だけにして、細かい中身は別のファイルに分け、必要な時だけ読ませた。毎回の文脈を埋めないためだ。2つ目は、Antigravityの /goal。記事は、会話が長くなって要約されてもゴールを持ち続け、終わるまで走らせる機能として使っている。そのうえで、完成の形を2文で足した。
Open one pull request against main that the ADK maintainers would approve, with before and after numbers in its description. Don't merge it.
(ADKのメンテナが承認するプルリクエストを、前後の数字を説明に入れて main に1本出して。マージはしないで。)
Argonは夜9時11分から朝8時19分まで、11時間無人で走った。始める前に決まりのファイルを12個読み、何も直す前に今の速さを測った。テストは全部の16,892個を回し、終わる3分前にも自分の変更を見直して自分で入れたバグを見つけ、自分で止まった。
朝に出てきた提案は32ファイルにまたがる6つで、取り込まれたのは2つ。捨てた4つは、別のセッションの古いデータを返しかねない仕組み、ライブラリの内部に頼る書き方、読みにくくなるだけの書き換え、試験用の再生でしか速くならない仕組みだった。記事はこの分担を「the agent explores, the maintainer subtracts(エージェントが探り、メンテナが削る)」と書いている。取り込んだ2つで、長い会話の下準備は約40%短くなり、ADKの読み込みは21%速くなった。この数字は、Argonに一度も見せていない別の測り方で確かめたものだという。
まとめると、Googleの頼み方は4つだ。
- ゴールと、変えてはいけない物を1段落で書く
- チームの決まりを、目次つきの手引き(.agents/skills)で渡す
- /goalで、終わるまで走らせる
- 出してほしい物の形(前後の数字つきのプルリクエストを1本・マージしない)を決める
/goalについて、Antigravityの公式ドキュメントは「Instructs the agent to work continuously until the specified objective is fully achieved.(指定した目標を完全に達成するまで、エージェントに作業を続けさせる)」と説明し、途中で1手ずつの確認を挟まないと書いている。先に計画を作らせたい時は /plan がある。Googleの発表記事は、Argonを行き詰まった時に勝手な近道をしないよう鍛え、取り返しのつかない操作の前には人の確認を待つようにした、とも書いている。
資料を突き合わせて気づいたこと
この動画と記事を作るために、Gemini APIとGoogle Cloudの2つのドキュメントを並べて読んだ。
- 自動キャッシュが働く最小の長さは、Gemini APIのページが4,096トークン、Google Cloudのガイドが6,144トークンで、ページによって値が違う。使うサービスのページの値を見るのが確かだ
- 長いコーディングの出力の上限の目安も、What's newとLong decodeのページで一段ずれている(上の表の下に書いた)
- プロンプトの書き方の節は、10月14日朝の時点ではGemini 3向けの見出しのままだった
ドキュメントが出たばかりなので、こうしたずれは今後そろう可能性がある。そろったらこの記事を直す。
このまとめで確かめていないこと
- この記事は公式の推奨の紹介で、AI時短ラボが3段階の考える強さを同じ課題で比べたわけではない。比べる検証は、動画で別に出す予定だ
- ADKの事例の数字(11時間・16,892個・約40%・21%など)は、Google Developers Blogに書かれた値で、こちらで再現はしていない
- 料金は Gemini API の標準の料金(2026年10月14日時点)。
Argonの検証や、ほかのAIとの比較もこのあと動画で出していく。やってほしい検証があれば、動画のコメント欄で教えてほしい。
この記事でよく聞かれること
- Gemini 4 Argonの考える強さ(thinking_level)はどれにすればいいですか?
- Gemini APIの公式ドキュメントによると、考える強さはlow・medium・highの3段階で、既定はmediumです。mediumは複雑なコードやエージェントの仕事を含むほとんどの仕事に勧められ、highは難しい数学や科学、一番難しいコードやエージェントの仕事、lowは簡単な仕事や費用を抑えたい仕事向けです。公式は、3段階すべてで評価して、求める品質に届く一番低い段階を選ぶよう書いています。
- Gemini 4 Argonでtemperatureは使えますか?
- Gemini APIの公式ドキュメントによると、Gemini 4ではtemperature・top_p・top_kに入れた値は無視され、使わなくなる予定だという警告が返ります。将来のリリースではエラーになると書かれています。出力の調整には、考える強さ(thinking_level)と、答えの形を決める構造化出力(response_schema)を使うよう案内されています。
- Gemini 4 Argonでエラーになる設定は何ですか?
- Google Cloudの開発者ガイドによると、thinking_budgetとthinking_levelのMINIMAL、frequency_penalty・presence_penalty・candidate_countはHTTP 400エラーになります。Gemini 3.1 Proではthinking_budgetを近い段階に読み替えていましたが、Argonでは読み替えずにエラーを返します。手動のキャッシュ(cached_content)も使えません。
- Gemini 4 Argonのmax_output_tokensはいくつにすればいいですか?
- max_output_tokensは考えた分と答えの分を合わせた上限です。Gemini APIの公式ドキュメントは、Argonは前のモデルより上限の多くを考えることに使うため、3万2768未満なら3万2768以上に上げるよう勧めています。8192のような低い値では考えている途中で止まります。トークンを減らしたい時は、上限でなく考える強さを下げます。長いコーディングやエージェントの仕事は既定の6万5536から、難しい数学・科学・証明はbackgroundをオンにして26万2144から始めるのが目安です。
- Googleは Gemini 4 Argon をどう頼んで11時間走らせたのですか?
- Google Developers Blogによると、ADK(約20万5千行のPython)を速くさせる時、1回目は1段落のゴールだけで約2時間走らせ、チームの決まりを知らずに公開の形を変えたり、近くの216個のテストしか回さなかったりしました。2回目はチームの決まりを.agents/skillsに置き、Antigravityの/goalを使い、マージしないプルリクエストを前後の数字つきで1本出すよう2文を足しました。Argonは11時間無人で走り、16,892個のテストを回して自分で止まり、6つの提案のうち2つが取り込まれました。
出典・参照資料
- 一次資料What's new in Gemini 4 Argon — Gemini API 公式ドキュメント ↗
- 一次資料Long decode — Gemini API 公式ドキュメント ↗
- 一次資料Thinking — Gemini API 公式ドキュメント ↗
- 一次資料Prompting strategies — Gemini API 公式ドキュメント ↗
- 一次資料Gemini 4 Argon(モデルページ)— Gemini API 公式ドキュメント ↗
- 一次資料Developer's guide to Gemini 4 Argon — Google Cloud 公式ドキュメント ↗
- 一次資料Get started with Gemini 4 — Google Cloud 公式ドキュメント ↗
- 一次資料Optimizing a 200,000-line Python codebase overnight with Gemini 4 Argon — Google Developers Blog(2026年10月13日) ↗
- 一次資料Slash commands — Google Antigravity 公式ドキュメント ↗
- 一次資料Gemini 4 Argon: Built to solve your hardest problems — Google公式ブログ ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
Google、Gemini 4 Argon(ジェミニ4 アルゴン)を世界で一般提供 API・Geminiアプリ・AIモードで、導入価格は入力$2・出力$10(100万トークンあたり)
Google、Gemini 4 Argon(ジェミニ4 アルゴン)を世界で一般提供API・Geminiアプリ・AIモードで、導入価格は入力$2・出力$10(100万トークンあたり)
Google、Gemini 4 Argon(ジェミニ4 アルゴン)に11時間の無人実行でADKを最適化させ、長いセッションの前処理を約40%短縮 6案のうち採用は2案
Google、Gemini 4 Argon(ジェミニ4 アルゴン)に11時間の無人実行でADKを最適化させ、長いセッションの前処理を約40%短縮6案のうち採用は2案
 動画
Gemini 4 Argonを発表 公式の比較表19項目のうち13項目で1位、出力の上限は100万トークン、最初に使えるのはサイバー防御の専門家だけ
Gemini 4 Argonを発表公式の比較表19項目のうち13項目で1位、出力の上限は100万トークン、最初に使えるのはサイバー防御の専門家だけ
GitHub、GoogleのGemini 4 Argon(ジェミニ4 アルゴン)をCopilotで一般提供 Pro+・Max・Business・Enterpriseが対象、8つの環境で選べて課金は従量制
GitHub、GoogleのGemini 4 Argon(ジェミニ4 アルゴン)をCopilotで一般提供Pro+・Max・Business・Enterpriseが対象、8つの環境で選べて課金は従量制
Google Antigravity(アンチグラビティ)とは 無料で使えるGoogleのAIエージェント開発環境。Antigravity 2.0(単体アプリ)・CLI(agy)・IDE拡張の3つの入口、無料/AI Pro/AI Ultraで変わる上限、日本で使えるか、Claude Codeなど他社ツールからのログインが規約違反になる理由
Google Antigravity(アンチグラビティ)とは無料で使えるGoogleのAIエージェント開発環境。Antigravity 2.0(単体アプリ)・CLI(agy)・IDE拡張の3つの入口、無料/AI Pro/AI Ultraで変わる上限、日本で使えるか、Claude Codeなど他社ツールからのログインが規約違反になる理由
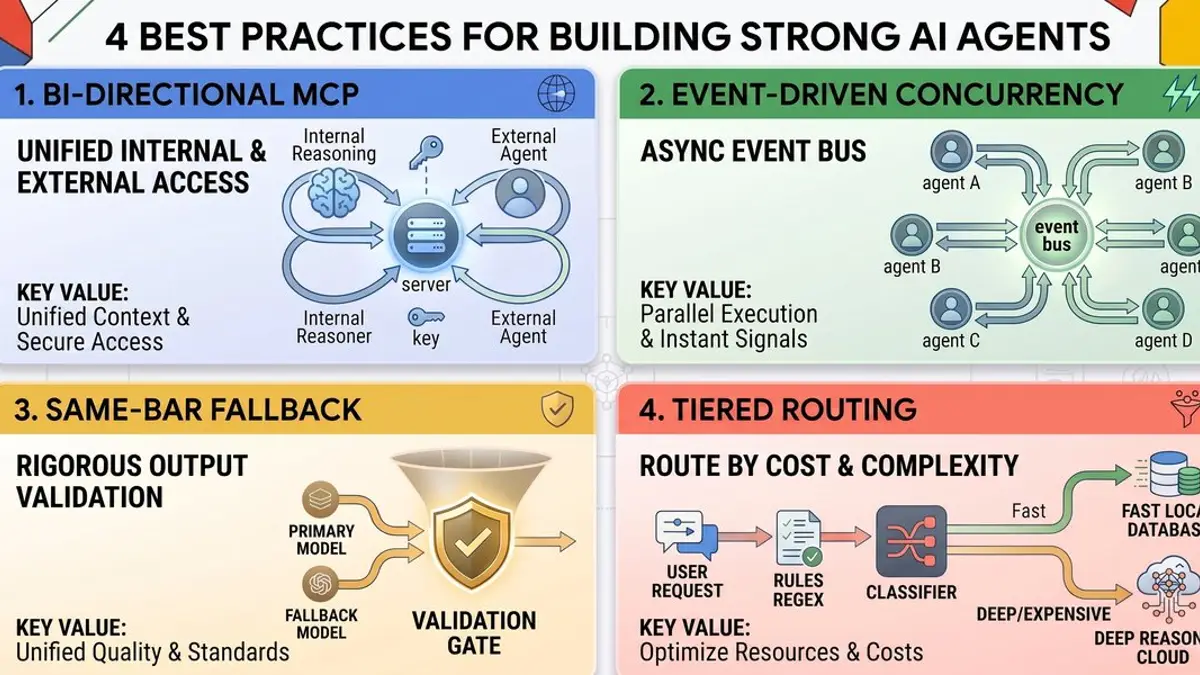
Google「AI Agents Challenge」上位に共通した4つの設計 ①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google「AI Agents Challenge」上位に共通した4つの設計①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Gemini Enterprise(ジェミニ エンタープライズ)とは Googleの会社・組織向けAIサービス、料金は1ライセンス月額$21から(公式ページの目安)。Agentspaceからの名前の変化、個人のGeminiアプリやWorkspaceとの違い、日本での対応【2026年10月版】
Gemini Enterprise(ジェミニ エンタープライズ)とはGoogleの会社・組織向けAIサービス、料金は1ライセンス月額$21から(公式ページの目安)。Agentspaceからの名前の変化、個人のGeminiアプリやWorkspaceとの違い、日本での対応【2026年10月版】