Google、Gemini 4 Argon(ジェミニ4 アルゴン)に11時間の無人実行でADKを最適化させ、長いセッションの前処理を約40%短縮6案のうち採用は2案
Googleは2026年10月13日、Gemini 4 Argonに約20.5万行のPython版Agent Development Kit(ADK)を11時間放置して最適化させた結果を公開した。長いセッションの最初のモデル呼び出し前の処理は約40%、import時間は21%短縮。6案のうち2案を採用し、4案はレビューで却下した。
目次
Googleは2026年10月13日(現地)、Gemini 4 Argon(ジェミニ4 アルゴン)に約20.5万行のPython版Agent Development Kit(ADK)を11時間無人で最適化させた記録をGoogle Developers Blogで公開した。Google発表によると、その結果ADKの長いセッションでの「最初のモデル呼び出しの前の処理」は約40%、import google.adk の時間は21%短くなった。Argonは6件の最適化を提案し、人間のレビューで採用されたのは2件、却下は4件だった。
3行まとめ
- Gemini 4 ArgonがPython版ADK(約205,000行・約800ファイル)を11時間の無人実行で最適化。50ターン後の最初のモデル呼び出しまでは64msから36msに、importは1.22秒から0.97秒に(Googleのコミット記載)。
- 提案6件(32ファイル)のうち採用2件(セッションのコピー削減・重いパッケージの遅延読み込み)、却下4件。最終は22ファイル・新規テスト17関数で、ADKのmainに入った。
- 条件は、リポジトリの
.agents/skillsに保守ルールを置くことと、Google Antigravity(アンチグラビティ)の/goalモード。数字はADKでの結果で、SQLiteやFirestoreなど外部のセッション保存先では読み取り時間は変わらないとGoogleは書いている。
本記事の内容は、日本時間10月14日1時台に公式ページで確認したものです。
何を、どんな条件で走らせたのか
Googleのブログによると、狙いは「新モデルの発表でよくある、空のフォルダーから作るデモ」ではなく、既存の大きなコードベースで無人のまま性能問題を直せるかを見ることだった。対象は、Googleのオープンソースのエージェント開発フレームワークであるgoogle/adk-python。ブログは規模を、約205,000行、ソースファイルは800弱、単体テストは17,000弱と書いている。
走らせ方は2回ある。
| 1回目 | 2回目(夜通し) | |
|---|---|---|
| 所要時間 | 約2時間 | 11時間 |
| リポジトリ固有の指示 | なし | .agents/skillsに保守ルールを配置 |
| 実行モード | 記載なし | Google Antigravityの/goalモード |
| テスト | 近傍の216件のみ | 全16,892件 |
| 成果物 | 保守ルールに合わない点が残った | レビューに出せるプルリクエスト |
1回目の指示は、段落ひとつだった。ブログが載せた原文は次のとおり。
Make ADK add no noticeable overhead to any agent: at startup, in long sessions, in multi-agent and workflow setups. Keep what the model receives and the public API unchanged, and back each change with a test that would catch a regression.
(ADKが、起動時・長いセッション・マルチエージェントやワークフローのどの場面でも、目に見える負荷をエージェントに足さないようにする。モデルが受け取る内容と公開APIは変えず、変更ごとに回帰を検出できるテストを付ける)
ブログによると、Argonは7分後にベンチマークのスクリプトを書き、ソースを1行も編集せずに70分かけて計測とコード読みを続けた。ただ、ADKの認証モデルに付けたフックが公開JSONスキーマを変えてしまうなど、保守側の慣習を知らないことによる問題が残った。そこで2回目は、保守ガイドラインを.agents/skillsに置いた。各スキルは短いSKILL.mdの目次から、必要なときだけ個別のreferences/ファイルを読ませる作りで、毎ターン文脈を埋めないようにしているという。
2回目は、目標を文脈の圧縮をまたいで保持する/goalモードを使い、指示に「ADKの保守者が承認するような、mainに向けたプルリクエストを1件出し、説明欄に前後の数字を書く」「マージはしない」という2文を足した。開始は午後9時11分(ブログに時間帯の記載はない)。
夜のあいだに何が起きたのか
ブログの記述では、翌朝にセッションログを見て目立った動きがあった。
- ソースを触る前に、ガイドライン12ファイルを読み、4種類の負荷(パッケージ起動、200ステップの会話、20個のサブエージェントが受け渡すアプリ、12ノードのワークフロー)の基準ベンチマークを30回走らせた
- 終了の3分前になっても自分の差分を点検し、マルチエージェントのキャッシュにあった自分のバグを見つけ、全16,892件のテストを回し直してから自分で止まった
採用された2件と却下された4件
プルリクエストには、32ファイルにわたる6件の最適化があった。ブログは、採用した2件を次のように説明している。
1. コピーの前に、メモリ上のセッション履歴を絞る。 従来のADKのInMemorySessionServiceは、読むたびに保存された会話全体をディープコピーしてから、呼び出し側が求めたイベントに絞っていた。イベントなしでセッション一覧を取る場合でも、先に全イベントをコピーしていた。Argonは、絞ってからコピーするように変え、さらにPydanticの汎用ディープコピーの代わりに、循環参照に安全な専用コピー処理を置いた。共有された状態の辞書とテスト用モックは保たれるという。
2. 重いパッケージを、使うときにだけ読む。 import google.adk は従来、基本的なテキストのエージェントでも、音声・映像のライブ配信、OpenTelemetryによる計装、Webサーバー(FastAPIとStarlette)のモジュールを引き込んでいた。ブログは、最上位のimportを消すだけでは、モジュールの属性を直接差し替える下流のテストが壊れると説明している。2回目のプルリクエストでは、llm_agent.pyから内部フローのimport3行を消したところ、オープンソースの16,892件はすべて通ったのに、Google社内のテストターゲット25件が失敗した。そのテストが、まさにその属性を差し替えていたからだ。出荷した修正は、遅延読み込みのアクセサを使い、重いパッケージは最初の利用時に読まれ、公開属性はテストが期待する場所で差し替え可能なまま残る。
却下された4件は、ブログによると次のとおり。
| 提案 | 却下の理由(Googleの説明) |
|---|---|
| マルチエージェントのイベントキャッシュ | 合成ベンチマークで17%速くなったが、弱参照に頼り、Pythonがガベージコレクション後にメモリアドレスを再利用するとセッションをまたいで古いデータを返しうる |
| テレメトリの確認 | OpenTelemetryのトレーサー実装の非公開属性を読んでおり、ライブラリのマイナー更新で黙って壊れうる |
| 会話履歴の整形の書き換え | 独立した保留ベンチマークでは全体の遅延が動かず、中核の経路が読みにくくなるだけ |
| ワークフローのイベント再生用の索引 | 状態管理が複雑になるわりに、日常のエージェント実行ではなく合成の再生テストにしか効かない |
ブログは分業をこう要約している。「エージェントが探索し、保守者が引き算する(the agent explores, the maintainer subtracts)」。1回目と2回目の良い部分を合わせた22ファイル・新規テスト17関数の変更が、ADKチームのレビューを経てmainに入り、コミットメッセージには「Argon generated these changes」と書かれた。
速くなったのは何で、どれくらいか
ブログによると、独立した保留ベンチマークbench_turn.pyはArgonに見せていない。モデルもツールも即答する設定なので、時計に出る時間はすべてADK自身の負荷になる。数字は6〜12回の中央値で、変更の前後でモデルに届くリクエストはバイト単位で同一だという。
GitHubのコミットメッセージに載る表は次のとおり(*はガベージコレクションを止めた測定)。
| 項目 | 前 | 後 | 変化 |
|---|---|---|---|
| 50ターン後の最初のモデル呼び出しまで* | 64 ms | 36 ms | −43% |
| 150ターン後の最初のモデル呼び出しまで* | 200 ms | 122 ms | −39% |
| 158ターンの全体 | 65.6 秒 | 56.1 秒 | −14% |
| 新しいプロセスでのADKのimport | 1.22 秒 | 0.97 秒 | −21% |
| 新しいプロセスから最初のモデル呼び出しまで | 3.07 秒 | 3.09 秒 | +1% |
ブログ本文の「約40%」は、50ターン後(43%減)と150ターン後(39%減)をまとめた言い方だ。見出しの数字は前処理だけの短縮で、158ターンを通した実行時間の短縮は14%(約9.5秒)である点は区別しておきたい。
読み方についてGoogleは、次の注意を書いている。
- importの21%短縮は、CLI、ローカル開発、テスト探索で全ADK利用者にすぐ効く。ただし遅延させたモジュールは最初のターンで読まれるため、新しいプロセスから最初のモデル呼び出しまでの時間は変わらない(3.07秒から3.09秒)。本番サーバーでは、実トラフィックを受ける前にウォームアップのリクエストを送るよう勧めている
- 前処理の約40%短縮は
InMemorySessionServiceが対象で、InMemoryRunner、ローカルの評価ループ、CIのテスト、外部データベースのURIを設定していないCloud RunやGKEの既定構成に当たる。外部データベース、SQLite、Gemini platform、Firestore、Redisのセッション保存先は、メモリ上のディープコピーではなく保存先からの復元なので、この読み取り時間は変わらない - 1回のLLM呼び出しが数秒かかる場面では、28ミリ秒(50ターン後)や78ミリ秒(150ターン後)の差を人は感じない。ただし158の内部ターンでは積み重なり、全体が65.6秒から56.1秒になる
ここでいう「ターン」は、ユーザーが入力して最終回答を得るまでの「呼び出し(invocation)」とは別で、エージェントがツールの呼び出し、並列ツール呼び出しのまとまり、MCPサーバーへの問い合わせのたびに進む内部の1歩を指す、とブログは定義している。
自分のリポジトリで試すには
ブログが示す再現の要素は2つだ。
- 保守ルールを
.agents/skillsに置く。短いSKILL.mdの目次から、必要なreferences/のファイルへ誘導する。ブログによると、Argonは作業を始める前に、非公開モジュール(_で始まる名前)の規則を書いたvisibility.mdと、遅延読み込みの確認を書いたimports.mdを読んだ - Google Antigravityで
/goalモードを有効にして、「mainに向けたプルリクエストを1件。マージはしない。説明欄に前後の数字」まで指示に含める
ブログはgoogle/adk-pythonの.agents/skillsの構成をコピーして使うよう勧めている。マージ済みのプルリクエストとベンチマークのコミットは、同じリポジトリで見られる。
どこで、いつから使えるのか
Googleのブログによると、Gemini 4 Argonは、Gemini platformのAPI(モデルID gemini-4-argon)、Google AI Studio、Google Antigravityで使える。
Google Cloudのモデル文書(最終更新は2026年10月13日 UTC)には、次の記載がある。
| 項目 | 文書の記載 |
|---|---|
| 提供段階・公開日 | GA、2026年10月13日 |
| コンテキストウィンドウ | 1,048,576トークン(入力・思考・出力で共有) |
| 入力 | テキスト、画像、音声、動画 |
| 出力 | テキスト |
| 思考レベル | LOW、MEDIUM(既定)、HIGH |
| 提供リージョン | global、マルチリージョンのus・eu |
同じ文書には、防御的なサイバーセキュリティ用途向けの派生モデル「Gemini 4 Argon Cyber Permissive」(モデルID gemini-4-argon-cyber-permissive)も載っている。こちらは許可リスト制で、申請は「Fairwind Program」か担当のGoogleチームに連絡する形だ。一般向けのArgonとは別の入口である。
筆者の観測を一つ書く。日本時間1時35分にこのGoogle Cloudの文書を取得したところ、取得できたのは英語のページで、言語の切り替えには「日本語」の項目があった(日本語版の中身は今回確認していない)。日本での提供や料金は、今回取得した3つのページ(ブログ、コミット、モデル文書)のどこにも載っていなかった。モデル文書は料金を別ページ(Pricing)へのリンクにしている。
この結果から言えないこと
- 数字の出どころはGoogle自身。 ベンチマークを書いたのも、結果を公開したのも、ADKを保守するGoogleのチームだ。第三者による再現は、本記事の時点で確認していない
- 対象はADKの1リポジトリ。 「約40%」はInMemorySessionServiceでの前処理、「21%」はADKのimportの数字で、どちらもモデルもツールも即答する条件で測っている。実際のモデル呼び出しが数秒かかるアプリで体感できる差とは別である。ブログ自身も、1回のLLM呼び出しでは28ミリ秒や78ミリ秒は感じ取れないと書いている
- 外部のセッション保存先には効かない。 外部データベース、SQLite、Gemini platform、Firestore、Redisのセッション保存先では読み取り時間は変わらない、とブログが書いている
- 無人で完結した話ではない。 6件のうち4件は人間のレビューで外れ、1回目には保守の慣習を知らないための問題が残った。ブログの結論も「エージェントが探索し、保守者が引き算する」である
- 筆者は試していない。 AI時短ラボは、Gemini 4 ArgonもAntigravityもADKのベンチマークも自分では動かしていない。本記事はGoogleの公開ページに書かれた内容の整理である
この件の出典と確認時刻
- Google Developers Blog: Optimizing a 200,000-line Python codebase overnight with Gemini 4 Argon(2026年10月13日付・日本時間10月14日1時35分に確認)
- GitHub: perf: cut time to first model request by 40% in long sessions(google/adk-python@1754b3e)(日本時間1時35分に確認)
- Google Cloud Documentation: Gemini 4 Argon(日本時間1時35分に確認)
Gemini 4 Argonの別の事例は、サイト内のロボット向け活用例の記事と、一般提供と導入価格の記事にまとめている。
本記事は続報があり次第更新します。
この記事でよく聞かれること
- Gemini 4 Argonは一晩で何をしたのですか?
- Google Developers Blogによると、GoogleはGemini 4 Argonに、オープンソースのPython版Agent Development Kit(ADK、約205,000行・約800ファイル)の性能改善を11時間、人が付かない状態で実行させました。提案は6件・32ファイル。レビューで2件を採用し、4件を却下しました。採用分を含む22ファイルの変更が、2026年10月13日付の記事の時点でmainに取り込まれています。
- どれくらい速くなったのですか?
- ADKのコミットメッセージに載るベンチマーク(6〜12回の中央値、モデルとツールは即答する設定)では、50ターン後の最初のモデル呼び出しまでが64msから36msへ43%減、150ターン後が200msから122msへ39%減、ADKのimportが1.22秒から0.97秒へ21%減でした。158ターンの全体は65.6秒から56.1秒で14%減です。新しいプロセスから最初のモデル呼び出しまでは3.07秒から3.09秒でほぼ変わっていません。
- 自分のコードでも同じ手順を試せますか?
- Googleのブログは、リポジトリの.agents/skillsに保守のルールを置き、Google Antigravityの/goalモードで目標を固定して走らせる方法を紹介しています。ブログはgoogle/adk-pythonの.agents/skills構成をコピーして使うよう案内しています。ただし、今回の数字はADKという1つのリポジトリでの結果で、他のコードで同じ効果が出るかは本記事では確認していません。
- Gemini 4 Argonはどこで使えますか?
- Googleのブログによると、Gemini platformのAPI(モデルIDはgemini-4-argon)、Google AI Studio、Google Antigravityで使えます。Google Cloudのモデル文書では、提供段階はGA、公開日は2026年10月13日、提供リージョンはglobalとus・euのマルチリージョンです。日本での提供や料金は、今回確認した3つのページには書かれていません。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Google DeepMind「クライアントSDKの生成はオープンであるべき」 2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守
Google DeepMind「クライアントSDKの生成はオープンであるべき」2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守
Google「A2UI+MCP Apps」 エージェントの画面を「宣言的なJSON(A2UI)」で描くか「iframeのWebアプリ(MCP Apps)」で描くかの二択を組み合わせる3つの型。①MCPサーバーがapplication/a2ui+jsonを返しホストがネイティブ描画②MCP AppをA2UI部品に埋めて要点だけ同期③MCP App内にA2UI描画器を入れて旧システムに生成UI
Google「A2UI+MCP Apps」エージェントの画面を「宣言的なJSON(A2UI)」で描くか「iframeのWebアプリ(MCP Apps)」で描くかの二択を組み合わせる3つの型。①MCPサーバーがapplication/a2ui+jsonを返しホストがネイティブ描画②MCP AppをA2UI部品に埋めて要点だけ同期③MCP App内にA2UI描画器を入れて旧システムに生成UI
Gemma 4 12BをMacのローカルで「エージェント用の土台」にする Google AI Edgeの手順。LiteRT-LM CLIの新コマンド`serve`でOpenAI互換のローカルサーバーを立て、OpenClaw・Hermes・OpenCode・Aiderをそのまま向ける。AI Edge GalleryのmacOS版はPythonを書いて実行、Eloquentは音声で書き換え
Gemma 4 12BをMacのローカルで「エージェント用の土台」にするGoogle AI Edgeの手順。LiteRT-LM CLIの新コマンド`serve`でOpenAI互換のローカルサーバーを立て、OpenClaw・Hermes・OpenCode・Aiderをそのまま向ける。AI Edge GalleryのmacOS版はPythonを書いて実行、Eloquentは音声で書き換え
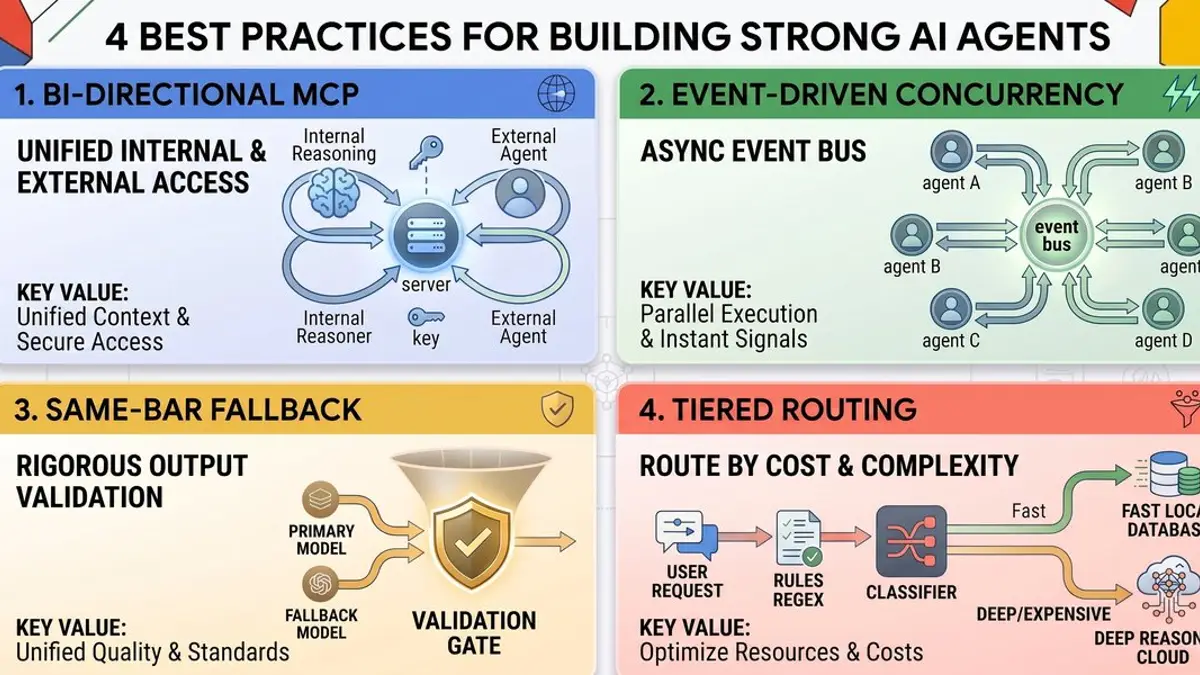
Google「AI Agents Challenge」上位に共通した4つの設計 ①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google「AI Agents Challenge」上位に共通した4つの設計①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google「autofinetune」 仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
Google「autofinetune」仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
Google「ADK for Kotlin 1.0」が正式版 Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
Google「ADK for Kotlin 1.0」が正式版Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
Agent Client Protocol(ACP)とは コーディングエージェントを「LSPのように」つなぐ標準規格
Agent Client Protocol(ACP)とはコーディングエージェントを「LSPのように」つなぐ標準規格