Google Labs「Julesで測るべきもの」──コーディングエージェントは「頼まれたタスク」から「目標」へ。SWE-Benchは課題の完了しか測れないので、社内の705件のバグ(1,178 CL)を時間的近接と意味的類似で束ねて「目標」の正解を作り、修正前の状態に戻してエージェントに探索させLLMで5段階採点。1回の探索で平均4.5、探索を2回→3回にするとHit@5が33%→57%
Google LabsのNghi Bui氏らは2026年6月22日、論文「Agentic Coding Needs Proactivity, Not Just Autonomy」の考え方を解説した。AIコーディングエージェントは、頼まれたら動く反応型から、文脈を取り込みリスクを見つけて開発者が聞く前に診断を出す能動型へ移っており、その評価には「何が重要か、どの証拠が支えるか、開発者を中断するか黙るか」を決める「洞察ポリシー」の採点が要る。SWE-Benchのような公開ベンチマークは定義済みタスクの完了を測るだけで、目標のベンチマークは存在しない。そこでGoogle社内コードベースの705件のバグ(1,178 CL)を時間的近接と意味的類似で束ねて目標の正解を作り(例:「サンドボックス実行の信頼性強化」)、コードを修正前の状態へ戻してエージェントに最大3回探索させ、予測した洞察をLLMが1〜5で採点。1回の探索で平均4.5、探索を2回から3回にするとHit@5は33%から57%に上がった。次は公開GitHubのissueとPRへ拡張。
2026年9月18日・日本時間時点の情報です。 Google Developersのブログ(6月22日)を読んだ。3か月前の記事だが、「頼まれていないことをエージェントがどれだけ正しく言えるか」を測る方法は、CodexのゴールモードやClaude Codeのコーディネーターが出た今のほうが読む価値があるので残す。
3行まとめ
- 何を測りたいか。 コーディングエージェントは、頼まれたタスクを完了する反応型から、文脈を取り込み続け、リスクを見つけ、開発者が聞く前に診断を出す能動型へ移っている。中心にあるのは「定義済みのタスク」から「目標」への転換で、目標にはコードベースの探索・関連するものの発見・高次の目的へ導く観測の提示が要る。SWE-Benchのような公開ベンチマークは狭く定義されたバグ修正の完了を測るが、目標のベンチマークは存在しない。論文は、能動型エージェントは洞察ポリシー──何が重要か、どの証拠が支えるか、開発者を中断するか黙るか──で採点すべきだと主張する。
- 正解をどう作るか。 チームが短期間に起票・修正した関連バグは、1つの取り組みの症状であることが多い、という仮説。「サンドボックスのタイムアウト」「ブローカー設定の失敗」「ネットワーク隔離の不安定テスト」は個別にはタスクだが、束ねると**「サンドボックス実行の信頼性を強化する」という目標を表す。Google社内コードベースの705件のバグ(1,178 CL)を時間的近接と意味的類似で束ね、各バグを正解にし、コードを修正前の状態に戻してエージェントに人間のエンジニアと同じ出発点を与える。探索は最大3ラウンド**(探索予算N)で、予測した洞察をLLMが1(無関係)〜5(一致)で採点し、平均の最高点とHit@K(上位K件に正解が入る率)で測る。
- 結果。 1回の探索で平均4.5/5の洞察を安定して出し、単純な問題の主信号は拾えた。複雑で多面的な問題は難しいが、探索予算を2ラウンドから3ラウンドに増やすとHit@5が33%から57%に戻った──追加の探索が最初に見落とした二次信号を拾う。これは初期サンプルの予備結果で、次は公開GitHubのissueと解決PRへ広げ、課題管理・会話・設計文書のような文脈も取り込む。論文本文は別途、進捗はlabs.google/codeで。
正解データの作り方と評価の限界
- 「探索を1回増やすと正解率が跳ねる」は、Codexのゴールモードのように長く動くエージェントが「回数を使う」ことの根拠になる数字だが、社内データ705件の予備結果である点は割り引く
- 正解の作り方(過去のバグを束ねる)は「人間が後で直したもの」を基準にしているので、人間が見落とした問題は正解に入らない。能動型の価値の一部はそこにあるはずで、ベンチマークの限界でもある
- SWE-Bench系の限界はSWE-Benchの監査で別の角度から扱った。ハーネス・エンジニアリングの解剖の「行動評価」とも補完関係にある
- 記事の題はJulesだが、本文の実験がJules本体で行われたかは明記されていない(「Google Labsの継続的AIシステムの研究」とある)
原文の数字は確認、再現はせず
この記事の下調べで、筆者は9月18日にGoogle Developersのブログを取得し、705件・1,178 CL・最大3ラウンド・1〜5採点・平均4.5・33%→57%・公開GitHubへの拡張予定がその原文にあることを確認した。論文本文は開いていない。筆者はJulesでこの評価を再現していない。
掲載先・モデル名・他の指標は未記載
- 論文の掲載先
- 使ったエージェントとモデルの名前
- Hit@1やHit@3など他の数字
参照したGoogle公式記事
- Measuring What Matters with Jules(Google Developers・2026年6月22日)
関連記事
出典・参照資料
AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事
AIコーディングベンチマークの3割は壊れていた──OpenAIが自ら暴いたSWE-Bench Proの監査結果
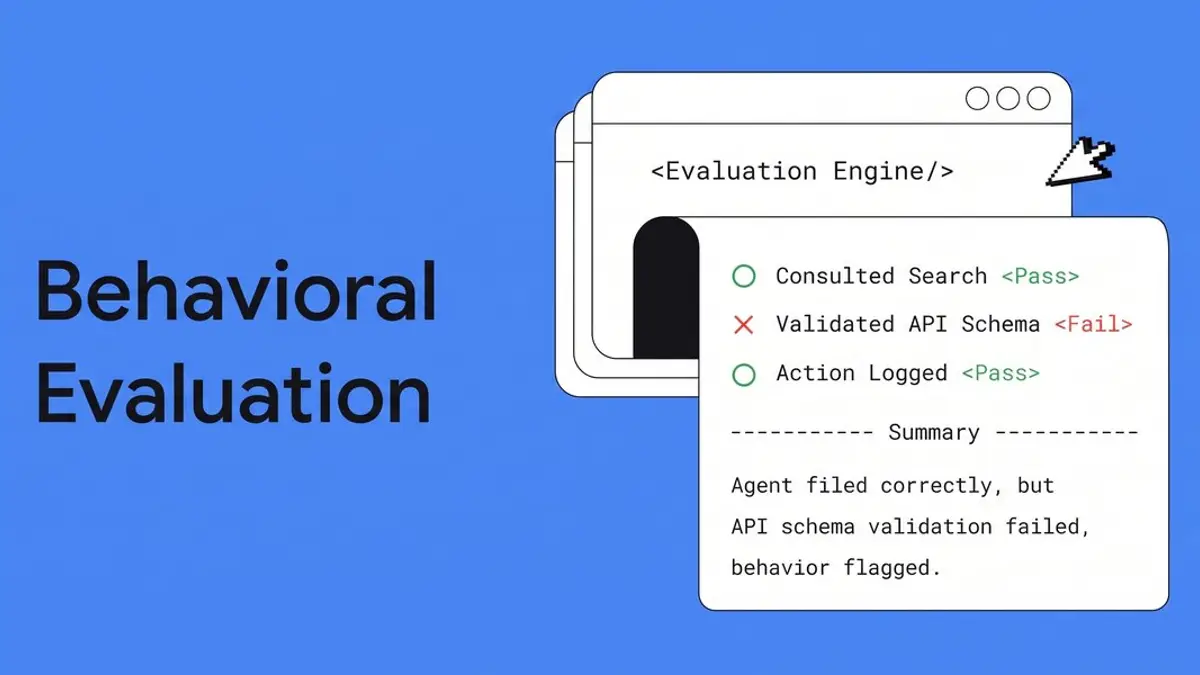
Google「ハーネス・エンジニアリングの解剖」──Terminal-BenchやDeepSWEの総合点が数ポイント動いても「なぜ」は分からない。「曖昧な指示で聞き返すか」「ビルドファイルを変えたら検証を回すか」を単体テストのように断言する「行動評価」を、Antigravity SDK+pytestで5秒以内に回す。評価は「ドッグフーディングで自分のコードベースを扱えるようになった後」から
CodexのGoal Modeが実験段階を終えた──公式ドキュメントで確認できる「/goal」の使い方
Claude Codeの「プロジェクト」が再設計──目標を渡すと、コーディネーターがスレッド(=クラウドのClaude Codeセッション)に仕事を割り振り、並列でPRを開いて結果を組み立てる。9月17日からPro・Maxの一部でベータ、既存プロジェクトはそのまま
Google「autofinetune」──仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
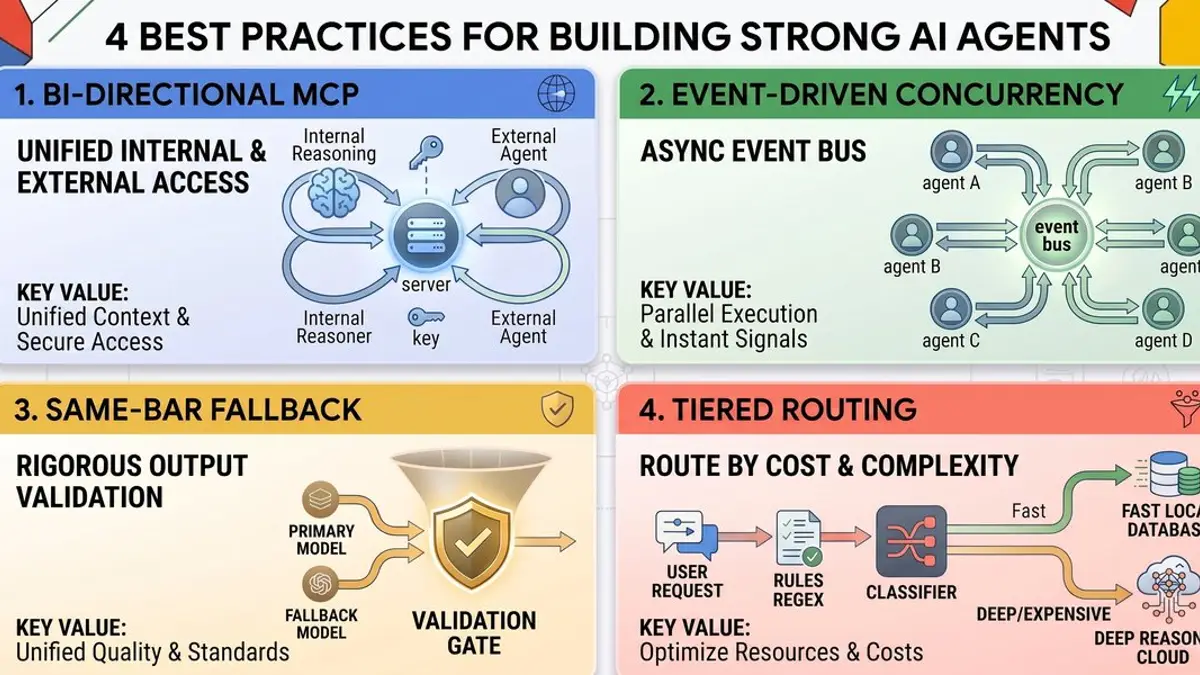
Google「AI Agents Challenge」上位に共通した4つの設計──①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google DeepMind「クライアントSDKの生成はオープンであるべき」──2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守