DeepSeekが推論フレームワーク「DeepInfer」を公開本番で使っている仕組みの中身と、安さの理由
日刊AIニュース10月21日(水)号:前日のAIのニュース18本を短くまとめました(約11分)›
DeepSeekは2026年10月20日、自社のAIを本番で動かしている推論フレームワーク「DeepInfer(ディープインファー)」をApache 2.0で公開した。1年半前の2025年4月には「社内の推論エンジンを丸ごと出すのは難しい」と書いていた本体で、1つのクラスタで1日155兆トークンを処理しているという運用の数字も一緒に出した。記憶の倉庫の管理など3か所は今回も出していない。
目次
DeepSeekは2026年10月20日、自社のAIを本番で動かしている推論フレームワーク「DeepInfer(ディープインファー)」を、Apache 2.0のオープンソースでGitHubに公開した。1年半前の2025年4月には「社内の推論エンジンを丸ごと公開するのは難しい」と自分で書いていた、その本体だ。公開と一緒に出た運用のQ&Aには、1つのクラスタで1日155兆トークンを処理しているという数字まで載っている。大規模なモデルを本番で回す仕組みが、ここまで読める形で出てくるのはめったにない。動画での解説は YouTube(AI時短ラボ) にある。
3行まとめ
- DeepSeekが10月20日、DeepSeek-V4.1-Flashを本番で動かしている推論フレームワーク「DeepInfer」をApache 2.0で公開。トークンの受付を受け持つ「deepseek-recipe」も同時に出した。社内版との速さの差は「最大5%」とQ&Aに書いている。
- 記憶(KVキャッシュ)の仕組み・読む処理と書く処理のつなぎ・振り分けの3つは、社内の基盤と強く結びついているとして今回も出していない。
- Q&Aと技術報告から、安さの仕掛けが読める。1トークンの記憶は初代の437分の1の890バイト、記憶はSSDの倉庫(約100ペビバイト)にチャット7日・エージェント3日しまう。1つのクラスタで1日155兆トークン、売上はGPU 1枚1時間あたり38ドル(半額の時間帯の値段で)。
本記事は、日本時間2026年10月21日に確認したDeepInferのREADME・推論デプロイQ&A・DeepSeek-V4.1-Flashの技術報告・DeepSeek APIの料金ページの原文にもとづく。
| 項目 | 内容(出典) |
|---|---|
| 公開 | 2026年10月20日(GitHubの最初のコミットは04:09 UTC、公式Xの投稿は18:30 日本時間) |
| ライセンス | Apache 2.0(README) |
| 対応するモデル | DeepSeek-V4.1-Flash だけ(README) |
| 対応する機械 | NVIDIA SM100 の GPU・Huawei Ascend 950 の NPU(README) |
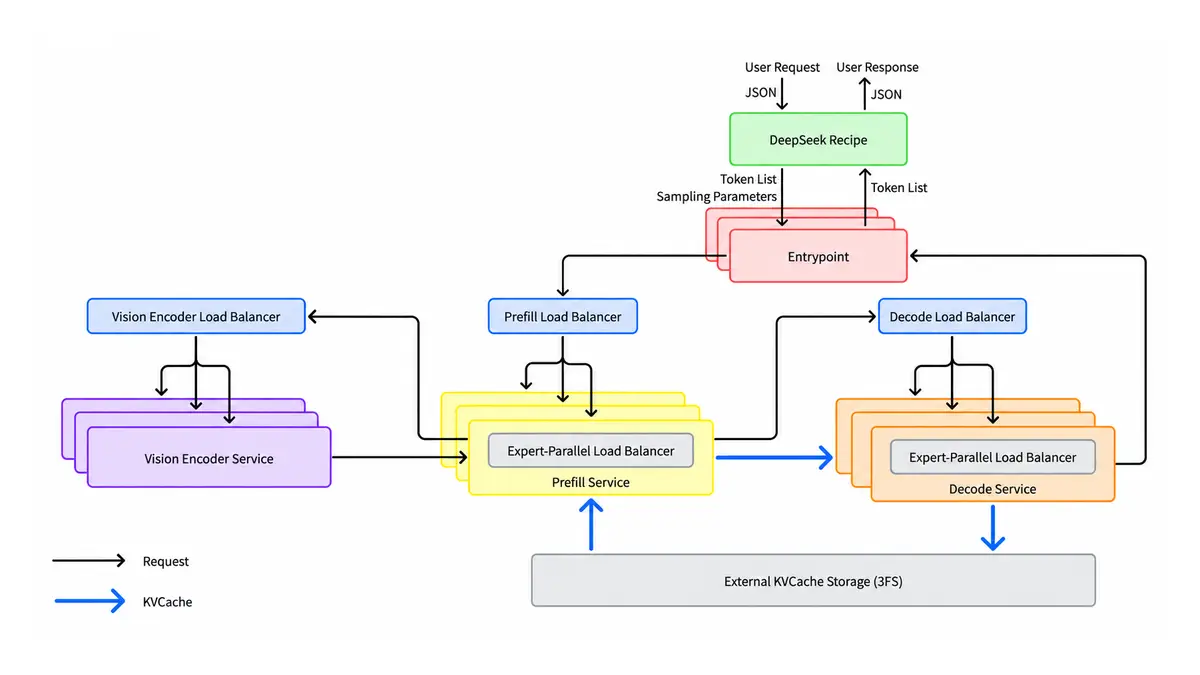
| 同時に公開 | deepseek-recipe(文章とトークンを変換する受付の部品。Chat Completions・Responses API・Messages API の形式を受ける) |
| 含まれない物 | 記憶(KVキャッシュ)の仕組み・読む処理と書く処理のつなぎ・振り分け(README) |
| 社内版との差 | 「全体の速さは近く、差は最大5%」(Q&A) |
推論フレームワークは「思考中」のことではない
AIの「推論」には2つの意味がある。1つは、答える前にじっくり考えること。チャット画面に「思考中」と出るAIは、推論モデルと呼ばれる。もう1つは、できあがったAIを動かして答えを出すこと全部で、推論フレームワークの「推論」はこちらだ。
推論フレームワークは、モデルの中身(重み)とは別のソフトで、モデルを大勢の分まとめて速く安く回す係にあたる。届いた質問をトークンに変え、どのGPUに回すかを決め、読んだ内容の記憶をしまって使い回し、答えを1トークンずつ書かせる。何を考えて何を答えるかを決めているのはモデルで、推論フレームワークはその作業を動かす土台だ。思考中の時間も、答えが1文字ずつ出てくる時間も、この土台の上で動いている。
DeepSeekはモデルの重みを前から公開してきた。最新のV4.1 FlashもMITライセンスでダウンロードできる。一方で、それを大勢に同時に届ける本番の仕組みは、会社の外に出てこないのが普通だった。誰でも使える推論フレームワークには vLLM や SGLang があるが、どこかの会社が自分の本番で動かしている物そのものではない。READMEの謝辞によると、DeepInferももとは vLLM から分かれた物だ。
1年半前は「出さない」と書いていた
DeepSeekは2025年4月、GitHubに推論エンジンの公開の方針を書いた文章を出している。
While we initially considered open-sourcing our full internal inference engine, we identified several challenges
(訳:社内の推論エンジンを丸ごと公開することも最初は考えたが、いくつか難しい点が見つかった)
文章が挙げた理由は3つある。1年以上前の vLLM から分かれて DeepSeek のモデル用に作り込みすぎていること、クラスタの管理の道具など社内の仕組みと強く結びついていること、小さな研究チームで大きなオープンソースを保守する手が足りないこと、だ。代わりに、使い回せる部品を切り出して出し、既存のオープンソースに改良を渡す、と書いていた。実際、その2か月前の2025年2月のオープンソース週間で出したのは、計算の部品(FlashMLA・DeepGEMM)、専門家どうしの通信(DeepEP)、専門家の振り分け(EPLB)、ファイルの仕組み(3FS)といった部品だった。
今回のDeepInferは、その部品をつなぐ本体にあたる。ただし2つ目の理由に当たる部分、つまり記憶の管理と振り分けは、今回もQ&Aで社内の基盤と強く結びついているとして出していない。コードは出ていないが、どういうやり方で動かしているかはQ&Aにかなり細かく書かれている。
ちなみに、Kimi を作る Moonshot AI が公開している Mooncake は、記憶の倉庫と記憶の受け渡しに当たる部品だ。役割で見ると、DeepSeekが出していない所とちょうど逆になっている。別の会社の別の仕組みなので、そのまま組み合わさるわけではない。
DeepSeekはどれくらい安いのか
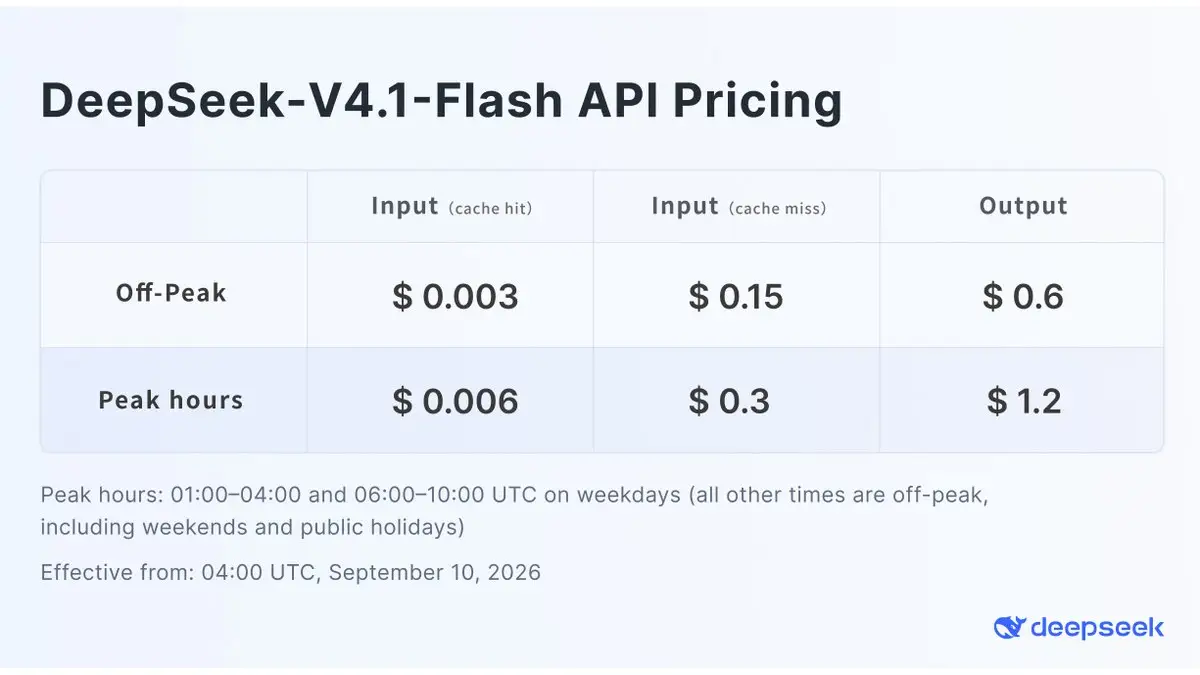
DeepSeekのAPIは今、このV4.1 Flashで動いている。料金ページ(10月21日に確認)の値段は次のとおりだ。
| 100万トークンあたり | 混む時間帯 | それ以外(半額) |
|---|---|---|
| 入力(初めて読む) | $0.3 | $0.15 |
| 出力 | $1.2 | $0.6 |
| 入力(前に送った部分) | $0.006 | $0.003 |
混む時間帯は、日本時間で平日の10時〜13時と15時〜19時。それ以外は週末を含めて半額になる。前に送った部分をもう一度送る時の値段は、初めて読む時の50分の1だ($0.3 ÷ $0.006・計算)。Claude Code のように、毎回それまでの会話を送り直す使い方ほど、ここが効いてくる。
安さの仕掛けは7つ
Q&Aと技術報告からは、この値段を支える仕掛けが読み取れる。
- 動くのは一部だけ:V4.1 Flashは本体が5,520億パラメータの大きなモデルだが、1トークンを書く時に動くのは160億(約3%)、新しく文章を読む時はその半分の80億だけ(技術報告)。
- 記憶を小さくして、何日もしまう:1トークンあたりの記憶(KVキャッシュ)の大きさは、2023年の初代の389,120バイトから、V4.1 Flashでは890バイトまで小さくなった(技術報告の図1。437分の1)。記憶はSSDの倉庫(約100ペビバイト)に、エージェントの使い方で3日、チャットで7日しまっておく(Q&A)。
- 読む計算を減らす:新しい文章はモデルの下半分の層だけで読み、上半分が使う記憶は下半分の結果から作る。これで読む計算がほぼ半分になる。長い文章でも全部は読まず、最初の層が候補を1万6,384か所に絞り、後ろの層はその中から512か所だけを読む。文章を4,000から100万トークンへ256倍にしても、1トークン書く計算は4分の1しか増えない(技術報告)。
- 専門家を64枚のGPUに散らす:読む部屋と書く部屋を別のGPUの組に分け、書く部屋ではモデルの中の384の専門家を64枚のGPUに散らして置く。同じくらいの応答の速さで比べると、GPU 1枚が出せる量は8枚に散らした場合の約8倍になる(Q&Aの公式グラフ)。
- 先読み(DSpark):小さな下書き役が次の5トークンを先に書き、本体がまとめて確かめる。DeepSeekは下書きに「当たりそう」という見込みを付け、当たりそうにない下書きは確かめる前に外す。本番の混み具合では、確かめる数が5から平均3.2〜4.4に減り、受け入れられる数は3.29から3.20とほぼ変わらず、全体で4〜7%速くなった(Q&A)。空いている時は1.5%遅くなる数字も載っている。
- GPUを休ませない:GPUが計算している間に、CPUが次の割り振りを並行して準備する(Q&A)。
- 普通の機械を、混み具合に合わせて使う:読む部屋はふつうの8枚のGPUのマシン、書く部屋はふつうの64〜128枚の組を前提にしている。台数は混み具合に合わせて増減し、使っている割合が8割を超えている間は減らさない(Q&A)。
本番では1日155兆トークン
Q&Aの冒頭には、運用の数字が書かれている。
A single cluster currently serves 155 trillion tokens per day, with overall revenue of US$38 per GPU-hour (at valley pricing).
(訳:1つのクラスタで、いまは1日に155兆トークンを提供している。売上はGPU 1枚1時間あたり38ドル[半額の時間帯の値段で])
1秒に直すと約18億トークンになる(155兆 ÷ 86,400秒・計算)。DeepSeekがGPUに実際にいくら払っているかは出ていない。参考に、米Lambdaの貸し出し値段(10月21日に確認)では同じ世代のB200が1枚1時間6.69ドル、64枚の組で借りると9.36ドルだ。38ドルはその約4〜6倍にあたる(計算)。2025年2月にDeepSeekが出した数字は全サービス合計で1日7,760億トークンだったが、今回の155兆はクラスタ1つの値で、数え方の範囲が違うので単純には比べられない。
誰が使えるのか
個人のパソコンで動かす物ではない。Q&Aによると、無駄なく動かす最小の単位は読む側のGPU 64枚と書く側のGPU 64枚、合わせて128枚だ。対応する機械はNVIDIAのSM100(Blackwell世代)とHuaweiのAscend 950、対応するモデルは今はV4.1 Flashだけ。
使い道があるのは、DeepSeekのモデルを自分たちのクラウドで出したい会社と、推論の仕組みを研究する人やほかの推論フレームワークを作る人だ。公式と同じ作りと受付のふるまいで出せるようになり、1日155兆トークンを回した設計をコードで読める。AIME 2026・GPQA Diamond・HLE で成績を測り直す手順も入っている。DeepSeekは、これからのモデルの推論コードもDeepInferで出していくと書いている。
動画を作りながら、手元で確かめたこと
筆者は解説動画を作る途中で、いくつかを手元で確かめた。例に使った質問「推論フレームワークって何?」を、Hugging Face で公開されているDeepSeek-V4.1-Flashのトークナイザに通すと、「推|論|フ|レ|ーム|ワーク|って|何|?」の9トークンに区切られた。動画の中で受付(deepseek-recipe)が質問をトークンに変える場面は、この実際の区切りで見せている。
GitHubのスター数は、公開の翌日の10月21日0時台に約9,000、同じ日の11時39分には約13,500だった。
なぜ今出したのか(ここからは考察)
DeepSeekは公式Xで、公開の理由をこう書いている。
We're sharing our production stack to help the community lower compute costs, reduce energy use, and make AI more affordable.
(訳:本番の仕組みを共有して、みんなの計算のコストとエネルギーを下げ、AIをもっと手の届くものにしたい)
1年半前の理由と照らすと、1つ目の「作り込みすぎ」は、今回はV4.1 Flash専用のまま出すことで、2つ目の「社内の仕組みとの結びつき」は、その部分だけ出さないことで越えている。3つ目の保守の手については分からないが、Q&Aには今後も更新を続けると書かれている。報道では The Decoder が、安いモデルをさらに安く動かせるようになることで、OpenAI や Anthropic など欧米の会社への値下げの圧力にもなる、と書いた。
この記事が確かめきれなかった所
- DeepSeekがQ&Aで紹介している知乎(Zhihu)の解説記事は、取得を試みたが開けなかった(10月21日時点)。本記事はREADME・Q&A・技術報告の範囲で書いている。
- 「GPU 1枚が出せる量は約8倍」は、Q&Aの公式グラフから読み取った値で、表の数字ではない。
- 1日155兆トークンと1時間38ドルはDeepSeek自身の発表で、第三者による確認はない。成績の値もDeepSeek自身が測った物だ。
本記事は、DeepInferの更新や続報があり次第追記する。動画を見た感想や、ここが分からなかったという点があれば、YouTubeのコメントで教えてほしい。次の解説で、そこから先に説明する。
この記事でよく聞かれること
- 推論フレームワークとは何ですか?
- できあがったAIモデルを、たくさんの人の質問に同時に、速く安く答えさせるために動かすソフトです。質問をトークンに変える、どのGPUに回すかを決める、読んだ内容の記憶をしまって使い回す、答えを1トークンずつ書かせる、といった仕事を受け持ちます。モデルの中身(重み)とは別の物です。
- 推論フレームワークはAIの「思考中」のことですか?
- 違います。「思考中」に何を考えるかを決めているのはモデル(重み)です。推論フレームワークは、その考える作業や答えを書く作業をGPUの上で実際に動かす土台で、考える中身には関わりません。思考中の時間も答えが出てくる時間も、この土台の上で動いています。
- DeepInferで公開されていない部分はありますか?
- READMEによると、記憶(KVキャッシュ)の仕組み、読む処理と書く処理を分けてつなぐ部分、並べた複数の組への振り分けの3つは今回の公開に含まれていません。Q&Aは、記憶の管理と振り分けは社内の基盤と強く結びついているため、と説明しています。やり方の説明はQ&Aに書かれています。
- 自分のパソコンでDeepInferを動かせますか?
- 現実的ではありません。Q&Aによると、無駄なく動かす最小の単位は読む側のGPU 64枚と書く側のGPU 64枚です。対応する機械はNVIDIAのSM100(Blackwell世代)とHuaweiのAscend 950で、対応するモデルは今はDeepSeek-V4.1-Flashだけです。
- DeepSeekはなぜ安いのですか?
- 公開された資料からは、動く部分を小さくしたモデル、1トークン890バイトまで小さくした記憶を何日もしまう倉庫、読む計算をほぼ半分にする作り、専門家を64枚のGPUに散らす置き方、先読み、GPUを待たせない作り、普通の機械を混み具合に合わせて増減する運用、が読み取れます。実際にGPUに払っている額は公開されていません。
出典・参照資料
- 一次資料DeepInfer — GitHub(deepseek-ai) ↗
- 一次資料DeepInfer 推論デプロイ Q&A(inference_deployment_qa.md)— GitHub ↗
- 一次資料DeepSeek 公式X(2026年10月20日) ↗
- 一次資料The Path to Open-Sourcing the DeepSeek Inference Engine(2025年4月)— GitHub ↗
- 一次資料DeepSeek-V4.1-Flash 技術報告 — Hugging Face ↗
- 一次資料DeepSeek-V4.1-Flash-1017 モデルカード — Hugging Face ↗
- 一次資料DeepSeek-V3/R1 Inference System Overview(2025年2月)— GitHub ↗
- 一次資料Models & Pricing — DeepSeek API Docs ↗
- 一次資料Mooncake — GitHub(kvcache-ai) ↗
- 二次資料DeepSeek open-sources the inference engine that powers its fastest and cheapest AI model — The Decoder ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
DeepSeek-V4.1-Flash公開 出力100万トークン0.6ドル、KVキャッシュは1トークン890バイト
DeepSeek-V4.1-Flash公開出力100万トークン0.6ドル、KVキャッシュは1トークン890バイト
 動画
DeepSeek(ディープシーク)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開 Terminal-Bench 4.0は31.2から42.3、表の11項目すべてで旧版を上回る(同社掲載の数字)
DeepSeek(ディープシーク)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開Terminal-Bench 4.0は31.2から42.3、表の11項目すべてで旧版を上回る(同社掲載の数字)
DeepSeekが「値上げを予告」してからピーク課金制に 公式価格表で確認できる現行料金と、確認できなかった値上げ幅
DeepSeekが「値上げを予告」してからピーク課金制に公式価格表で確認できる現行料金と、確認できなかった値上げ幅
DeepSeekの使い方【2026年9月版】 無料アプリ・Web版のログイン方法と機能、API(deepseek-flash/deepseek-v4-pro)の始め方とピーク・オフピーク料金、Claude Code・Codexから使う方法、データが中国のサーバーに置かれる点まで
DeepSeekの使い方【2026年9月版】無料アプリ・Web版のログイン方法と機能、API(deepseek-flash/deepseek-v4-pro)の始め方とピーク・オフピーク料金、Claude Code・Codexから使う方法、データが中国のサーバーに置かれる点まで
DeepSeekはローカルで動かせるのか パラメータ数とVRAM要件で判定する
DeepSeekはローカルで動かせるのかパラメータ数とVRAM要件で判定する
Google、MetaのTorchTitan(トーチタイタン)をCloud TPU向けに公開 Llama 3 405Bは1,024チップまで約57% MFU、Qwen3 235Bは32.42%と発表
Google、MetaのTorchTitan(トーチタイタン)をCloud TPU向けに公開Llama 3 405Bは1,024チップまで約57% MFU、Qwen3 235Bは32.42%と発表
Google、TPUでPyTorchが直接動くTorchTPU上に「vLLM-TorchTPU」と「SGLang-TorchTPU」を公開 Ironwoodで100万トークン2.01セント、SGLang版はMetaで本番稼働と発表
Google、TPUでPyTorchが直接動くTorchTPU上に「vLLM-TorchTPU」と「SGLang-TorchTPU」を公開Ironwoodで100万トークン2.01セント、SGLang版はMetaで本番稼働と発表