
AI半導体・ハードウェアの記事
「AI半導体・ハードウェア」に関連するAIニュースと解説、55本。新しい順に並べています。
AI半導体・ハードウェア の記事:55件
Raspberry Pi 5でGemma 4 E2Bをオフライン実行 LiteRT-LMでプリフィル99トークン/秒・デコード9トークン/秒・ピークメモリ1,432MB、生成は約300語/分(人の会話の2倍)。GPUにYOLOの物体検出を逃がし、CPUでMoonshineの音声認識・Gemma・TTSを回すReachy Miniロボットの構成。pip install litert-cliで開始
Raspberry Pi 5でGemma 4 E2Bをオフライン実行LiteRT-LMでプリフィル99トークン/秒・デコード9トークン/秒・ピークメモリ1,432MB、生成は約300語/分(人の会話の2倍)。GPUにYOLOの物体検出を逃がし、CPUでMoonshineの音声認識・Gemma・TTSを回すReachy Miniロボットの構成。pip install litert-cliで開始
検証
NVIDIA「メガワットからトークンへ」 同じ電力予算で19ノードを85%出力で回すと、16ノード全開よりトークン処理量24%増(Lambdaの実測、HGX B200)。電力会社の信号でAI工場の消費を4MWから3MWへ1分未満で自動調整(Emerald AI・Silicon Valley Power、200回超すべて成功)。DSX Flex初の商用配備は96MWのVera Rubin工場
NVIDIA「メガワットからトークンへ」同じ電力予算で19ノードを85%出力で回すと、16ノード全開よりトークン処理量24%増(Lambdaの実測、HGX B200)。電力会社の信号でAI工場の消費を4MWから3MWへ1分未満で自動調整(Emerald AI・Silicon Valley Power、200回超すべて成功)。DSX Flex初の商用配備は96MWのVera Rubin工場
検証
OpenAI CFOサラ・フライアー氏「いま実現できる仕事」 週次10億人超・250万社、個人プラン利用者は登録6か月後にメッセージ約50%増・タスクの種類約2倍、研究組織は人間1日につきエージェント3.1稼働日分、GPT-5.6 Solで提供コスト20%減・トークン効率15%超向上、自社チップJalapeñoはワット当たり1.5〜1.9倍で年末までに導入
OpenAI CFOサラ・フライアー氏「いま実現できる仕事」週次10億人超・250万社、個人プラン利用者は登録6か月後にメッセージ約50%増・タスクの種類約2倍、研究組織は人間1日につきエージェント3.1稼働日分、GPT-5.6 Solで提供コスト20%減・トークン効率15%超向上、自社チップJalapeñoはワット当たり1.5〜1.9倍で年末までに導入
検証
Emerald AI・Google・NVIDIAが「AI Energy Management Alliance(AEMA)」を設立 AIデータセンターを「電力を柔軟に減らせる資源」として電力網につなぐ。負荷の移動・蓄電・併設発電で系統の逼迫に応じ、接続前にライドスルー・抑制・緊急応答の義務を定め、検証可能な柔軟性を約束した事業者には速い接続経路を
Emerald AI・Google・NVIDIAが「AI Energy Management Alliance(AEMA)」を設立AIデータセンターを「電力を柔軟に減らせる資源」として電力網につなぐ。負荷の移動・蓄電・併設発電で系統の逼迫に応じ、接続前にライドスルー・抑制・緊急応答の義務を定め、検証可能な柔軟性を約束した事業者には速い接続経路を
業界
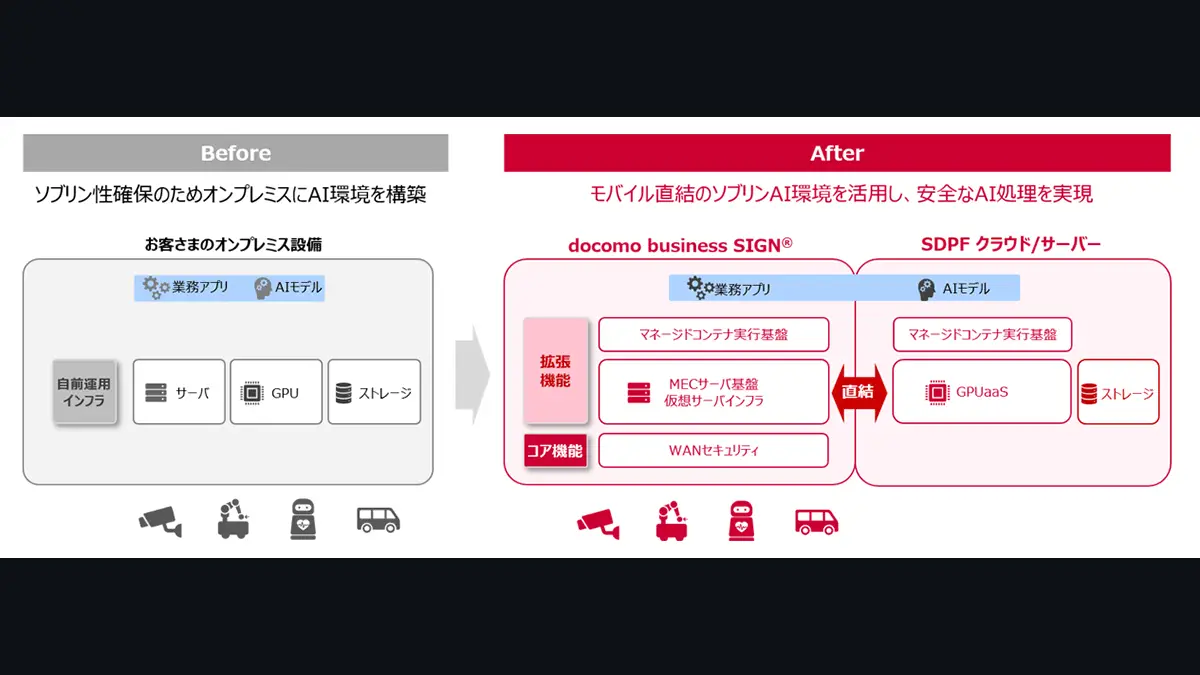
NTTドコモビジネス、IoT通信基盤「docomo business SIGN」でセキュアな「フィジカルAI」活用環境を実現 MECとGPUaaSを直結し1GPU単位のソブリンAI環境を2026年12月提供開始
NTTドコモビジネス、IoT通信基盤「docomo business SIGN」でセキュアな「フィジカルAI」活用環境を実現MECとGPUaaSを直結し1GPU単位のソブリンAI環境を2026年12月提供開始
業界
NVIDIAの次世代ラック「Vera Rubin NVL72」がMLPerf Inference v6.1に初登場 Qwen3-VLでGB300 NVL72の最大3.7倍、DeepSeek-R1で最大2.5倍(プレビュー提出)。GB300は4ラック288GPUで99%のスケーリング効率、ソフトウェア改善だけでv6.0比最大1.6倍。エージェント向け指標では30倍という自社測定も
NVIDIAの次世代ラック「Vera Rubin NVL72」がMLPerf Inference v6.1に初登場Qwen3-VLでGB300 NVL72の最大3.7倍、DeepSeek-R1で最大2.5倍(プレビュー提出)。GB300は4ラック288GPUで99%のスケーリング効率、ソフトウェア改善だけでv6.0比最大1.6倍。エージェント向け指標では30倍という自社測定も
業界
Google、宇宙データセンター研究「Project Suncatcher」の試作衛星を来週打ち上げへ 太陽光は地上の最大8倍、論文は打ち上げ費用200ドル/kgで電力コストが地上並みと試算
Google、宇宙データセンター研究「Project Suncatcher」の試作衛星を来週打ち上げへ太陽光は地上の最大8倍、論文は打ち上げ費用200ドル/kgで電力コストが地上並みと試算
業界
NTTドコモビジネスが「1GPUから」のGPUクラウド「GPUaaS」を9月30日に開始 閉域網と国内クラウドで「AI処理からデータ保管まで国内完結」のソブリンAI。同じ日、NTTデータ系のフォーティエンスは消費財向け「AI駆動型需要予測FDEサービス」(19種の予測モデルをSKUごとに自動選択、現場がバイブコーディングで改善)
NTTドコモビジネスが「1GPUから」のGPUクラウド「GPUaaS」を9月30日に開始閉域網と国内クラウドで「AI処理からデータ保管まで国内完結」のソブリンAI。同じ日、NTTデータ系のフォーティエンスは消費財向け「AI駆動型需要予測FDEサービス」(19種の予測モデルをSKUごとに自動選択、現場がバイブコーディングで改善)
業界
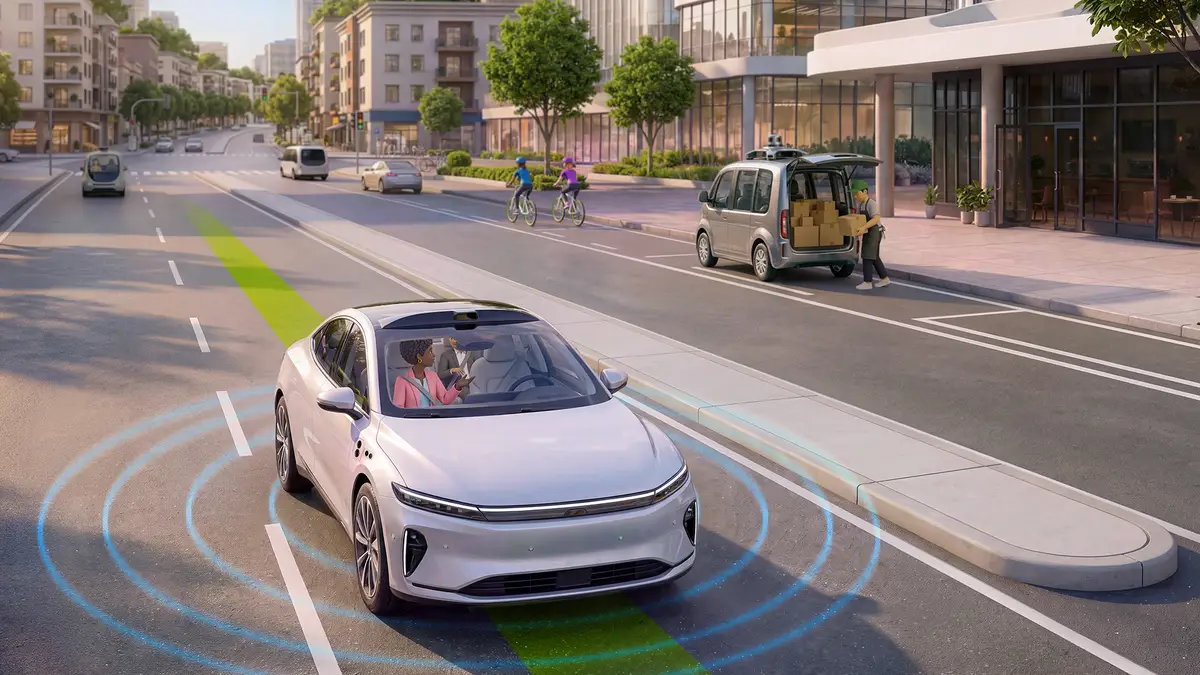
NVIDIAが「商用規模で走る主要ロボタクシーはすべて自社スタックの上」と書いた 訓練(DGX+Alpamayo)・シミュレーション(Omniverse/Cosmos)・車載(Hyperion=Thor×2、カメラ14・レーダー9・ライダー3)の3台構成。日本はTIER IV・いすゞのレベル4バス、日産×Wayve×Uber。Uberは2028年に28都市
NVIDIAが「商用規模で走る主要ロボタクシーはすべて自社スタックの上」と書いた訓練(DGX+Alpamayo)・シミュレーション(Omniverse/Cosmos)・車載(Hyperion=Thor×2、カメラ14・レーダー9・ライダー3)の3台構成。日本はTIER IV・いすゞのレベル4バス、日産×Wayve×Uber。Uberは2028年に28都市
業界
 動画
Meta Connect 2026基調講演まとめ 100gの「Meta VR glasses」、カメラ無しのRay-Ban Meta Audio、Ray-Ban Meta Gen 3、Muse Charm
Meta Connect 2026基調講演まとめ100gの「Meta VR glasses」、カメラ無しのRay-Ban Meta Audio、Ray-Ban Meta Gen 3、Muse Charm
プロダクト
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
モデル
NVIDIAがオハイオ州の巨大データセンターを「自社AI計算資源の独占ホスト」に組み替え OpenAIは8IT-GWの「顧客」という立場に
NVIDIAがオハイオ州の巨大データセンターを「自社AI計算資源の独占ホスト」に組み替えOpenAIは8IT-GWの「顧客」という立場に
業界
『コンテナランタイムは汎用ワークロード向けに作られた、AI推論は汎用ワークロードではない』 Basetenの専門チームを求人票から読む
『コンテナランタイムは汎用ワークロード向けに作られた、AI推論は汎用ワークロードではない』Basetenの専門チームを求人票から読む
研究
MarvellがGoogleに最大121.8億ドル相当のワラント発行 「TPU本体」ではなく周辺シリコンだった契約をSEC 8-Kで確認する
MarvellがGoogleに最大121.8億ドル相当のワラント発行「TPU本体」ではなく周辺シリコンだった契約をSEC 8-Kで確認する
業界
NVIDIAがApollo・BlackRock・KKRらと5,000億ドル超を動員する「コンピュート金融プラットフォーム」 GPUは投資適格資産になるのか
NVIDIAがApollo・BlackRock・KKRらと5,000億ドル超を動員する「コンピュート金融プラットフォーム」GPUは投資適格資産になるのか
業界
NCCLに頼らないallreduce SGLangがBlackwell世代のFlashInfer MNNVLワークスペースを使い回す最適化
NCCLに頼らないallreduceSGLangがBlackwell世代のFlashInfer MNNVLワークスペースを使い回す最適化
研究
SGLangが「allgather+scatter」を1回のall-to-allに統合 DeepSeek-V4-Proのデコード時間が320μsから169μsに
SGLangが「allgather+scatter」を1回のall-to-allに統合DeepSeek-V4-Proのデコード時間が320μsから169μsに
研究
手元のメモリを99.998%まで使い切る量子化ツール「shoehorn」 プリセットGGUFをやめる発想
手元のメモリを99.998%まで使い切る量子化ツール「shoehorn」プリセットGGUFをやめる発想
検証
『このAI処理はクラウドかブラウザか』をestimateQoS()で自動判定する W3CのDAOP提案を読む
『このAI処理はクラウドかブラウザか』をestimateQoS()で自動判定するW3CのDAOP提案を読む
研究
Intelが約230億ドルの公募増資 SEC 8-K原文で確定させる実額と、報道で揺れた数字
Intelが約230億ドルの公募増資SEC 8-K原文で確定させる実額と、報道で揺れた数字
業界
NVIDIAがOpenAIの家賃を最大1,050億ドル肩代わり SEC 8-K原文で読む保証契約の中身
NVIDIAがOpenAIの家賃を最大1,050億ドル肩代わりSEC 8-K原文で読む保証契約の中身
業界
モデルの起動待ち時間を2.38倍短縮 SGLangが「CUDAグラフのキャプチャ中にチェックポイントを読み込む」設計に変えた
モデルの起動待ち時間を2.38倍短縮SGLangが「CUDAグラフのキャプチャ中にチェックポイントを読み込む」設計に変えた
研究
vLLMのDecode Context Parallelで、Kimi-K3のKVキャッシュ容量がGPU1台あたり10倍に
vLLMのDecode Context Parallelで、Kimi-K3のKVキャッシュ容量がGPU1台あたり10倍に
研究
vLLMに投機的デコードの新手法「DFlash2」 1H200・GSM8Kで自己回帰の3.51倍のスループット
vLLMに投機的デコードの新手法「DFlash2」1H200・GSM8Kで自己回帰の3.51倍のスループット
研究