NVIDIA Mission Control(ミッションコントロール)2.5が提供開始障害の自動復旧エンジンがKubernetes(Run:ai)のジョブにも対応、Vera Rubin NVL72では未対応
日刊AIニュース10月25日(日)号:前日のAIのニュース2本を短くまとめました(約4分)›
NVIDIAは2026年10月26日、AI基盤の運用ソフトMission Control 2.5が提供中と技術ブログで発表した。Slurm限定だった自動復旧エンジンが、Run:aiで管理するKubernetesのワークロードにも広がった。一方、リリースノートではVera Rubin NVL72の早期アクセスにRun:aiと自動復旧は含まれないと書かれている。
目次
NVIDIAは2026年10月26日(米国時間)、AI基盤の運用ソフト「NVIDIA Mission Control(ミッションコントロール)2.5」が提供中だと技術ブログで発表しました。これまでHPC向けジョブ管理のSlurmに限られていた「自動復旧エンジン」が、NVIDIA Run:ai(ランエーアイ)で管理するKubernetes(クバネティス)上のワークロードにも使えるようになった、というのが中心の変更です。ブログの公開時刻はページのメタデータで2026年10月26日15:00(UTC)、日本時間では10月27日0時にあたります。
3行まとめ
- NVIDIAは10月26日、Mission Control 2.5が提供中と発表。Slurm限定だった自動復旧エンジンがRun:ai管理のKubernetesにも広がった
- 障害時は、ジョブの再起動とノードの隔離・診断を並行して進める。一時的なソフトウェア障害ではハードウェア修復を起こさず再試行する、と説明している
- リリースノートでは、Vera Rubin NVL72の早期アクセスはRun:aiと自動復旧エンジンに非対応。ブログの「早期アクセス」だけを読むと見落としやすい
本記事の内容は、日本時間10月27日0時台に公式ページで確認したものです。
何ができるようになったのか
NVIDIAの技術ブログ(著者はRyan Prout氏とCasey Dugas氏)は、数千GPUで大規模モデルを学習する運用では、手作業での対応や静的なチェックポイント、後追いの監視では追いつかないと述べています。そのうえで、Mission Controlに含まれる自動復旧エンジンを、Kubernetes上のワークロードにも広げたと説明しています。
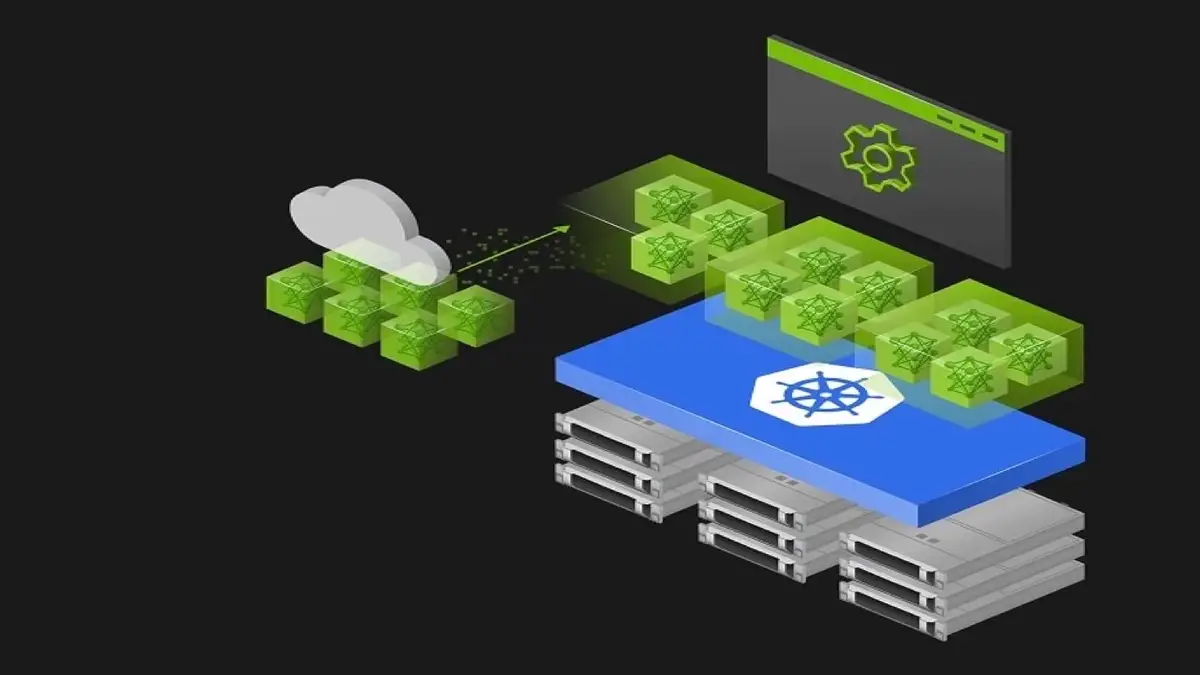
ブログによると、エンジン自体はジョブ復旧とハードウェア復旧の2つのサービスで構成され、ワークロードのスケジューラーと組み合わさって3層の仕組みとして動きます。
| 役割 | 担当 | ブログでの説明 |
|---|---|---|
| ジョブの配置 | Kubernetesスケジューラー(Run:ai) | Mission ControlではRun:aiがKubernetesの既定スケジューラーとして含まれ、キューやポリシーに従ってジョブを空き容量に配置する |
| ジョブ復旧 | autonomous job recovery(実行中のジョブを監視) | 失敗の履歴とジョブの構成から、どの復旧の道筋が妥当かを分類する。それを再起動・再試行・再キュー・配置に落とすのはスケジューラー連携側 |
| ハードウェア復旧 | autonomous hardware recovery(ノードとGPUを監視) | 異常なものをスケジューリングから外し、診断や修復を走らせる |
ブログは、この3者の役割を分けているため、ジョブ復旧はハードウェアの修理を担わず、ハードウェア復旧は学習フレームワークの細部を理解しなくてよい、と説明しています。
障害の種類で、動きはどう変わるのか
ブログは3つの場面を挙げています。
- ハードウェア障害: GPUの異常が、ECCエラー、ワーカーの停止、通信タイムアウトなどの形で現れる場面です。ジョブ復旧サービスが疑わしいノードやGPUを特定し、スケジューラー連携がジョブを再起動または再配置します。同時にハードウェア復旧サービスがそのノードを隔離し、理由を記録して診断を始めます。ブログは「根本原因の分析を待たずに復旧が始まり、壊れたノードが次のジョブに渡されることもない」と説明しています。
- 一時的なソフトウェア障害: ノード自体は健全なまま、ワーカーが終了したり、一時的に協調が途切れたりする場面です。失敗の履歴が一時的に見えるなら、スケジューラーのポリシーに沿って再試行し、ハードウェアを隔離しません。繰り返し失敗する場合は、その事実が表に出されるとFigure 5の説明にあります。
- ハードウェアの劣化を早期に検知: GPUの健全性警告や接続の問題が繰り返されるノードを、ジョブが載る前にスケジューラーの対象から外し、診断を始めます。この場合、ジョブ復旧サービスの出番がないこともあるとしています。
対応する環境と条件は?
リリースノート(2.5.0)には、ブログより細かい条件が書かれています。
- 自動復旧エンジンはRun:aiのKAIスケジューラーに統合され、kubeflowのPyTorch学習オペレーターを使う場合が対象と書かれています。ジョブを投入すると、Mission Controlがジョブの出力を監視し、システムログやテレメトリーと突き合わせて、原因がハードウェアかソフトウェアかを判定します。ジョブは再キューされ、直近の異常に関与したノードを除外するようジョブ仕様が更新される、という説明です。
- 自動復旧エンジンは、ジョブ復旧、ハードウェア復旧、NVIDIA Resiliency Extensions(NVRx)の3つで構成されます。NVRxはMission Controlと一緒にはインストールされず、別途入れる必要があると注記されています。
- 学習アプリ側には、PyPIのクライアントライブラリ(aidot_training_telemetry)を組み込むと、スループット、チェックポイント、ハングの検知に使うログが自動で出る、とあります。
- 対応表では、DGX B200・B300、DGX GB200・GB300、OEMのGB200・GB300 NVL72で、Run:ai・ジョブ復旧・ハードウェア復旧がいずれも「Yes」です。
Vera Rubin NVL72の「早期アクセス」には何が含まれるか
ブログはリリースの目玉の一つに「Vera Rubin NVL72の早期アクセス」を挙げています。一方、リリースノートの冒頭には次のようにあります。
Early access support for Vera Rubin NVL72 is limited to essential bring-up support with NVIDIA Base Command Manager. NVIDIA Run:ai and Autonomous Resiliency Engine are not supported on Vera Rubin NVL72 in this release. (Vera Rubin NVL72の早期アクセスは、NVIDIA Base Command Managerによる基本的な立ち上げ支援に限られる。今回の版では、Vera Rubin NVL72でNVIDIA Run:aiと自動復旧エンジンは非対応)
対応表も同じで、DGX VR NVL72とOEM VR NVL72の列は、Run:ai・ジョブ復旧・ハードウェア復旧がすべて「No」、NetQもNoです。リリースノートの記載どおりなら、今回の目玉であるKubernetes向けの自動復旧は、2.5の時点ではVera Rubin NVL72と組み合わせて使えないことになります。
前の版と何が違い、ほかに何が入ったか
ブログが挙げる、自動復旧のKubernetes対応以外の変更は次の4点です。
| 項目 | ブログの記載 | リリースノートで確認できたこと |
|---|---|---|
| AI対応のネットワーク異常検知 | 新サービス(ベータのみ) | 別項目で、Minerva 1.0.0とDynamic Power Softwareがベータ部品として載る。リリースには含まれず、担当営業を通じた限定参加のみ |
| 認証 | 中央のKeycloakで統一 | ハードウェア復旧にKeycloakがOIDCとSAML 2のIDプロバイダーとして追加 |
| セキュリティ | Kubernetes堅牢化などの更新 | Base Command Manager 11.34.0でSSHの多要素認証、Slurmの脆弱性修正、BCMのSSH制限機能のコマンドインジェクション修正など |
| Vera Rubin NVL72 | 早期アクセス | 上記のとおり、基本的な立ち上げ支援のみ |
リリースノートには、Run:ai 2.26への更新、読み取り専用のRun:ai MCPサーバー、NetQ 5.2.1なども載っています。Run:aiの旧GPU分割エンジンをCUDAベースへ移す予告もありますが、v2.26では変更なしと書かれています。
筆者が公式ページで確認した範囲での気づき
日本時間10月27日0時台に3つのページを取得して読み比べた時点で、気づいたことが2つあります。1つは、ブログの「AI対応のネットワーク異常検知サービス(ベータのみ)」という表現が、リリースノートでは同じ名前で出てこないことです。リリースノートでネットワークの異常をたどる機能として説明されているのはMinervaで、これは「リリースに含まれず、限定参加のみ」とされています。ただし、ブログの項目がMinervaを指すのかは、取得した3ページからは断定できません。そのため本記事では、両者を同一とは書いていません。もう1つは、前節のVera Rubin NVL72の範囲です。ブログの一覧は「Early access for NVIDIA Vera Rubin NVL72」の1行だけで、Run:aiと自動復旧エンジンが対象外であることには触れていません。なお、取得した3ページはいずれも英語版で、日本語のページは確認していません。
NVIDIAの関連記事は、サイト内のNVIDIA Minerva(AIファクトリーの障害を予兆から原因特定まで見るAIOps基盤)と、Run:aiのオープンソース化でも扱っています。
この発表だけでは分からないこと
- 今回取得した技術ブログ、リリースノート、製品ページには、料金、ライセンス条件、日本での提供条件の記載は見つかりませんでした。製品ページには「Talk to Us」の問い合わせ窓口と、NVIDIA Enterprise Supportの案内があります。
- 復旧にかかる時間や成功率などの実測値は、ブログに載っていません。製品ページには自動復旧エンジンについて「10x faster」(10倍速く)という記載がありますが、これは製品全体の説明で、Kubernetes対応の2.5について測定したものとは書かれていません。比較の基準も示されていません。
- ブログの動画(Video 1)と図は、本文のテキスト取得では中身を確認できていません。
- 筆者は製品を試していません。以上はすべてNVIDIAの公式説明です。
読み比べた3ページと取得時刻
- How NVIDIA Mission Control 2.5 Brings Autonomous Recovery to Kubernetes — NVIDIA Technical Blog(2026年10月27日0時5分、日本時間に確認)
- NVIDIA Mission Control 2.5.0 Release Notes(同0時6分に確認)
- NVIDIA Mission Control(製品ページ)(同0時6分に確認)
本記事は続報があり次第更新します。
この記事でよく聞かれること
- NVIDIA Mission Control 2.5では何が変わりましたか?
- NVIDIAの技術ブログによると、これまでSlurm(HPC向けのジョブ管理)のワークロードに限られていた自動復旧エンジンが、NVIDIA Run:aiで管理するKubernetesのワークロードにも広がりました。ほかに、AI対応のネットワーク異常検知サービス(ベータのみ)、Keycloakによる認証の統一、セキュリティとKubernetesの堅牢化、Vera Rubin NVL72の早期アクセスが挙げられています。
- 自動復旧エンジンは具体的に何をしますか?
- ブログの説明では、Kubernetesのスケジューラーがジョブを配置し、ジョブ復旧サービスが失敗の種類を判定し、ハードウェア復旧サービスが異常なノードを隔離して診断する、3層の制御ループです。ハードウェア障害ではジョブの再起動と、ノードの隔離・診断が並行して進みます。一時的なソフトウェア障害では、ハードウェアの修復を起こさずジョブを再試行します。
- Vera Rubin NVL72でもKubernetes向けの自動復旧は使えますか?
- リリースノートによると、今回の版ではVera Rubin NVL72の早期アクセスは基本的な立ち上げ支援に限られ、Run:aiと自動復旧エンジン(Autonomous Resiliency Engine)は非対応です。対応表でも、DGXとOEMのVR NVL72では、Run:ai・ジョブ復旧・ハードウェア復旧がいずれも「No」になっています。
- 料金や日本での提供は書かれていますか?
- 今回確認した3つの公式ページ(技術ブログ、リリースノート、製品ページ)には、料金や日本での提供条件の記載は見つかりませんでした。製品ページには「Talk to Us」の問い合わせ窓口があります。
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
NVIDIA、AIファクトリーの障害を予兆から原因特定まで見るAIOps基盤「Minerva(ミネルバ)」を発表 IREN・IBM・Teslaなどが利用・導入予定
NVIDIA、AIファクトリーの障害を予兆から原因特定まで見るAIOps基盤「Minerva(ミネルバ)」を発表IREN・IBM・Teslaなどが利用・導入予定
NVIDIA、Confidential Computing(コンフィデンシャル・コンピューティング)に「Confidential Bare Metal」を追加 Grace Blackwell NVL72とHGX/DGX Rubin NVL8に対応、Cohere・Google Cloudが採用を表明
NVIDIA、Confidential Computing(コンフィデンシャル・コンピューティング)に「Confidential Bare Metal」を追加Grace Blackwell NVL72とHGX/DGX Rubin NVL8に対応、Cohere・Google Cloudが採用を表明
NVIDIA、Vera Rubin(ベラ・ルービン)のAIファクトリーを工場組み立てのコンテナで届ける「DSX POD」を発表 現地の導入は6か月から最短14日、提供は2027年初めの予定
NVIDIA、Vera Rubin(ベラ・ルービン)のAIファクトリーを工場組み立てのコンテナで届ける「DSX POD」を発表現地の導入は6か月から最短14日、提供は2027年初めの予定
Google Cloud、Vera Rubin(ベラ・ルービン)NVL72搭載の「A5X」を来月一般提供へ 欧州への拡大と最大96万基のRubin GPUを計画とNVIDIA発表
Google Cloud、Vera Rubin(ベラ・ルービン)NVL72搭載の「A5X」を来月一般提供へ欧州への拡大と最大96万基のRubin GPUを計画とNVIDIA発表
NVIDIA、DSXで欧州のAIファクトリーの冷却水をほぼゼロにできる設計 同じトークン数を最大30%少ない電力で出すMaxLPS(マックスエルピーエス)などをGTC Berlinで発表
NVIDIA、DSXで欧州のAIファクトリーの冷却水をほぼゼロにできる設計同じトークン数を最大30%少ない電力で出すMaxLPS(マックスエルピーエス)などをGTC Berlinで発表
NVIDIA、T-Mobileの商用網で「世界初のAI-RAN通話」と発表 BT・Deutsche Telekom・Elisaも試験へ、基地局にGPUサーバーを置く構想
NVIDIA、T-Mobileの商用網で「世界初のAI-RAN通話」と発表BT・Deutsche Telekom・Elisaも試験へ、基地局にGPUサーバーを置く構想
NVIDIA、GPU管理基盤「Run:ai(ランエーアイ)」の全体をオープンソース化 KAI Scheduler・GPU Fractioning Operatorなど4部品と、Crusoe・Nebiusなど8社の提供
NVIDIA、GPU管理基盤「Run:ai(ランエーアイ)」の全体をオープンソース化KAI Scheduler・GPU Fractioning Operatorなど4部品と、Crusoe・Nebiusなど8社の提供