新着ニュース
AIのニュースと解説を新しい順に並べています。全1085本。
Google、TPUでPyTorchが直接動くTorchTPU上に「vLLM-TorchTPU」と「SGLang-TorchTPU」を公開 Ironwoodで100万トークン2.01セント、SGLang版はMetaで本番稼働と発表
Google、TPUでPyTorchが直接動くTorchTPU上に「vLLM-TorchTPU」と「SGLang-TorchTPU」を公開Ironwoodで100万トークン2.01セント、SGLang版はMetaで本番稼働と発表
検証
Hugging Face、Swift向けAnyLanguageModel(エニーランゲージモデル)1.0を公開 importを差し替えるだけで端末内モデルとOpenAI・Anthropic・Geminiを切り替え、swift-huggingface・swift-xetも1.0に
Hugging Face、Swift向けAnyLanguageModel(エニーランゲージモデル)1.0を公開importを差し替えるだけで端末内モデルとOpenAI・Anthropic・Geminiを切り替え、swift-huggingface・swift-xetも1.0に
検証
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開 MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
Hugging Face、PyTorch 2.15(パイトーチ)のMac向けGPU「MPS」の改善を公開MoEモデルの生成が2.14比5〜6.5倍、動画デコードのメモリは270GiBから8GiBに
検証
Hugging Face、PyTorch(パイトーチ)のネイティブTPUバックエンド「TorchTPU(トーチTPU)」に対応 Transformers・Diffusers・KernelsがTPUで直接動く
Hugging Face、PyTorch(パイトーチ)のネイティブTPUバックエンド「TorchTPU(トーチTPU)」に対応Transformers・Diffusers・KernelsがTPUで直接動く
検証
IBM Research、学習した指針をプロンプトに足すだけでGPT-4.1の接客AIがτ²-bench(タウツーベンチ)retailのPass^4 67.5%に 同社比較で1位、ただしリーダーボード提出は未マージ
IBM Research、学習した指針をプロンプトに足すだけでGPT-4.1の接客AIがτ²-bench(タウツーベンチ)retailのPass^4 67.5%に同社比較で1位、ただしリーダーボード提出は未マージ
研究
経産省「技術革新と人類社会の未来」中間報告書とは AI・ブレインテック等をめぐる4つのメガトレンドと「価値主導型イノベーション・ガバナンス」の中身
経産省「技術革新と人類社会の未来」中間報告書とはAI・ブレインテック等をめぐる4つのメガトレンドと「価値主導型イノベーション・ガバナンス」の中身
業界
Microsoft、Sovereign Cloud(ソブリンクラウド)の新機能を一括発表 Sovereign Control Panelは公開プレビュー、外部鍵管理は一般提供、Azure Localにも追加
Microsoft、Sovereign Cloud(ソブリンクラウド)の新機能を一括発表Sovereign Control Panelは公開プレビュー、外部鍵管理は一般提供、Azure Localにも追加
プロダクト
Mistral、音声モデル群「Voxtral 3(ボクストラル)」と音声エージェントSDKを提供開始 文字起こし50言語超・音声合成35言語超、日本語も対象、$0.0035/分から
Mistral、音声モデル群「Voxtral 3(ボクストラル)」と音声エージェントSDKを提供開始文字起こし50言語超・音声合成35言語超、日本語も対象、$0.0035/分から
モデル
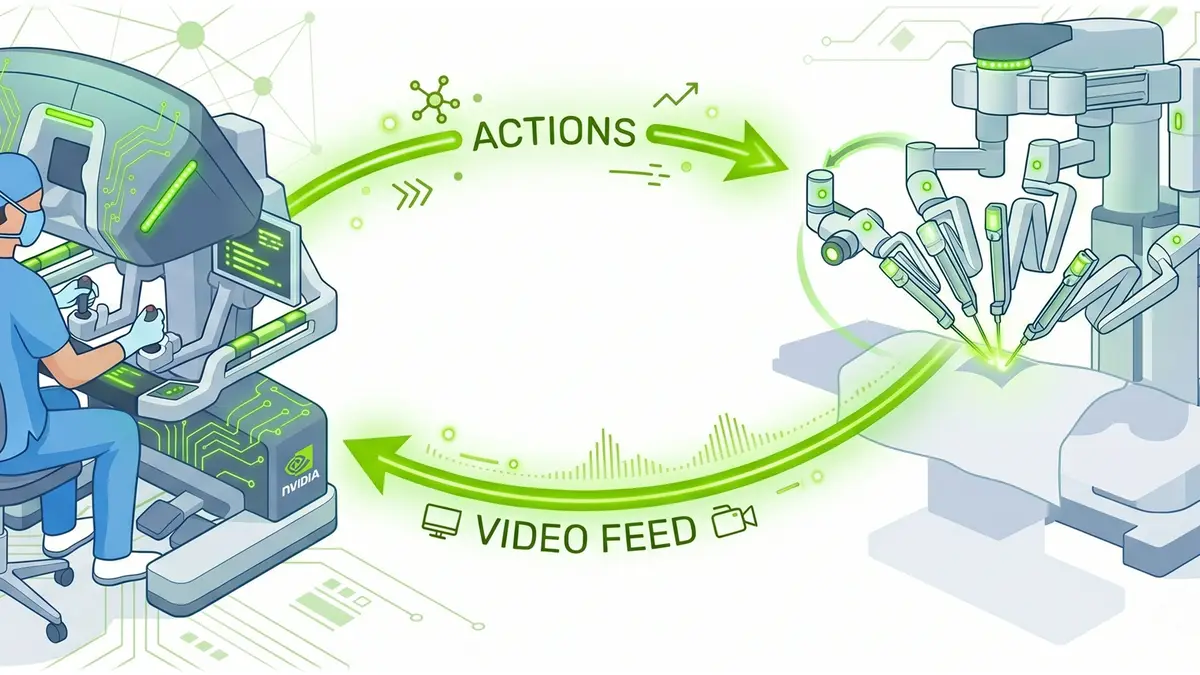
NVIDIA、器具の操作に反応して手術映像を生成する「Cosmos3-H-Dreams」を公開 胆のう摘出手術の記録で学習、RTX PRO 6000 1枚で毎秒30フレーム
NVIDIA、器具の操作に反応して手術映像を生成する「Cosmos3-H-Dreams」を公開胆のう摘出手術の記録で学習、RTX PRO 6000 1枚で毎秒30フレーム
研究
OpenAI、APIで「12時間プロンプトキャッシュ」を選べるように 書き込みは入力価格の2.5倍、読み出し料金は30分版と同じ
OpenAI、APIで「12時間プロンプトキャッシュ」を選べるように書き込みは入力価格の2.5倍、読み出し料金は30分版と同じ
プロダクト
ChatGPT、選んだ会話をPINで隠せる「ロックチャット」を追加 Free・Go・Plus・Proに順次提供、暗号化ではなく保存期間も変わらない
ChatGPT、選んだ会話をPINで隠せる「ロックチャット」を追加Free・Go・Plus・Proに順次提供、暗号化ではなく保存期間も変わらない
プロダクト
Sakana AI(サカナAI)、推薦の「選ぶ理由」を進化させる手法QD-Rec(キューディーレック)を論文とコード付きで公開 M&A・顧客・論文の3課題で、多くの設定で平均評価が高いと報告
Sakana AI(サカナAI)、推薦の「選ぶ理由」を進化させる手法QD-Rec(キューディーレック)を論文とコード付きで公開M&A・顧客・論文の3課題で、多くの設定で平均評価が高いと報告
研究
 動画
MiniMax(ミニマックス)、新モデル「M3.1 Flash」を提供開始 入力$0.15・出力$0.60(100万トークン)、エージェント用途のコストは前世代比70%減と同社
MiniMax(ミニマックス)、新モデル「M3.1 Flash」を提供開始入力$0.15・出力$0.60(100万トークン)、エージェント用途のコストは前世代比70%減と同社
モデル
Amazon、PyTorchのコードを書き換えずにAWS Trainium(トレイニアム)で動かす「TorchNeuron(トーチニューロン)」を10月20日にオープンソース化 Apache 2.0、対応はTrainium2・Trainium3
Amazon、PyTorchのコードを書き換えずにAWS Trainium(トレイニアム)で動かす「TorchNeuron(トーチニューロン)」を10月20日にオープンソース化Apache 2.0、対応はTrainium2・Trainium3
検証
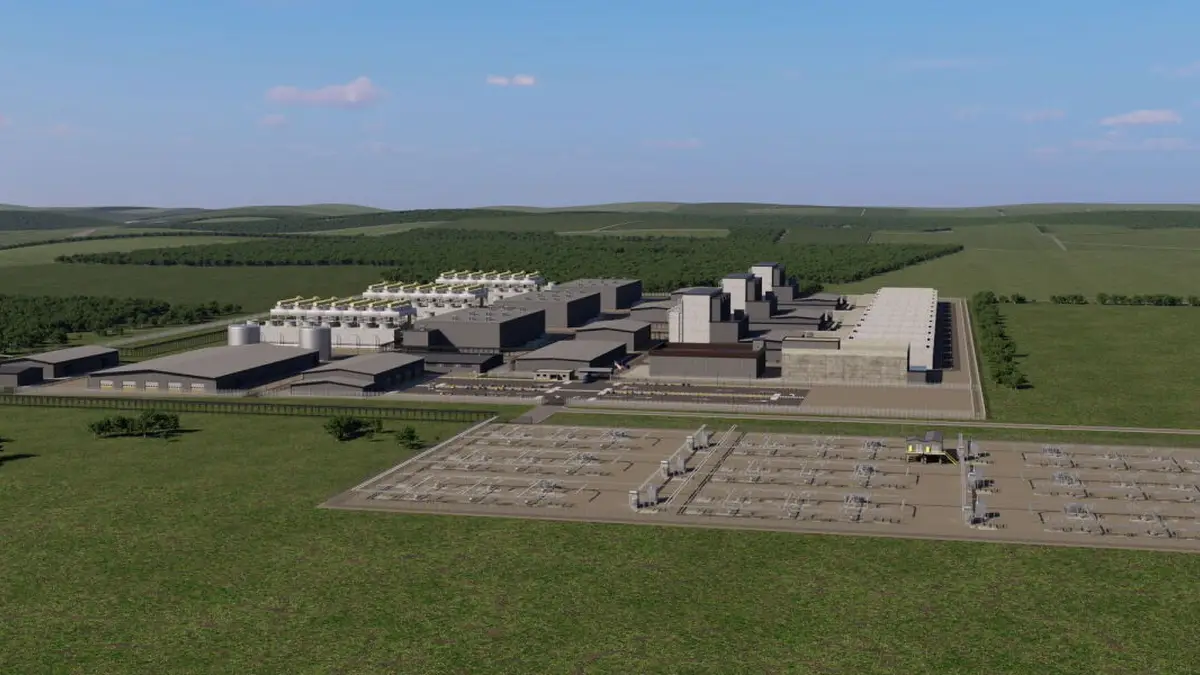
Amazon、X-energy(エックスエナジー)・AEPとインディアナ州で出力960MWの小型モジュール炉を検討 Xe-100を12基、開発資金の出し手として参加
Amazon、X-energy(エックスエナジー)・AEPとインディアナ州で出力960MWの小型モジュール炉を検討Xe-100を12基、開発資金の出し手として参加
業界
AWS、Amazon Bedrock(ベッドロック)のClaude(クロード)全モデルで構造化出力を一般提供 JSONスキーマ出力と厳密なツール利用、ただしbedrock-mantleの扱いはブログと技術文書で食い違い
AWS、Amazon Bedrock(ベッドロック)のClaude(クロード)全モデルで構造化出力を一般提供JSONスキーマ出力と厳密なツール利用、ただしbedrock-mantleの扱いはブログと技術文書で食い違い
プロダクト
AWS、TwelveLabsの動画言語モデル「Pegasus 1.5(ペガサス)」をAmazon Bedrockで提供 2時間までの動画から条件に合う区間をタイムスタンプ付きJSONで返す、提供リージョンは米国オレゴン
AWS、TwelveLabsの動画言語モデル「Pegasus 1.5(ペガサス)」をAmazon Bedrockで提供2時間までの動画から条件に合う区間をタイムスタンプ付きJSONで返す、提供リージョンは米国オレゴン
モデル
AWS、Amazon SageMaker(セージメーカー)Studioを新規アカウントですぐ使える形に Google・GitHub・Apple・Amazonのアカウントかメールで登録、約20秒で環境ができ、$100のFree Tierクレジット付き
AWS、Amazon SageMaker(セージメーカー)Studioを新規アカウントですぐ使える形にGoogle・GitHub・Apple・Amazonのアカウントかメールで登録、約20秒で環境ができ、$100のFree Tierクレジット付き
プロダクト
AWS、vLLM(ブイエルエルエム)に双方向KV転送を提供 マルチターンのエージェント処理で初回トークンまでの時間をP5enで最大1.6倍・3.3倍短縮と発表
AWS、vLLM(ブイエルエルエム)に双方向KV転送を提供マルチターンのエージェント処理で初回トークンまでの時間をP5enで最大1.6倍・3.3倍短縮と発表
検証
AWS、vLLM(ブイエルエルエム)のprefill/decode分離推論にpush型のKV転送を追加 P5enのQwen3-32Bで初回トークンまでの時間が最大約3倍、トークンあたり時間が最大30%改善と発表
AWS、vLLM(ブイエルエルエム)のprefill/decode分離推論にpush型のKV転送を追加P5enのQwen3-32Bで初回トークンまでの時間が最大約3倍、トークンあたり時間が最大30%改善と発表
検証
GitHub Copilot(コパイロット)、Gemini 3.7 Flash・GPT-5.5など6モデルを10月19日付で廃止 9月の予告から、代替モデルの名前が3件変わっていた
GitHub Copilot(コパイロット)、Gemini 3.7 Flash・GPT-5.5など6モデルを10月19日付で廃止9月の予告から、代替モデルの名前が3件変わっていた
プロダクト
Google、オンデバイスAI用LiteRT(ライトアールティー)にC++でモデルを組み立てる「Tensor API(テンソルAPI)」 SAM 2はMacBook ProでApple MLX比約1.5倍と同社
Google、オンデバイスAI用LiteRT(ライトアールティー)にC++でモデルを組み立てる「Tensor API(テンソルAPI)」SAM 2はMacBook ProでApple MLX比約1.5倍と同社
検証
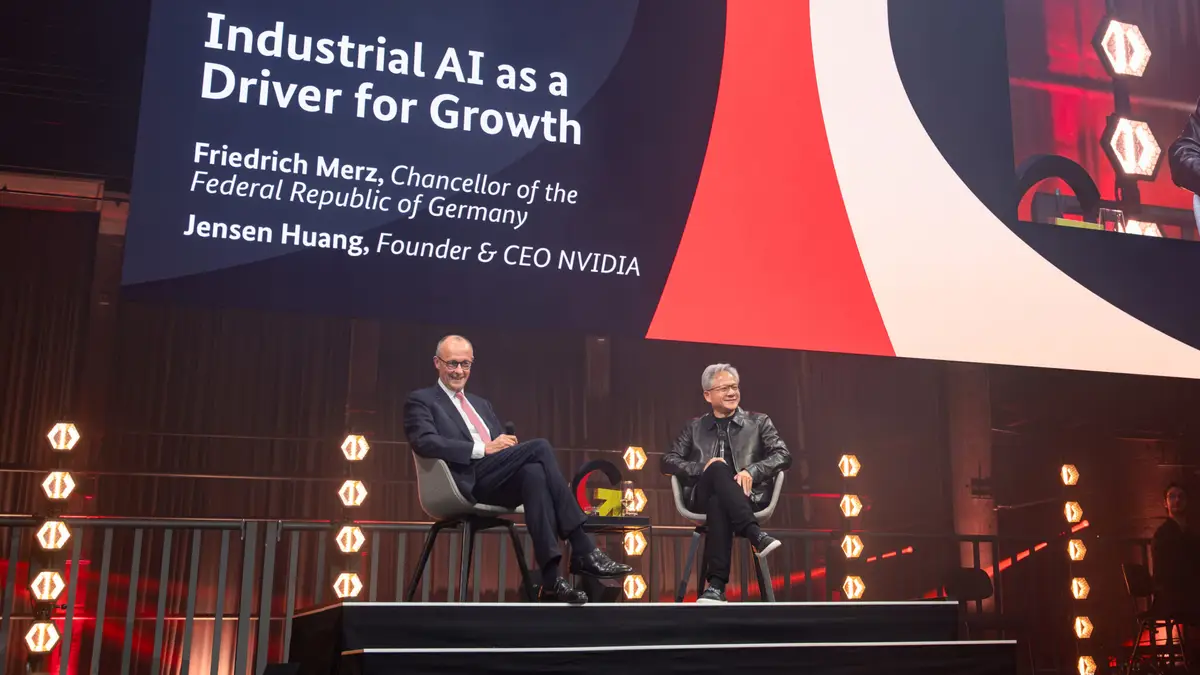
NVIDIA、ドイツ連邦政府とフィジカルAI向けモデルの共同意向表明に署名 Agile Robotsなど独スタートアップ4社への投資も発表
NVIDIA、ドイツ連邦政府とフィジカルAI向けモデルの共同意向表明に署名Agile Robotsなど独スタートアップ4社への投資も発表
業界
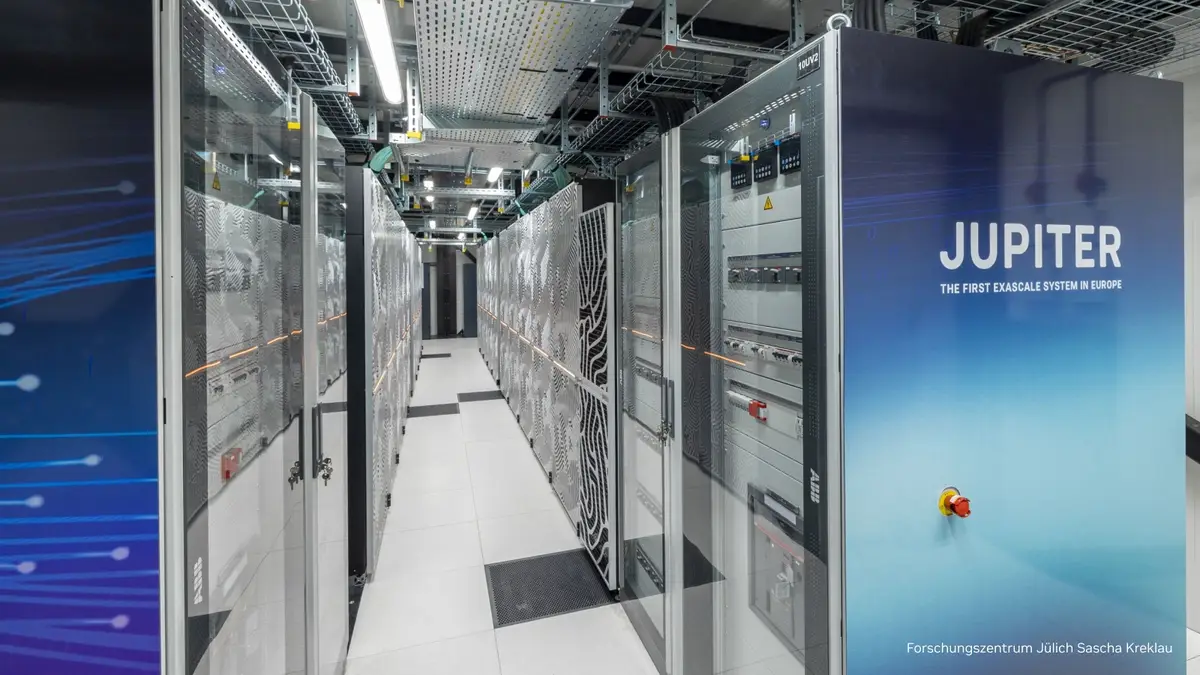
NVIDIA、欧州初のエクサスケール機JUPITER(ジュピター)で104量子ビットの耐故障量子計算を模擬 8,192 GPUで「過去最大規模」と発表
NVIDIA、欧州初のエクサスケール機JUPITER(ジュピター)で104量子ビットの耐故障量子計算を模擬8,192 GPUで「過去最大規模」と発表
研究