NVIDIA、器具の操作に反応して手術映像を生成する「Cosmos3-H-Dreams」を公開胆のう摘出手術の記録で学習、RTX PRO 6000 1枚で毎秒30フレーム
日刊AIニュース10月20日(火)号:前日のAIのニュース12本を短くまとめました(約8分)›
NVIDIAは2026年10月20日、臨床の胆のう摘出手術の映像と器具の動きで学習した手術シミュレーター「Cosmos3-H-Dreams」を公開した。RTX PRO 6000 Blackwell 1枚で4ステップ版は毎秒30.0フレーム、2ステップ版は43.2フレーム。研究用で、患者のケア向けに検証されたものではないと同社は明記している。
目次
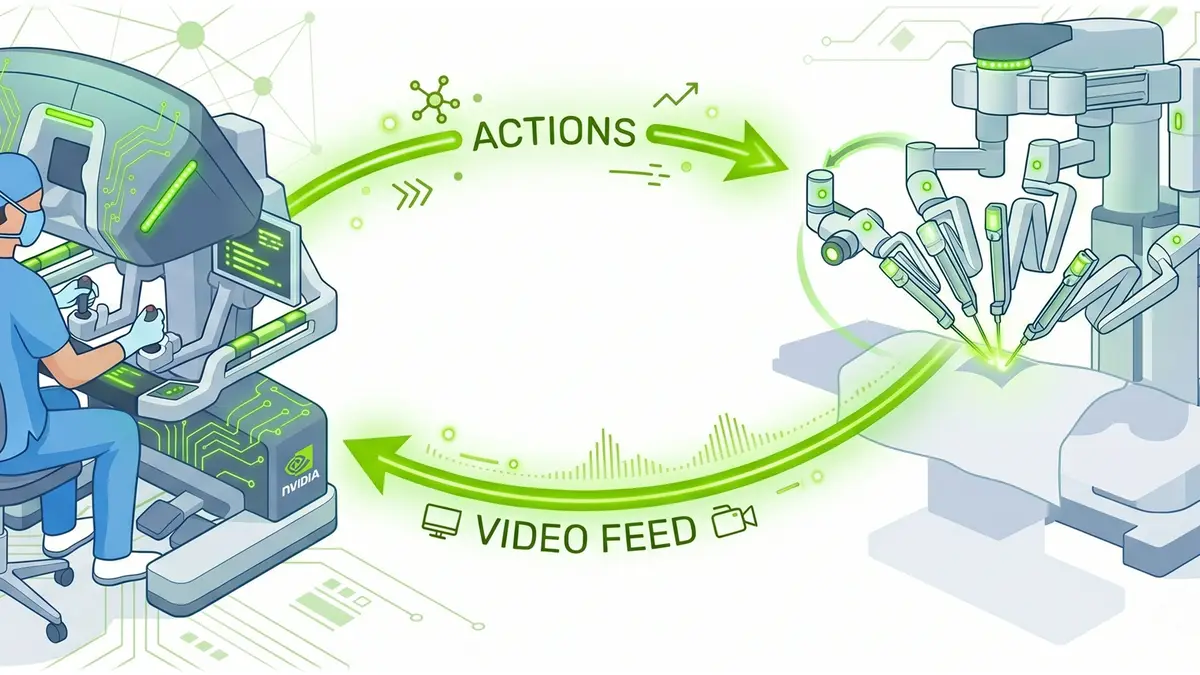
NVIDIAは2026年10月20日(米国時間)、臨床の胆のう摘出手術の映像と器具の動きのデータで学習した手術シミュレーター「Cosmos3-H-Dreams」を公開しました。Cosmos(コスモス)という同社の世界モデル群のひとつで、最初の1枚の内視鏡画像と器具の操作データを渡すと、その操作に応じた手術映像を続けて生成します。Hugging Faceのブログは日本時間10月21日3時台の公開で、4ステップ版と2ステップ版の2つの重み、再現用の手順書、実行用のコードが案内されています。NVIDIAはこれを「研究用のシミュレーターで、患者のケア向けに検証されたシステムではない」と書いています。
3行まとめ
- NVIDIAがCMR Surgical社の手術ロボット Versius の胆のう摘出手術の記録(元データ4,792エピソードから選別した64録画・約526分)で学習した手術シミュレーター「Cosmos3-H-Dreams」を10月20日に公開
- RTX PRO 6000 Blackwell Workstation Edition 1枚で、832×480の生成が4ステップ版で毎秒30.0フレーム、2ステップ版で43.2フレーム(モデルカード記載)
- 利用はNVIDIA Open Model License、コードはApache-2.0。NVIDIAは「研究用で、患者のケア向けに検証されたものではない」と明記
本記事の内容は、日本時間10月21日3時台に公式ページで確認したものです。
何ができるモデルなのか
NVIDIAのブログによると、手術ロボットの器具を動かすと、それに反応して手術の画面が変わる様子を、物理シミュレーションではなく映像生成で再現するモデルです。ブログは、組織の形や物理的な相互作用を数式で組み立てる代わりに、映像とロボットの動きのデータから見た目の変化を直接学んでいる、と説明しています。
入力と出力は、モデルカードでは次のように書かれています。
| 項目 | 内容(モデルカード・ブログの記載) |
|---|---|
| 入力 | 内視鏡カメラの1フレーム、直近の操作の履歴(最大16ステップ・1.6秒)、今後の操作データ |
| 操作データ | 28次元。左右のアームそれぞれに位置・回転・開閉、電気メスのエネルギー、サムスティックのボタンと軸 |
| 出力 | mp4の映像。既定では72フレーム(10Hzで7.2秒)、4フレーム(0.4秒)ずつストリーム生成 |
| 解像度 | 832×480 |
| パラメータ数 | 約150億(15.17B) |
| 構造 | Mixture-of-Transformers(Qwen3-VL-8B-Instructの推論部分+映像生成の専門部分) |
想定する使い方は、手術ロボットの方針(ポリシー)をシミュレーション上で評価すること、遠隔操作で世界モデルを試すこと、胆のう摘出ロボット用の合成データを作ることだとモデルカードは書いています。ブログの冒頭は、「Cadiere(カディエール)把持鉗子を動かし、胆のうをつかんで持ち上げる」操作に、生成された手術の場面が即座に応える、という例で始まっています。
何で学習し、どう速くしたのか
ブログとモデルカードによると、学習は次の3段階です。
- 初期化: 複数の手術ロボットのデータセット「Open-H-Embodiment」で学習済みの Cosmos3-H-Embodied-Nano(16B)から出発
- 教師モデルの微調整: Versius の胆のう摘出データで、まず24フレーム先まで(2,000イテレーション)、次に72フレーム先まで(4,400イテレーション)。操作の次元は20から28に拡張
- リアルタイム化の蒸留: 双方向の教師モデルを、短いブロックごとに生成する因果的な生徒モデルに蒸留。Causal teacher forcing(1,000イテレーション)のあと、Self-Forcing(300イテレーション)で生徒自身の生成履歴から学ばせる
ブログは、4ステップ版を最初の生徒モデルとし、2ステップ版はそれをさらに別に訓練したもので「4ステップ版をサンプリング回数だけ減らしたものではない」と説明しています。また、ステップを減らすと推論は速くなる一方で映像の質は下がるとも書いています。長い生成の途中で過去の記憶(KVキャッシュ)が膨らむ問題には、FadeMem という方式を取り入れた圧縮で対応しています。実行基盤は NVIDIA の高速ストリーミング推論ライブラリ FlashDreams です。
学習データの規模は、モデルカードによると次のとおりです。
| 項目 | 数字 |
|---|---|
| 元データ | CMR Surgical Versius の胆のう摘出手術 4,792エピソード、約1,700万フレーム(60Hz・1080p) |
| 実際に学習に使った量 | 64録画、約526分(蒸留に使った72フレーム設定は約436分) |
| 選別の条件 | 内視鏡に器具がちょうど2本映り、両方が操作中。カメラ操作のある区間は除外 |
| 検証・テスト | 学習に使わない10録画、約10.6分 |
| 評価用のケース | 2つのパネルで計120ケース(品質48+操作の追従12を各パネル) |
モデルカードでは、元データが「4,792エピソード」、選別後の学習量が「64録画・約526分」と書かれています。エピソードと録画の関係はモデルカードに書かれていないため、この2つの数字は単純に比べられません。学習データはCMR Surgical社の臨床データで、モデルカードのリンク欄には「Proprietary(独自データ)」とあります。
どのGPUで、どのくらいの速さで動くのか
モデルカードの推論性能の表です。いずれも832×480(DGX Sparkのみ512×288)です。
| GPU | 拡散ステップ数 | 毎秒フレーム数 |
|---|---|---|
| RTX PRO 6000 Blackwell Workstation Edition | 4 | 30.0 |
| RTX PRO 6000 Blackwell Workstation Edition | 2 | 43.2 |
| RTX PRO 6000 Blackwell Max-Q Workstation Edition | 4 | 20.2 |
| RTX PRO 6000 Blackwell Max-Q Workstation Edition | 2 | 31.2 |
| DGX Spark(512×288に下げて動作) | 2 | 16.9 |
モデルカードは、対応するハードウェアをBlackwellとHopperとし、H100でも動くと書いています。OSはLinuxで、ほかのOSは試していないとのことです。精度はBF16で学習・推論しており、ほかの精度や量子化は検証していないと書かれています。GitHubのシステム要件には、既定設定(480×832、履歴12潜在フレーム)でGPUメモリが32GB超必要とあります。
誰が、どう使えるのか
| 項目 | 内容 |
|---|---|
| 公開日 | GitHub・Hugging Faceとも2026年10月20日(モデルカード記載) |
| モデルの使用条件 | NVIDIA Open Model License Agreement。モデルカードは商用・非商用どちらにも使えると記載 |
| コードの条件 | Apache-2.0(GitHub) |
| 提供地域 | モデルカードの「Deployment Geography」は Global |
| 主な対象 | 手術ロボット研究者、ヘルスケアAI開発者、大学・研究機関、手術ロボット企業 |
| 対応ロボット | CMR Surgical Versius(モデルカード) |
GitHubのクイックスタートは、Python 3.12とuv、NVIDIA GPU環境を前提に、重みと初期画像を自分で用意して動かす手順になっています。記録済みの操作を再生してmp4を出す方法と、VRヘッドセットのコントローラーで操作する方法の両方が案内されています(クイックスタートのコマンド例はヘッドセット用で、再生の手順は別のドキュメントです)。ヘッドセット側はWebXR対応ブラウザと、追跡される2本のコントローラーが必要です。重みとトークナイザー類は別に取得する形で、初回は外部のモデル素材が自動でダウンロードされる場合があると注意書きがあります。
自分のデータで学び直したい人向けには、教師モデルの微調整からSelf-Forcing蒸留までの手順書が公開されています。ブログは、操作の表現と正規化は学習時と同じにそろえる必要があると書いています。
前の版(Cosmos-H-Dreams)と何が違うのか
ブログによると、最初の Cosmos-H-Dreams は Cosmos-Predict2.5 をもとに、dVRKという研究用ロボットのテーブル上の縫合課題を扱っていました。今回の Cosmos3-H-Dreams は、臨床の胆のう摘出手術の記録に切り替わっています。
| 項目 | Cosmos-H-Dreams(前版) | Cosmos3-H-Dreams |
|---|---|---|
| 土台 | Cosmos-Predict2.5 | Cosmos3-H-Embodied-Nano(Cosmos3-Nano 由来) |
| 対象 | dVRKのテーブル上の縫合 | Versius の臨床胆のう摘出 |
| 操作の次元 | — | 28(土台モデルの Versius 用20次元に、電気メスのエネルギーとサムスティックを追加) |
前版の操作次元はブログ・モデルカードに書かれていないため空欄にしています。なお、ブログは「われわれの知る限り、臨床の胆のう摘出の記録で学習し、リアルタイムの運動制御に対応した初の生成型手術シミュレーター」と述べています。これはNVIDIA自身の主張で、他社の事例との比較は今回確認したページにはありません。
筆者が公式ページで見た、記載のずれ
日本時間10月21日3時22〜23分に3つの公式ページを続けて取得して読んだところ、2ステップ版の扱いが完全にはそろっていませんでした。
- ブログは「4ステップ版と2ステップ版のチェックポイントを含む」と書いている
- Hugging Faceのモデルカードの「Model Version(s)」は、v1.0として「蒸留した4ステップの因果的な生徒モデル」だけを挙げている。性能表には2ステップの行がある
- GitHubのクイックスタートは、2ステップ用の設定ファイルと
c3-h-d_2-step_model_bf16.safetensorsというファイル名を例示している。一方、Resourcesの欄では、Hugging Faceのリポジトリを「前のバージョンのモデルリポジトリ」と呼んでいる
私は重みのダウンロードも実行もしていないため、Hugging Face上のファイル一覧に2ステップ版の重みがすでにあるかは確認していません。取得した時点のページの記載がこうなっていた、という報告です。
数字で示されていない部分と、研究用という位置づけ
今回取得した Cosmos3-H-Dreams のブログ・モデルカード・GitHubの3ページには、生成映像の画質を測るPSNRやFVDのような数値の評価表は見当たりませんでした(本記事が取得した範囲での確認です)。モデルカードの「Key performance」は、操作に応じた手術映像を生成する、という説明にとどまっています。ベースモデルである Cosmos3-H-Embodied-Nano のモデルカードには、PSNR、FID、FVDなどの比較表があります。ただし、それは Cosmos3-H-Dreams そのものの数字ではないため、本記事では引用していません。
位置づけについて、NVIDIAは次のように書いています。
These are research directions, not established clinical capabilities. Cosmos3-H-Dreams is a research simulator, not a validated system for patient care. (これらは研究の方向性であり、確立された臨床能力ではない。Cosmos3-H-Dreams は研究用のシミュレーターであり、患者のケアのために検証されたシステムではない)
ブログは、映像がそれらしく見えることは検証の出発点であって、生体力学的な正確さの証明ではない、とも述べています。今後の課題として、手術全体への拡張、数値シミュレーションとの接続、外科医による評価、器具の本数を増やすこと、自律的な手術ポリシーの学習を挙げています。「外科医による評価」は今後の課題として挙げられており、外科医の評価をまとめた結果はブログには載っていません。
そのほか、モデルカードとブログから読み取れる範囲の条件は次のとおりです。
- 学習に使ったのは、器具が2本(左がCadiere把持鉗子、右がモノポーラフック)映る場面で、カメラ操作のある区間は除外されている
- 対応ロボットは Versius で、ほかのロボットで使うには、互換性のある操作データでの適応が必要
- ブログの冒頭は、組織が引っぱられて伸びる、反射が動く、構造物が隠れる、煙で見えにくくなる、といった体内の変化を再現する難しさと、誤差が時間とともに積み重なる問題を挙げている
日本での提供についての記載は、今回取得したページでは「Global」という提供地域の表記のみで、日本の法規制や医療機器としての扱いに触れた記述は見当たりませんでした。
出典と確認時刻(本記事は続報があり次第更新します)
- NVIDIA, "NVIDIA Cosmos3-H-Dreams: Bringing Clinical Surgery to Life Through Generative Simulation"(Hugging Faceブログ、2026年10月20日): https://huggingface.co/blog/nvidia/cosmos3-h-dreams
- NVIDIA, モデルカード「nvidia/Cosmos3-H-Dreams」: https://huggingface.co/nvidia/Cosmos3-H-Dreams
- NVIDIA, モデルカード「nvidia/Cosmos3-H-Embodied-Nano」: https://huggingface.co/nvidia/Cosmos3-H-Embodied-Nano
- NVIDIA(isaac-for-healthcare), GitHub「cosmos3-h-dreams」: https://github.com/isaac-for-healthcare/cosmos3-h-dreams
確認時刻は、ブログが日本時間2026年10月21日3時22分、モデルカード2件とGitHubが同3時23分です。数字はすべて上記の公式ページの記載で、AI時短ラボでは製品を動かしていません。NVIDIAの直近の別の発表は NVIDIA、英国のエージェントAI安全研究に5年で2.5億ドルの計算資源を提供 でも扱っています。
この記事でよく聞かれること
- Cosmos3-H-Dreams とは何ですか?
- NVIDIAが2026年10月20日に公開した、手術ロボットの器具の操作(動かす・つかむ・エネルギーのオンオフなど)に応じて、内視鏡の手術映像を次々に生成するシミュレーターです。CMR Surgical社の Versius(ヴァーシアス)というロボットでの胆のう摘出手術の記録で学習しています。NVIDIAは研究用のシミュレーターで、患者のケア向けに検証されたものではないと書いています。
- Cosmos3-H-Dreams はどんなGPUで動きますか?
- モデルカードによると、リアルタイムの対話的な動作はRTX PRO 6000 1枚とDGX Sparkで確認されています。RTX PRO 6000 Blackwell Workstation Editionでは、832×480で4ステップ版が毎秒30.0フレーム、2ステップ版が43.2フレームです。H100でも動くと書かれています。GitHubのシステム要件ではLinuxとNVIDIA GPUが必要で、既定設定のGPUメモリは32GB超です。
- Cosmos3-H-Dreams は商用で使えますか?
- モデルカードは「商用・非商用の利用に使える」としたうえで、利用はNVIDIA Open Model License Agreementに従うとしています。コードはApache-2.0です。ただし用途は手術ロボットの研究者やヘルスケアAIの開発者向けで、ブログは「患者のケア向けに検証されたシステムではない」と明記しています。
- 自分のデータで学習し直せますか?
- ブログによると、同期した映像と互換性のある操作データがあれば他のデータセットや機体にも適応でき、教師モデルの微調整と Self-Forcing 蒸留までの手順書が公開されています。ただし操作の表現や正規化は学習時と同じにする必要があると書かれています。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開 生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIA「Magpie TTS Multilingual」 3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
NVIDIA「Magpie TTS Multilingual」3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
フィラデルフィア小児病院、オープンソースのNVIDIA AIで子どもの心臓を数秒でモデル化 MONAI Label+Auto3DSegで、熟練研究者が4時間かけていたCT・MRI・3D超音波からの心臓模型作りを数秒に。米国20超の小児病院が心臓モデリング、ボストン小児は年約500例。NewtonとWarpで機器を入れた時の挙動を最大4時間→ほぼリアルタイムに
フィラデルフィア小児病院、オープンソースのNVIDIA AIで子どもの心臓を数秒でモデル化MONAI Label+Auto3DSegで、熟練研究者が4時間かけていたCT・MRI・3D超音波からの心臓模型作りを数秒に。米国20超の小児病院が心臓モデリング、ボストン小児は年約500例。NewtonとWarpで機器を入れた時の挙動を最大4時間→ほぼリアルタイムに
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル 天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
NVIDIA公式のAgent Skillsカタログを開くと「OpenClaw上でOpenClawを動かす」スキルまであった
NVIDIA公式のAgent Skillsカタログを開くと「OpenClaw上でOpenClawを動かす」スキルまであった
Hugging Face(ハギングフェイス)とは AIのモデル・データ・デモアプリを共有するサイト。見るだけなら無料、有料は月$9のPRO〜【2026年10月版】
Hugging Face(ハギングフェイス)とはAIのモデル・データ・デモアプリを共有するサイト。見るだけなら無料、有料は月$9のPRO〜【2026年10月版】
Ai2、LLMの公平性を「説得されたときの変わりやすさ」で測るFairStress(フェアストレス)を公開 300場面・1,300万件超、データとコードも配布
Ai2、LLMの公平性を「説得されたときの変わりやすさ」で測るFairStress(フェアストレス)を公開300場面・1,300万件超、データとコードも配布