
Microsoft AI、総パラメータ2.8兆のMoE基盤モデル「MAI-Base-2(マイ・ベース・ツー)」の事前学習を完了DeepSeek-V4-Pro-Baseより4.2〜12.3倍計算効率が高いと主張
Microsoft AIは2026年10月15日、総パラメータ2.8兆・アクティブ800億のMoE基盤モデル「MAI-Base-2」の事前学習を完了したと発表した。同社はDeepSeek-V4-Pro-Baseより4.2〜12.3倍、FLOPs効率が高いと説明する。現在はポストトレーニング中で、同社は自社モデルの重みをFoundry経由で提携先にライセンスできるようになるとしている。
目次
Microsoft AIは2026年10月15日(現地、日本時間10月16日午前1時台)、総パラメータ2.8兆・アクティブ800億のMoE(Mixture of Experts)基盤モデル「MAI-Base-2(マイ・ベース・ツー)」の事前学習を完了したと、公式サイトの「Lab Notes」で発表した。同社は、試した公開重みのモデルを自社の保持評価で上回り、公開重みの基盤モデルのうち最も強いものとして挙げる DeepSeek-V4-Pro-Base より事前学習のFLOPs効率が4.2〜12.3倍高いと説明している。同社によると MAI-Base-2 は現在ポストトレーニング中で、同社は自社モデルの重みを Foundry 経由で提携先にライセンスできるようになると書いている。
3行まとめ
- Microsoft AIが総パラメータ2.8兆・アクティブ800億のMoE基盤モデル「MAI-Base-2」の事前学習完了を発表。16,000基のGB200で38日間、学習データは50Tトークン。
- 同社は DeepSeek-V4-Pro-Base より4.2〜12.3倍FLOPs効率が高いと推定(同社の発表)。MAI-Base-1(6月)からの改善は6.3〜12.7倍とする。
- 同社によると現在ポストトレーニング中。自社モデルの重みをFoundry経由で信頼できる提携先にライセンスできるようになるとし、利用開始日・料金は今回のページに記載なし。
本記事の内容は、日本時間10月16日1時台(1時18分)に公式ページで確認したものです。
何が発表されたのか
発表の中心は、基盤モデル(事前学習だけを終えた、指示への応答などの調整前のモデル)の完成報告だ。公式ページは次の点を述べている。
- 6月に発表した汎用モデル MAI-Thinking-1 は、MAI-Base-1 の上にポストトレーニングしたもの。今回の MAI-Base-2 は、その次の世代の基盤モデルにあたる。
- MAI-Base-2 は、アクティブ800億・総計2.8兆パラメータのMoE。
- 同社が試した公開重みのモデルすべてを、保持評価(学習に使っていないデータでの評価)で上回る。
- 同社が公開重みの基盤モデルのうち最も強いものとして挙げる DeepSeek-V4-Pro-Base に比べ、事前学習のFLOPs効率が4〜12倍高い。同社は、その節約分をより大きなモデルの学習に回したと書いている。
MAI-Base-1 との差を、公式ページの記載で並べると次のとおり。
| 項目 | MAI-Base-1 | MAI-Base-2 |
|---|---|---|
| 規模 | 公式ページに数字なし(MAI-Thinking-1 の紹介ページでは、アクティブ350億・総計約1兆のMoEと記載) | アクティブ800億・総計2.8兆のMoE |
| MoE層 | 1層おきにMoE | 全層にMoE |
| オプティマイザ | 公式ページに記載なし | Muon(AdamWより安定し、効率が大きく上がったと同社) |
| 画像 | 画像を最初から一緒に学習する構成ではない(公式ページに「MAI-Base-1と異なり」とある) | 画像を最初から学習(エンコーダーなしのVLM構成) |
| 学習コーパス | 基準 | 一意なトークン数で約36%増 |
なお、MAI-Thinking-1 の規模を MAI-Base-1 の規模とみなしてよいかは、今回の2ページには明記がない。上の表の括弧書きは、別ページの MAI-Thinking-1 の数字として読んでほしい。
4.2〜12.3倍という数字の意味
この倍率は、実際に両モデルを同じ条件で学習して測ったものではない。公式ページの説明は次の手順だ。
- 比較の基準に DeepSeek-V4-Pro-Base を選ぶ。同社は、1兆パラメータを超える公開済みの基盤モデルの事前学習チェックポイントはこれだけだと書く。ただし、MAI-Base-2 よりは大幅に少ないFLOPsで学習されているとも書いている。
- 4つの保持評価ごとに、BPB(bits-per-byte、トークナイザーによらず比べられる指標。低いほど良い)と学習FLOPsの関係に、独立のスケーリング則を当てはめる。
- 自社のスケーリングラダー(同じ学習レシピで大きさだけを変えたモデル群)が、DeepSeek-V4-Pro-Base のBPBに並ぶために必要な計算量を推定する。
- その推定量を、DeepSeek-V4-Pro-Base の実際の学習計算量と比べる。結果が4.2〜12.3倍。
同社は、MAI-Base-2 の最終成績も当てはめに含めているため、並ぶ点は当てはめたモデル群の範囲内に収まると説明している。MAI-Base-1 との比較では、6月のリリース以降の進歩が6.3〜12.7倍のFLOPs効率の改善になったという。
評価データについては、保持コードには MAI 自身のコードベースを使い、STEM・数学・Q&Aの評価は汚染(学習データとの混入)のリスクを減らすため外部ベンダーに委託して作ったと書かれている。すべての評価セットは、学習データに対して除染(decontamination)したともある。
比較したモデルは、2026年10月より前に入手できたチェックポイントで、DeepSeek-V4-Pro-Base のほか Kimi K3・Qwen3.8-2.4T-A95B・MiMo-V2.6-Pro-RL。後ろの3つはポストトレーニング済みのチェックポイントしか手に入らず、同社は「ポストトレーニングが評価に影響しうる」という但し書きつきで結果を載せている。
どう学習したのか(公式ページの技術パートから)
規模の数字は次のとおり。いずれも同社の発表による。
| 項目 | 数字 |
|---|---|
| 学習に使ったGPU | 16,000基のGB200 |
| 期間 | 2026年8〜9月の38日間 |
| 平均MFU(モデルFLOPs利用率) | 21%(GB200のBF16理論最大2.5 PFLOPSで正規化、再計算とオプティマイザのFLOPsは除く) |
| goodput(学習が進んでいた時間の割合) | 89% |
| 学習データの混合 | 50Tトークン |
| 画像・文書データ(VLMコーパス) | 一意なトークンで4.5T、反復込みで混合の18% |
| 知識のカットオフ | 2026年3月 |
同社が成功の要因に挙げた3つの取り組みと、ページ内の具体的な記述は次のとおり。
- スケーリングの科学: 小さいモデルで同じデータを繰り返し学習する影響を揃える「source scaling」を導入。これが2.8兆モデルへ確実に拡大するための鍵だったと書く。学習率・重み減衰・ドロップアウトのスケーリング則も導出し、中規模で検証したうえでMAI-Base-2のハイパーパラメータに使った。
- モデルとインフラの共同設計: MoE層のMFUを24%から35%に引き上げ、全層MoEを採用できるようにした。Muon の処理は平均の学習1ステップの2.1%(165ミリ秒)に収めた。ほかに、活性化の勾配をクリップする方式で学習の安定性が上がり、スケールが大きいほど効果が増したという。
- データの拡大: コーパスを一意なトークン数で約36%拡大し、画像・文書データを加えた。
学習データの方針について、同社は「他のモデルからの蒸留に頼らない、オーガニックなデータ」「学習トークンはすべて社内で処理した」と書く。ウェブデータは、robots.txtなどを尊重する独自クローラーで集め、Microsoft の責任あるAIの方針に反するソースや、米通商代表部(USTR)の悪質市場リストに載るソースは除いたとの脚注もある。
誰がいつから使えるのか・日本では
今回確認した公式ページには、MAI-Base-2 の利用開始日・価格・提供地域(日本を含む)・API名の記載がない。書かれているのは次の2点だ。
- 重みを Foundry 経由で「信頼できる提携先」にライセンスできるようになる、という方針。「自社の製品で最初に、その後 Foundry の顧客向けに」性能とコストを詰めるとも書く。
- MAI-Base-2 は現在ポストトレーニング中で、結果を「近く」共有する。「次世代モデル」についても近く共有すると予告し、MAI-Base-3 の準備もすでに始まっているという。
参考までに、前世代の MAI-Thinking-1 は、別ページ(2026年8月12日付)で Microsoft Foundry のパブリックプレビューとして公開されている。256kトークンのコンテキスト、関数呼び出し、Chat Completions API 互換とも書かれている。MAI-Base-2 から作られるモデルが同じ形で出るとは、今回のページには書かれていない。
Microsoft の自社チップ側の動きは、別記事の Microsoft、Azure Maiaを2027年からマルチギガワット規模に拡大 にまとめている。MAI-Thinking-1 のページは、方針の1つとして「Microsoft自社のアクセラレーターとのモデルの共同設計」を挙げている。
取得したページで気づいた2点
日本時間1時18分にページを取得した時点で、筆者が気づいた点を2つ書いておく。
1つ目は、図の数字が本文テキストから取れなかったこと。ページは本文中で Figure 1 や Figure 3 など番号付きの図を10番まで参照しており、MAI-Base-2 と他モデルのBPBの値は Figure 1 にあるはずだが、今回取得したテキストにはその数値が含まれていない(ページには「Download the PDF」のリンクがあるが、筆者はPDFを取得していない)。このため、本記事は「各モデルのBPBがいくつだったか」には触れていない。
2つ目は、MAI-Thinking-1 の発表時期が2ページで食い違っていること。今回のページは「6月に MAI-Thinking-1 を発表した」と書く。一方、MAI-Thinking-1 の紹介ページの公開日表示は2026年8月12日で、「Updated as of August 12, 2026」という注記があり、パブリックプレビュー開始を告げている。6月の発表と8月のプレビュー公開が別々の出来事なのかは、今回取得した2ページだけでは確かめられなかった。本記事では、日付の部分は各ページの記載を並べるにとどめた。
4.2〜12.3倍の数字だけでは分からないこと
- 倍率は同社の推定。第三者による検証は、今回確認した範囲にはない。同社は、保持評価のうちコードは自社のコードベースを使い、STEM・数学・Q&Aは外部ベンダーに委託して作ったと説明している。
- 比較は基盤モデルどうしのBPBが中心で、ポストトレーニング後の性能(対話・コーディング・推論のベンチマーク)は今回のページに載っていない。
- 比較対象の一部(Kimi K3・Qwen3.8-2.4T-A95B・MiMo-V2.6-Pro-RL)は、ポストトレーニング済みの重みで比べており、同社自身が影響の可能性を注記している。
- 利用開始日・価格・日本での提供は、今回確認した公式ページには書かれていない。
- 「オーガニックなデータで蒸留なし」「データの来歴が確か」は同社の説明で、データの中身は公開されていない。
突き合わせたMicrosoft AIの2ページ
- Frontier Pre-training at Microsoft AI — Microsoft AI(2026年10月15日付、日本時間10月16日1時18分に確認)
- Introducing MAI-Thinking-1 — Microsoft AI(日本時間10月16日1時18分に確認)
数字はすべて上記ページの記載による。本記事は続報があり次第更新します。
この記事でよく聞かれること
- MAI-Base-2とは何ですか?
- Microsoft AIが2026年10月15日(現地)に発表した基盤モデルです。総パラメータ2.8兆・アクティブ800億のMoE(Mixture of Experts)構成で、同社によると事前学習を完了し、現在はポストトレーニング中です。画像とテキストを最初から一緒に学習したと同社は説明しています。
- MAI-Base-2はもう使えますか?
- 今回確認した公式ページには、利用開始日や利用手順は書かれていません。同社は、ポストトレーニングの結果を近く共有するとしたうえで、重みをFoundry経由で信頼できる提携先にライセンスできるようになると説明しています。
- DeepSeek-V4-Pro-Baseより4.2〜12.3倍効率的とはどういう意味ですか?
- Microsoft AIが、4つの評価ごとに学習FLOPsとBPBの関係に法則を当てはめ、DeepSeek-V4-Pro-BaseのBPBに並ぶために自社の学習手法が必要とする計算量を推定し、DeepSeek-V4-Pro-Baseの学習計算量と比べた値です。実際に同じ条件で動かして測った倍率ではなく、同社の推定です。
- MAI-Base-2はどのくらいの規模で学習されましたか?
- 同社によると、2026年8〜9月の38日間、16,000基のGB200 GPUで学習しました。平均MFUは21%、goodput(学習が進んでいた時間の割合)は89%で、学習データの混合は50Tトークンです。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
Microsoftが「AIの作り方」を全公開 蒸留なしでAIME 97%のMAI-Thinking-1
Microsoftが「AIの作り方」を全公開蒸留なしでAIME 97%のMAI-Thinking-1
 動画
AIで思考力は落ちるのか MIT・Microsoft・Whartonの研究を一次資料で確認した
AIで思考力は落ちるのかMIT・Microsoft・Whartonの研究を一次資料で確認した
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開 8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
 動画
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表 総合点は7か月前のQwen3.5・Gemma 4に届かず
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表総合点は7か月前のQwen3.5・Gemma 4に届かず
 動画
Claude Opus 5.5は本当に最強か 第三者ベンチマーク2社で総合1位、研究課題で初の人間基準超え。ただしフォールバック込みの数字と、筆者が見た「暴れ馬」の癖
Claude Opus 5.5は本当に最強か第三者ベンチマーク2社で総合1位、研究課題で初の人間基準超え。ただしフォールバック込みの数字と、筆者が見た「暴れ馬」の癖
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
 動画
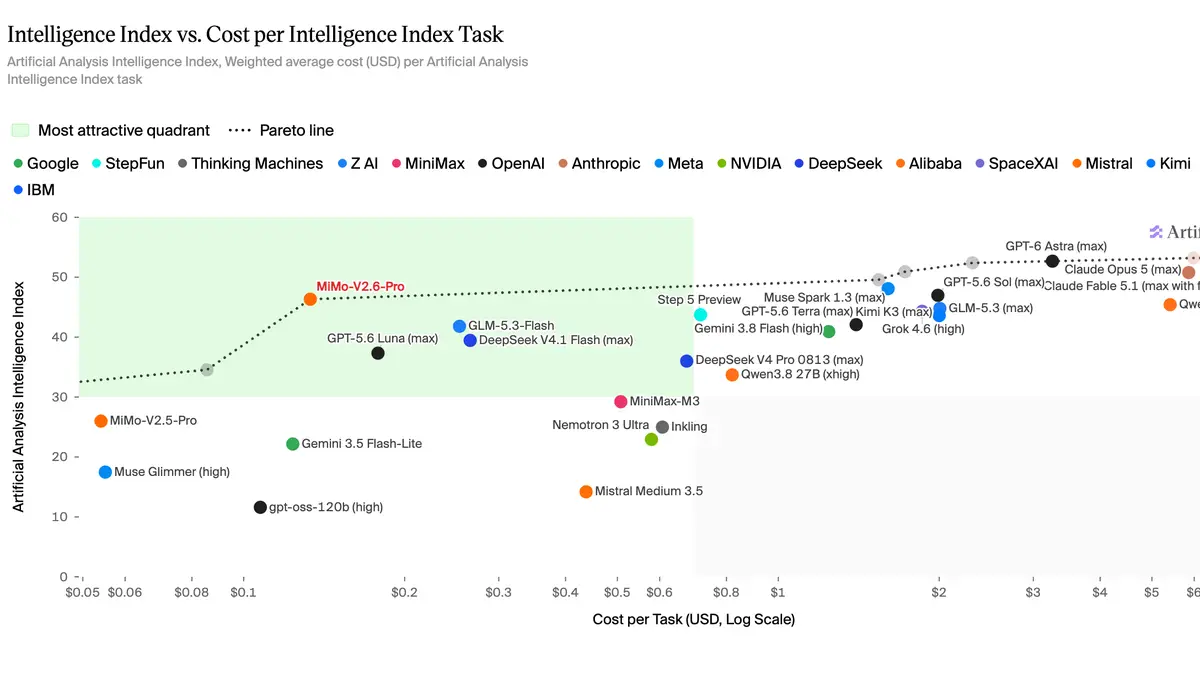
XiaomiがMiMo-V2.6を公開 1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
XiaomiがMiMo-V2.6を公開1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き
 動画