ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表総合点は7か月前のQwen3.5・Gemma 4に届かず
KDDI傘下のELYZAが2026年10月2日、国立情報学研究所の国産モデルllm-jp-4を土台にした推論モデル2つを無料公開し、「AIによるAI開発」を研究するELYZA RSI Researchを設立した。人の作業1〜2人日で学習から評価までを回したという。ただモデルカードの総合点は33bが61.7で、比べたQwen3.5 27Bの68.2、Gemma 4 31Bの70.5に届かず、日本語のテストだけの平均でも負けている。
目次
2026年10月2日(日本時間)時点の情報です。KDDI傘下のELYZAが10月2日、国立情報学研究所(NII)が日本でゼロから作ったモデル「llm-jp-4」を土台にした推論モデル2つを、Hugging Faceで無料公開した。同じ日に、AIが自分の能力や開発の進め方を繰り返し改善していく「再帰的自己改善(RSI)」を研究する組織「ELYZA RSI Research」の設立も発表している。当サイトはプレスリリースとモデルカードを原文で読み、表の数字を1つずつ突き合わせたうえで、解説動画「【速報】ELYZAが完全国産AIを公開。「AIがAIを作る」研究も始動──でも7か月前の海外モデルに届かず」にまとめた。この記事は、その数字を表ごとに並べたものだ。
3行まとめ
- ELYZAは「ELYZA-Thinking-1.0-llm-jp-4-33b」と「ELYZA-Thinking-1.0-llm-jp-4-32b-a3b」をApache 2.0で無料公開した。プレスリリースによると、人が関わる作業を1〜2人日に抑えて、中間学習から評価までを回した。
- モデルカードの総合点(20種のテストを7分野で平均)は33bが61.7で、比べたQwen3.5 27Bの68.2、Gemma 4 31Bの70.5に届かない。日本語のテストだけの平均でも62.2対66.1・68.9だった。
- ELYZA自身が「RSIそのものを実現したわけではございません」と書いている。比べた相手は2〜3月に出たモデルで、8月に出たQwen3.8はELYZAの表に入っていない。
| 項目 | 内容 |
|---|---|
| 発表 | ELYZA(KDDIグループ)・2026年10月2日 |
| モデル | ELYZA-Thinking-1.0-llm-jp-4-33b(330億パラメータ)/ELYZA-Thinking-1.0-llm-jp-4-32b-a3b(全体320億のうち1回に動くのは30億のMoE) |
| 土台 | llm-jp-4-33b-base/llm-jp-4-32b-a3b-base(NII 大規模言語モデル研究開発センター) |
| ライセンス | Apache 2.0(商用利用可) |
| 総合点 | 33b 61.7/32b-a3b 58.5(モデルカードの値を小数第1位に四捨五入) |
| 同じ日の発表 | 研究組織「ELYZA RSI Research」の設立、業務の評価用テスト「ELYZA Agent Tasks: Customer Service」の公開、音声対話AIエージェント「ELYZA Voice Agent」の開発 |
土台を海外のモデルから国産に替えた
ELYZAはこれまで、主なモデルを海外のモデルの上に作ってきた。Hugging Faceのelyzaのページに並ぶモデルを見ると、2023年はMetaのLlama 2、2024年はLlama 3、2025年はアリババのQwenを土台にしている。今回の2つは、NIIの大規模言語モデル研究開発センターが学習したllm-jp-4が土台だ。モデルカードの謝辞は、llm-jp-4を「developing the llm-jp-4 models from scratch in Japan」(日本でゼロから開発した)と紹介している。ITmedia AI+は、2つのモデルが「完全国産基盤」をうたっていると伝えた。
ただ、学習の材料には別のAIが関わっている。モデルカードによると、お手本の答えは「teacher model(教師モデル)」が作り、プログラムで正しいと確かめたものだけを残した。その教師モデルがどのモデルなのかは、モデルカードに書かれていない。
「人の作業1〜2人日」で何をしたのか
プレスリリースによると、ELYZAは「より少ない人的工数で効率的にモデルの学習や評価を行えるよう、社内のLLM学習基盤を整備しました」。この基盤をllm-jp-4に使い、「人間が介在する作業を1〜2人日程度に抑えながら、Mid-training、Post-trainingから評価までの一連のプロセスを実行し、モデルの性能向上を確認しました」としている。
モデルカードには、学習の中身が3段階で書かれている。
- 中間学習:数学・コード・理系の問題を日本語に訳し、解き方を新しく作り直して学ばせた。英語の元データも残した。道具を使う作業のデータも、関数名や引数、JSONはそのままにして日本語にした
- SFT(お手本で学ぶ段階):考える過程つきのお手本を数百万件。約半分が日本語。ふりがなや漢数字のような日本語ならではの条件を含む、守れたかを確かめられる指示も入れた。最新の日本語版WikipediaとWikidataから、日本の知識を学ぶためのデータも作った
- 強化学習(RLVR):数学・コード・日本語の知識・複雑な指示・道具の使い方を、1回の学習でまとめて鍛えた。報酬はプログラムで計算し、問題を解かずに点だけ取れる抜け道は、学習の前に見つけて塞いだとしている
モデルカードの表を読む
ELYZAは20種類のテストを7つの分野に分け、分野ごとの平均をさらに平均して総合点を出している。比べる相手と測り方はELYZAが選んだものだ。以下の数字は、モデルカードの値を小数第1位に四捨五入した。
330億クラス
| モデル | 総合 | 日本語のテストの平均 | 英語のテストの平均 |
|---|---|---|---|
| ELYZA 33b | 61.7 | 62.2 | 59.7 |
| llm-jp-4.1 33b(NIIの改良版) | 60.6 | 61.8 | 59.1 |
| Qwen3.5 27B | 68.2 | 66.1 | 71.8 |
| Gemma 4 31B | 70.5 | 68.9 | 73.1 |
MoEクラス
| モデル | 総合 | 日本語のテストの平均 | 英語のテストの平均 |
|---|---|---|---|
| ELYZA 32b-a3b | 58.5 | 59.6 | 55.9 |
| llm-jp-4.1 32b-a3b(NIIの改良版) | 53.9 | 56.7 | 49.7 |
| Qwen3.5 35B-A3B | 66.4 | 64.2 | 70.0 |
| Gemma 4 26B-A4B | 68.6 | 66.7 | 71.6 |
同じ土台をNIIが自分で仕上げた改良版のllm-jp-4.1と比べると、ELYZAは330億クラスで約1点、MoEクラスで約4.6点上だった。一方で、QwenとGemmaには総合でも日本語の平均でも届いていない。
差が大きいのは、コード・数学・道具の呼び出しだ。
| 項目(330億クラス) | ELYZA 33b | Qwen3.5 27B | Gemma 4 31B |
|---|---|---|---|
| コード(LiveCodeBench v6) | 60.2 | 80.1 | 79.4 |
| 数学(AIME 2024+2025) | 68.9 | 93.3 | 88.8 |
| 道具の呼び出し(BFCL v4) | 38.7 | 69.4 | 66.8 |
| 理系の難問(GPQA-Diamond) | 70.0 | 85.9 | 86.7 |
上回ったのは、日本語で知識を問うテストと、日本語の指示どおりに書くテストの2つだった。JFBenchの39.0は、表に並んだ7つのモデルの中で最も高い。
| 項目(330億クラス) | ELYZA 33b | Qwen3.5 27B | Gemma 4 31B |
|---|---|---|---|
| 日本語の知識(JEMHopQA) | 73.9 | 62.9 | 63.9 |
| 日本語の指示どおり(JFBench) | 39.0 | 34.1 | 35.7 |
比べた相手は7か月前のモデル
ELYZAが比べた相手は、どちらも今年の春先に出たモデルだ。当サイトはHugging Faceの記録で公開日を確かめた。
| モデル | Hugging Faceでの公開日 | 10月2日までの期間 |
|---|---|---|
| Qwen3.5 27B・35B-A3B | 2026年2月24日 | 約7か月 |
| Gemma 4 31B・26B-A4B(指示調整版) | 2026年3月11日 | 約7か月 |
| Qwen3.8 27B(ELYZAの表には無い) | 2026年8月5日 | 約2か月 |
Qwenは8月にQwen3.8を出しているが、ELYZAのモデルカード2本のどちらにもQwen3.8は出てこない。Hugging Faceの記録を見る限り、GoogleのGemmaは今もGemma 4が最新だが、公開から7か月がたっている。しかも比べている相手は、300億前後の大きさで重みが無料で配られているオープンウェイトのモデルだ。各社が一番強いモデルとして出しているのは、重みを配っていないGeminiのようなモデルのほうになる。
RSI研究で出した、ほかの成果
ELYZA RSI Researchは、プレスリリースで「AIによるAI開発」の進み方を4つの段階に分けて説明している。
| 段階 | プレスリリースの説明 |
|---|---|
| 1 | 主に人がモデル開発、ハーネス改善、評価機構の設計を担う |
| 2 | AIが提示した改善案を人が都度判断する |
| 3 | 個々の開発・改善をAIに委ね、その成果を人が評価する |
| 4 | 人が目的と制約を設定し、その範囲内でAIが自律的に開発・改善のサイクルを回し続ける |
ELYZAが今どの段階にいるかは、当サイトが読んだプレスリリースの全文には書かれていない。書かれているのは「現時点ではRSIに至る前段階の要素技術の研究であり、RSIそのものを実現したわけではございません」という一文だ。
モデルのほかに、成果は2つある。
- 業務の評価用テストの半自動作成:日本語のコールセンターの問い合わせ対応を題材にした「ELYZA Agent Tasks: Customer Service」を作り、GitHubで公開した。音声とテキストの両方に対応し、手順の選び方・手順どおりの進め方・道具の使い方・最後の結果を段階ごとに評価できる
- ハーネスの自動改善:AIエージェントの動きや道具の使い方を制御する仕組み(ハーネス)を、ELYZAの自律改善エージェントに直させた。開発系の2つのテストで成功率が14.4ポイントと27.2ポイント上がった。問い合わせ対応では、改善に使っていないテスト用のデータでも、やり切れた割合が34.3%から52.9%に上がった。精度とコストの両方を目標にすると、精度をほぼ保ったまま推論の費用を67%減らせたとしている
この研究の最初の商品として、電話やアプリで話しながら予約変更や申請の受け付けまで進める「ELYZA Voice Agent」も作った。現在は、実際の現場への導入に向けて検証している段階だ。
なお、RSIを掲げた研究組織は国内でELYZAが初めてではない。2026年6月には、Sakana AIがRSI Labの設立を発表している。
最前線の会社はどこにいるのか
比べる材料として、OpenAIが9月6日に公開した社内の数字がある(当サイトの記事)。
- 2025年秋に掲げた「2026年9月までに自動研究インターン」の目標に、到達したと書いた。人の指示のもとで、熟練の研究者なら数日かかる研究の作業をこなせる状態を指す
- 8月中旬には、研究者の人間1労働日あたり、エージェントが3.1労働日分働いていた
- エージェントを使う研究者のうち中央値の人が、1日600ドルを超える推論を使っていた(API価格に換算)
研究者が使っているのは、世の中に出ているモデルだけではない。OpenAIは数字の数え方の説明で「Internal or pre-deployment models are mapped to the price of their nearest production counterpart」(社内のモデルや公開前のモデルは、一番近い製品版の価格に置き換えた)と書いている。8月26日の事件の報告では、社内専用の研究モデルを「Internal Model 1(IM1)」と呼んでいる。
同じ9月6日、OpenAIの主席科学者ヤクブ・パホツキは次のように書いた。
"Based on internal results, I have a strong expectation that this speed of progress could be sustained into recursive self-improvement."
(社内の結果にもとづいて、この進歩の速さは再帰的自己改善まで続きうると強く予想している。)
ここからは考察:巻き返しは無理でも、自国でAIを持つ意味
ここからは当サイトの考察だ。
まず、今回のELYZAの取り組みはRSIではない。ELYZA自身がそう書いているうえ、性能を見ても、自分で自分を改良し続ける仕組みが回っているなら、7か月前の30B級のオープンウェイトのモデルに総合で負けたままにはならないはずだ。
次に、この研究を続けても最前線への巻き返しは無理だと当サイトは考える。理由は2つある。1つは使える頭脳の差で、ELYZAが使えるのはどれだけ良くても公開済みのモデルまでだが、最前線の会社は社内のもっと強いモデルで次のAIを作っている。もう1つはRSIの仕組みそのもので、AIがAI作りを速くするなら、先に回し始めた側ほど速くなり、後から始めた側との差は縮まらずに開いていく。
それでも、自分の国でAIを持つ意味はある。追いつくためではなく、止められた日に自分たちで回せるようにするためだ。
- 止められない:アメリカでは国防総省が自国の会社のAIであるClaudeを締め出し、2026年9月25日には控訴裁判所がその判断を2対1で支持した(当サイトの記事)。自国の会社でもこうなる以上、他国のAIがある日使えなくなることはありうる
- 中身が分かる:何を学習したかを確かめ、自分たちで直せるAIでないと使えない場面がある
- 作る力が国内に残る:作るのをやめれば、作れる人も仕組みも国内から消える。ELYZAが1〜2人日でモデルを回す仕組みを作ったことは、性能で負けていても、この力を国内に持ったという意味がある
当サイトが確かめたこと
当サイトは、モデルカード2本の表を機械で読み取り、動画と記事に使った数字を原文と1つずつ突き合わせた。比べた相手の公開日は、Hugging Faceの記録から確かめた。Qwen3.8が比較に入っていないことは、モデルカード2本の全文を検索して確かめた。いずれも2026年10月2日に行った。
モデルカードの注記によると、道具の呼び出しのテスト(BFCL v4・Nejumi BFCL)は、ELYZAのモデルが使う会話の形式(harmony)が複数の道具を同時に呼ぶ問題に対応していないため、全モデルでその問題を除いて測っている。llm-jp-4・llm-jp-4.1とgpt-oss-20bは考える量の設定を「high」にし、ELYZAのモデルとそれ以外のモデルは考える機能をオンにして測った。
この記事で確かめられなかったこと
- お手本の答えを作った教師モデルが、どのモデルか
- 自律研究エージェントやハーネス改善のエージェントが、内部でどのモデルを使っているか
- 「1〜2人日」の内訳と、AIがどこまでを担ったか(10月2日夜の時点で、当サイトが確認したELYZAのZennとnoteには、このモデルの技術記事はまだ出ていない)
- ELYZAが4つの段階のどこにいるか
- ELYZA Voice Agent の提供開始の時期
本記事は、ELYZAの技術資料などの続報があり次第更新します。
出典・参照資料
- 一次資料ELYZA「『AIによるAI開発』の研究を推進する『ELYZA RSI Research』を設立」(2026-10-02) ↗
- 一次資料ELYZA「音声対話AIエージェント『ELYZA Voice Agent』を開発」(2026-10-02) ↗
- 一次資料Hugging Face「elyza/ELYZA-Thinking-1.0-llm-jp-4-33b」モデルカード ↗
- 一次資料Hugging Face「elyza/ELYZA-Thinking-1.0-llm-jp-4-32b-a3b」モデルカード ↗
- 一次資料GitHub「ELYZA Agent Tasks: Customer Service」 ↗
- 一次資料Hugging Face「Qwen/Qwen3.5-27B」 ↗
- 一次資料Hugging Face「google/gemma-4-31B-it」 ↗
- 一次資料Hugging Face「Qwen/Qwen3.8-27B」 ↗
- 一次資料OpenAI「Research acceleration: The view inside OpenAI」(2026-09-06) ↗
- 一次資料Jakub Pachocki「An Alien Mind」(OpenAI・2026-09-06) ↗
- 一次資料OpenAI「The Hugging Face incident and the road ahead」(2026-08-26) ↗
- 二次資料ITmedia AI+「『完全国産』AI、KDDI傘下のELYZAが無料公開『LLM-jp-4』ベースに性能強化」(2026-10-02) ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Sakana AIが「RSI Lab」設立 AIがAI自身を改良する専門研究組織
Sakana AIが「RSI Lab」設立AIがAI自身を改良する専門研究組織
 動画
OpenAI、「自動研究インターンに到達」と宣言 研究者1人にエージェント3.1労働日、中央値の研究者が1日600ドル、成功の過半数には人の介入。社内実測の全数字と、同じ日に主席科学者が書いた「減速」
OpenAI、「自動研究インターンに到達」と宣言研究者1人にエージェント3.1労働日、中央値の研究者が1日600ドル、成功の過半数には人の介入。社内実測の全数字と、同じ日に主席科学者が書いた「減速」
 動画
AIが自分自身を作り始めた Anthropicの「When AI Builds Itself」を、誇張なしで読む
AIが自分自身を作り始めたAnthropicの「When AI Builds Itself」を、誇張なしで読む
 動画
米控訴裁、国防総省によるClaudeの締め出しを2対1で容認 判決文で読む「問われるのは何をするかで、なぜではない」
米控訴裁、国防総省によるClaudeの締め出しを2対1で容認判決文で読む「問われるのは何をするかで、なぜではない」
JTLスコアとは 英語ベンチマークでは見えない日本語実務性能を自前で実測する方法論
JTLスコアとは英語ベンチマークでは見えない日本語実務性能を自前で実測する方法論
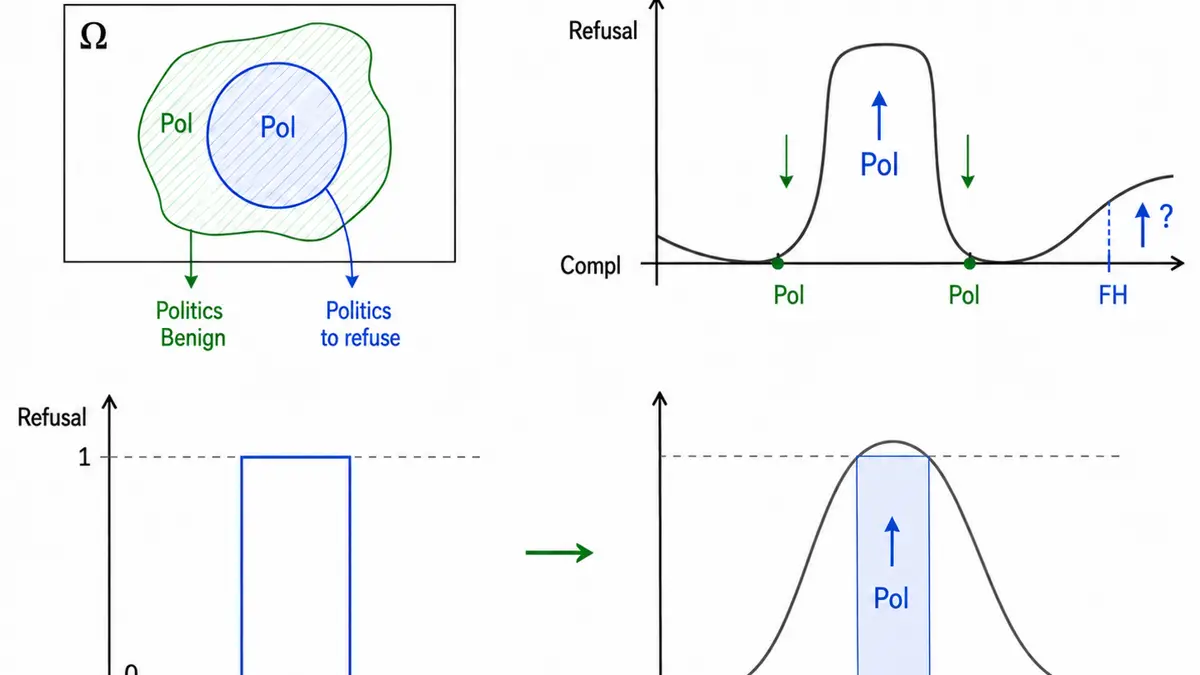
「Safety for Whom?」 安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
「Safety for Whom?」安全化の学習で有害応答率を26.26%から0.14%に下げた同じチェックポイントが、無害な質問の74%を拒否していた。Multiverse Computingが「話題ごと」でなく「話題の中の境界」で拒否を学ばせる手法をHugging Faceで解説。境界ペアで過剰拒否32.94%→4.16%
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)
Qwen4とは──9月22日の雲栖大会で「Qwen4 Series Coming Soon」として Qwen4-Max/Flash & Plus/27B の3枠が出た。公式プレスリリースは「訓練中」「4.5・5は5〜10兆パラメータ」まで。「人間ゼロ介入で33回の自己改善」の主張と、Artificial Analysisで実測した現行Maxの位置(45・首位53)