Microsoft AI、診断AI「MAI-DxO(マイ・ディーエックスオー)」の評価をScienceに発表NEJMの難症例で正答率83%、医師は22%と36%(同社測定)
日刊AIニュース10月22日(木)号:前日のAIのニュース26本を短くまとめました(約13分)›
Microsoft AIは2026年10月22日、診断AI「MAI-DxO」の研究をScienceに発表した。NEJMの難症例304件で正答率83%(医師は22%と36%)、救急の典型例で80%対47%と同社は説明。診断ベンチマークSDBenchは一部の症例を公開した。
目次
Microsoft AIは2026年10月22日(米国時間)、診断AIシステム「MAI-DxO(マイ・ディーエックスオー)」の研究成果を科学誌Scienceに発表したと公式ブログで明らかにした。同社の測定では、医学誌NEJMの難症例でMAI-DxOの正答率は83%、医師は22%(参考資料なし)と36%(あり)。あわせて、診断ベンチマーク「SDBench(エスディーベンチ)」を一部のNEJM症例についてオープンソースで公開した。ブログの公開時刻は日本時間10月23日午前3時ごろにあたる。
3行まとめ
- Microsoft AIが10月22日、MAI-DxOの研究をScienceに発表。NEJM難症例で正答率83%、医師は22%と36%と同社は報告
- 救急の典型例(MIMIC-IV-ED)では80%対47%。SDBenchは一部のNEJM症例を公開し、Mayo Clinicとの協業、Beth Israel Deaconessでの前向き研究も発表
- 数字はすべて同社のベンチマーク上のもの。患者を対象にした試験はこれから
本記事の内容は、日本時間10月23日3時台に公式ページで確認したものです。
何が発表されたのか
Microsoft AIの「MAI Health Team」による公式ブログ「Building Medical Superintelligence」(10月22日付)が、Scienceに論文が出たと説明している。論文が紹介する土台は2つで、診断の過程を段階的に試すベンチマークSDBenchと、そのベンチマークで同社が最も良い結果を出したとするシステムMAI-DxO(Microsoft AI Diagnostic Orchestrator)だ。
SDBenchは、米国の医師免許試験(USMLE)のように情報が最初から全部出て、選択肢から1つを選ぶ形式とは違う。AIや医師は限られた情報から始めて、何を尋ね、どの検査を頼むかを自分で選ぶ。測るのは診断の正確さ、要求した証拠、推定した検査費用の3つで、答えだけでなくそこまでの道筋も見る、と同社は書いている。症例は2種類ある。
| 症例の種類 | 内容(同社の説明) |
|---|---|
| NEJM | NEJMの症例記録から取った複雑な304症例 |
| MIMIC-IV-ED | 米国の救急部門で見られる、より典型的な症例 |
MAI-DxOは、1つのモデルに即答させる作りではない。同社は「仮想の医師の合議体」のように動くと説明している。それぞれが診断案を出し、有用な質問や検査を選び、出てきた見立てに異論をぶつける。この議論を数ラウンド続け、証拠が届くたびに評価を更新し、各検査の見込める価値を費用と照らす。
数字は何と何の比較か
ブログが挙げる結果は次の5点だ(いずれも同社の記述)。
| 条件 | MAI-DxO | 比較対象 |
|---|---|---|
| NEJMの複雑な症例 | 正答率83% | 医師22%(外部の参考資料なし)、36%(あり) |
| MIMIC-IV-EDの典型的な救急症例 | 80% | 医師47% |
| NEJMでコストを重視して調整した構成 | 81%(比較システムの半分未満の費用) | ― |
| 両データセット全体 | MAI-DxOより正確で、しかも費用が低い人間・AI手法は他になかったと同社 | ― |
| 新しいモデル(GPT-5.5を含む)で再評価 | 精度は維持・向上と同社 | 構成方法は変えず |
同社は倍率でも書いている。NEJMでは医師の約3.7倍と約2.3倍、救急の典型例では1.7倍超だ。ブログの冒頭では、費用も「半分、場合によっては3分の1」で済むとしている。
ここで押さえておきたいのは、比べているのが「SDBenchという形式のなかでの」成績だという点だ。ブログは、医師が参考資料なしと資料ありの2条件で診断した、と書いている。医師の人数や経験年数、症例ごとの結果は、今回取得したブログ本文には出てこない。論文本体はScience側のページが取得時にHTTP 403で、中身を読めなかった。詳細は論文で確かめる必要がある。
2025年6月の初出と何が変わったか
同じ研究は、2025年6月30日のブログ「The Path to Medical Superintelligence」で一度プレプリントとして紹介されている。当時の記述と今回の記述を並べると次のようになる。
| 項目 | 2025年6月30日のブログ | 2026年10月22日のブログ |
|---|---|---|
| 論文の状態 | プレプリント、外部の査読に提出中 | Scienceに掲載と発表 |
| NEJMの正答率 | 最良の構成(OpenAIのo3との組み合わせ)で85.5% | 83% |
| 比較した医師 | 米英の現役医師21人、平均20% | 22%(資料なし)と36%(あり) |
| 救急の典型例 | 追加の検証が必要と記載 | MIMIC-IV-EDで80%対47% |
| SDBench | 公開ベンチマークとしては未提供 | 一部のNEJM症例をオープンソース化 |
2025年版は、より一般的な症例での性能は「さらに検証が必要」と書き、医師には同僚・教科書・生成AIを使わせずに比較したとも明記していた。今回の版には救急の典型例の結果が加わっている。ただし、85.5%と83%、20%と22%の差がなぜ生じたのかは、今回取得した2つのブログには書かれていない。評価の設定が同じかどうかも、ここからは判断できない。
SDBenchは誰でも動かせるのか
公式ページ(microsoft.github.io/sdbench)によると、評価は3つの役割のやり取りで進む。
- 診断エージェント: 評価される側。診断を明かさない短い症例の要約から始め、検査の依頼、質問、診断の確定を選ぶ
- ゲートキーパー: 依頼や質問に、症例の全文から答える。症例に結果があればそれを返し、無ければ「現実的な合成結果」を返す
- ジャッジ: 診断が確定したら、正解と照らして1〜5の5段階で採点する。4〜5を正解とみなす
データセットの入手条件は一様ではない。
| データ | 入手条件(SDBenchのページ) |
|---|---|
| NEJM | NEJMからのライセンスが必要 |
| MIMIC | PhysioNetの資格認定、研修、データ利用同意が必要 |
| 合成症例 | NEJM風の完全な合成症例5件をリポジトリに同梱。開発用で、診断性能の報告には使わない |
ブログによると、公開するのは一部のNEJM症例向けのSDBenchで、ベンチマーク本体、ゲートキーパー、ジャッジ、費用見積もりのコードを含む。SDBenchのページを見る限り、症例データそのものが誰でも手に入るわけではない。試すだけなら、ページの手順で git clone のあと OpenRouter のキーを設定し、同梱の合成データで基準エージェントを動かせる。既定のモデルはGPT-5と書かれている。
研究の先:Mayo Clinicとの協業と、病院での試験
ブログは診断を「ケアの一部」と位置づけ、治療の選択や経過の理解まで含めた構想を述べている。BMJ Digital Health and AIの論文「The Building Blocks of Medical Superintelligence」を同じ週に出したとも書いている。Microsoft Researchの公開ページには「Medical Superintelligence: Foundations and Aspirations」という題の論文要旨があり、医療の知能を6つの次元で整理し、孤立した課題での超人的な成績だけでは足りず、治療の全体にわたる統合的な推論が必要だと論じている。BMJの論文と同一かどうかは、今回取得したページからは確認できない。
実環境の検証については、次の2点が書かれている。
- Mayo Clinic: 最先端のAI、臨床の専門知識、長期的なマルチモーダルデータを組み合わせたシステムを作ることを目指して協業している
- Beth Israel Deaconess Medical Center(ボストン): 新たな提携のもと、病院の複数の現場で臨床推論の能力を評価する。前向き研究で患者がシステムと直接やり取りし、医師の独立した評価と比べる。うまくいく点と届かない点、忙しい現場への収まり方を見る、と同社は説明している
あわせて、Microsoft各所のヘルス関連チーム(Microsoft Researchの研究者や、Dragon Copilot・PowerScribeといった製品のチームなど)をMicrosoft AIでの一体の取り組みにまとめる、とも発表している。同社のMAI関連の別発表はMAI-Base-2の事前学習完了の記事にまとめてある。
4ページは読めたが、Scienceの論文は読めなかった
日本時間10月23日3時18分ごろ、ブログ本体とSDBenchのページ、Microsoft Researchのページ、2025年のブログを順に取得した。取得したブログとSDBenchのページは英語で、ページ内に日本語版への案内は見当たらなかった。Science掲載ページは同じ時刻に403が返り、本文を読めなかったため、論文の数値は一切確認していない。この記事の数字は、すべてMicrosoft AIのブログとSDBenchのページに書かれたものだ。筆者はMAI-DxOもSDBenchも動かしていない。
読むときに分けておきたいこと
- ベンチマーク上の成績: 83%や80%は、SDBenchの形式にした症例記録での結果だ。実際の患者を診た結果ではない。患者を対象にした評価は、Beth Israel Deaconessでの前向き研究がこれから行う段階だとブログは述べている
- 比較対象の条件: 医師の22%と36%は、資料の有無で分けた2つの値だ。医師の人数などの条件は今回のブログに書かれていない
- ゲートキーパーの合成結果: 症例に検査結果が無い場合は合成した結果が返る仕組みだ。この設計が成績にどう影響するかは、今回の資料では評価できない
- 提供の有無: 今回確認した公式ページには、MAI-DxOの製品提供や日本での利用の記載は見当たらなかった。2025年のブログは、研究デモであり臨床使用の承認を受けていないと説明していた。今回のブログにはこの承認に関する新しい記載はない
- 日本の読者への影響: 日本の医療機関での扱いについては、確認した範囲では記載がない
出典と確認時刻
確認時刻はいずれも日本時間2026年10月23日の3時台。
- Building Medical Superintelligence — Microsoft AI(10月22日付、取得3:18)
- SDBench — Sequential Diagnosis Benchmark(取得3:18)
- Medical Superintelligence: Foundations and Aspirations — Microsoft Research(取得3:18)
- The Path to Medical Superintelligence — Microsoft AI(2025年6月30日付、取得3:18)
- Science掲載ページ(doi: 10.1126/science.aeh7930)は取得時にHTTP 403で、本文は未確認
本記事は続報があり次第更新します。
この記事でよく聞かれること
- MAI-DxO(マイ・ディーエックスオー)とは何ですか?
- Microsoft AIが作った診断AIシステムです。1つのモデルに即答させるのではなく、複数の仮想の医師が診断案を出し、検査や質問を選び、互いに反論する議論を何ラウンドか重ねます。検査の費用対効果も見積もりながら診断を更新する、と同社は説明しています。
- MAI-DxOの正答率は医師より高いのですか?
- Microsoft AIの発表では、NEJMの複雑な症例でMAI-DxOは83%、医師は参考資料なしで22%、ありで36%でした。MIMIC-IV-EDの救急の典型例では80%対47%です。いずれも同社のベンチマークSDBenchでの測定で、実際の診療での結果ではありません。
- SDBench(エスディーベンチ)は誰でも使えますか?
- Microsoftは一部のNEJM症例を対象にSDBenchをオープンソースで公開したと発表しました。ただしSDBenchのページによると、NEJMのデータセットはNEJMからライセンスを受ける必要があり、MIMICはPhysioNetの資格認定が必要です。リポジトリには開発用の合成症例5件が入っており、ページの手順ではOpenRouterのキーを設定して動かします。
- MAI-DxOは病院や患者がすぐ使えますか?
- 今回確認した公式ページには、MAI-DxOの一般提供や利用方法の記載はありません。Microsoft AIは、Beth Israel Deaconess Medical Centerとの提携で、患者がシステムと直接やり取りする前向き研究を行う予定だと説明しています。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Google×HHMI Janeliaがオスのショウジョウバエの脳と中枢神経系の完全な配線図を公開 16万6,000超のニューロン・1億2,500万のシナプス結合で「ニューロン数で史上最大の脳地図」。AIが電子顕微鏡画像を3D再構成し、人が校正。メスの地図と比べて求愛・攻撃の回路を調べられる。次は魚の脳全体
Google×HHMI Janeliaがオスのショウジョウバエの脳と中枢神経系の完全な配線図を公開16万6,000超のニューロン・1億2,500万のシナプス結合で「ニューロン数で史上最大の脳地図」。AIが電子顕微鏡画像を3D再構成し、人が校正。メスの地図と比べて求愛・攻撃の回路を調べられる。次は魚の脳全体
 動画
Microsoftが「AIの作り方」を全公開 蒸留なしでAIME 97%のMAI-Thinking-1
Microsoftが「AIの作り方」を全公開蒸留なしでAIME 97%のMAI-Thinking-1
Microsoft AI、総パラメータ2.8兆のMoE基盤モデル「MAI-Base-2(マイ・ベース・ツー)」の事前学習を完了 DeepSeek-V4-Pro-Baseより4.2〜12.3倍計算効率が高いと主張
Microsoft AI、総パラメータ2.8兆のMoE基盤モデル「MAI-Base-2(マイ・ベース・ツー)」の事前学習を完了DeepSeek-V4-Pro-Baseより4.2〜12.3倍計算効率が高いと主張
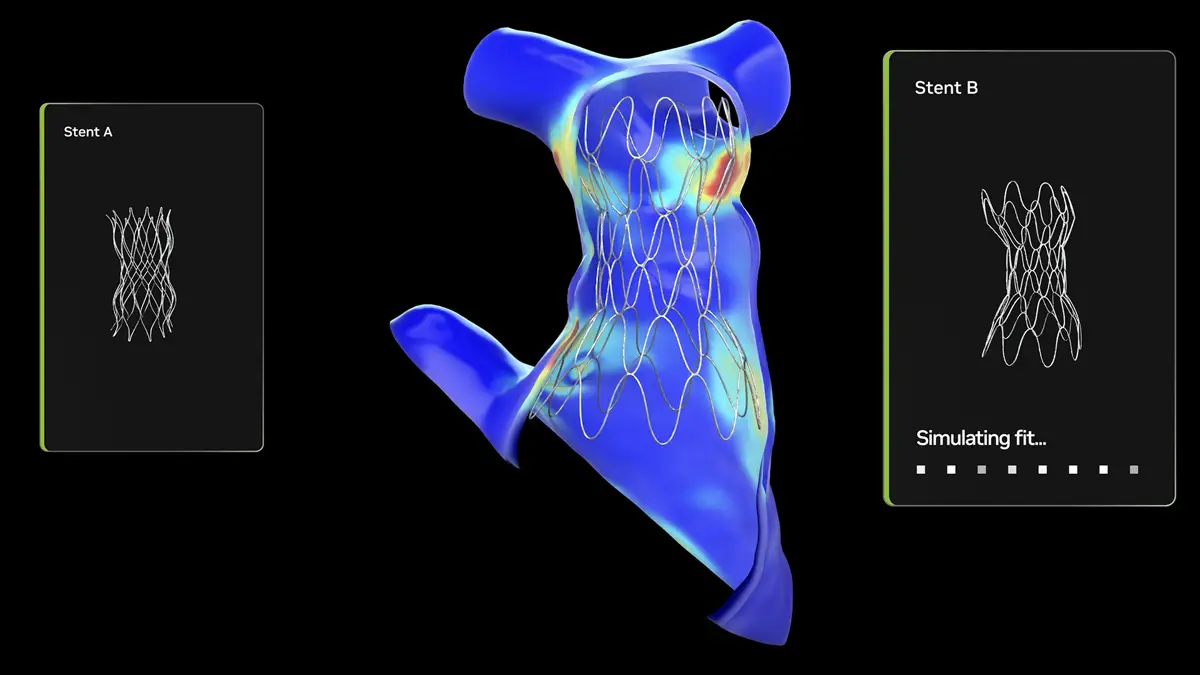
フィラデルフィア小児病院、オープンソースのNVIDIA AIで子どもの心臓を数秒でモデル化 MONAI Label+Auto3DSegで、熟練研究者が4時間かけていたCT・MRI・3D超音波からの心臓模型作りを数秒に。米国20超の小児病院が心臓モデリング、ボストン小児は年約500例。NewtonとWarpで機器を入れた時の挙動を最大4時間→ほぼリアルタイムに
フィラデルフィア小児病院、オープンソースのNVIDIA AIで子どもの心臓を数秒でモデル化MONAI Label+Auto3DSegで、熟練研究者が4時間かけていたCT・MRI・3D超音波からの心臓模型作りを数秒に。米国20超の小児病院が心臓モデリング、ボストン小児は年約500例。NewtonとWarpで機器を入れた時の挙動を最大4時間→ほぼリアルタイムに
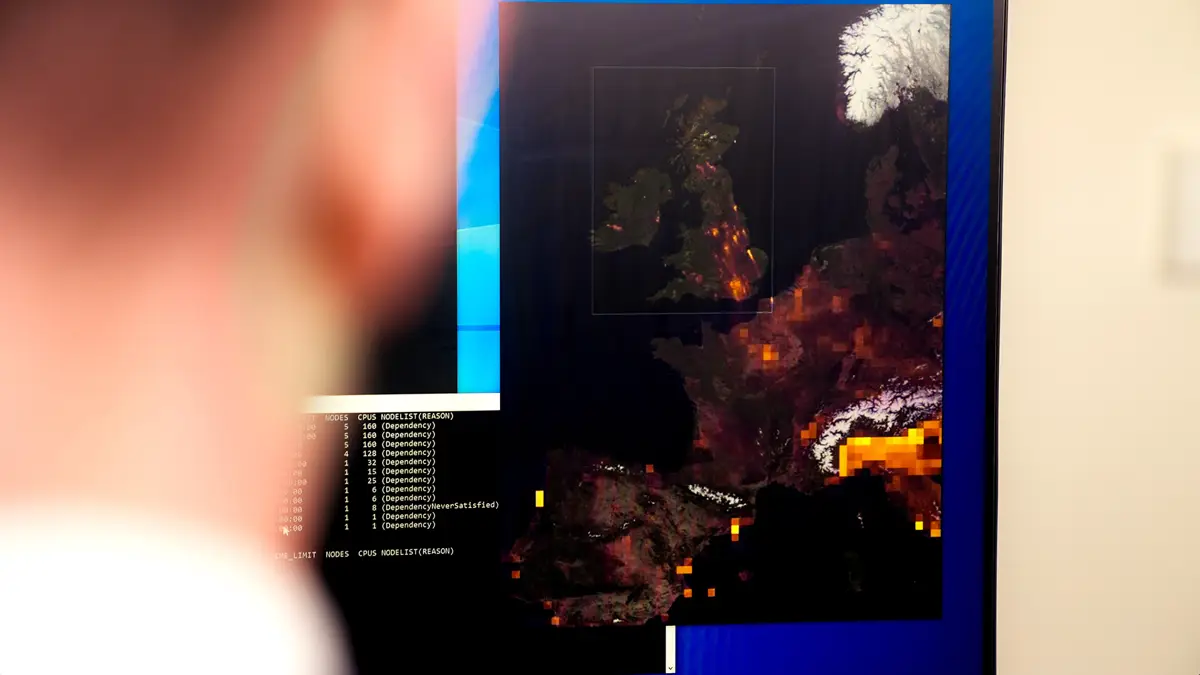
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル 天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
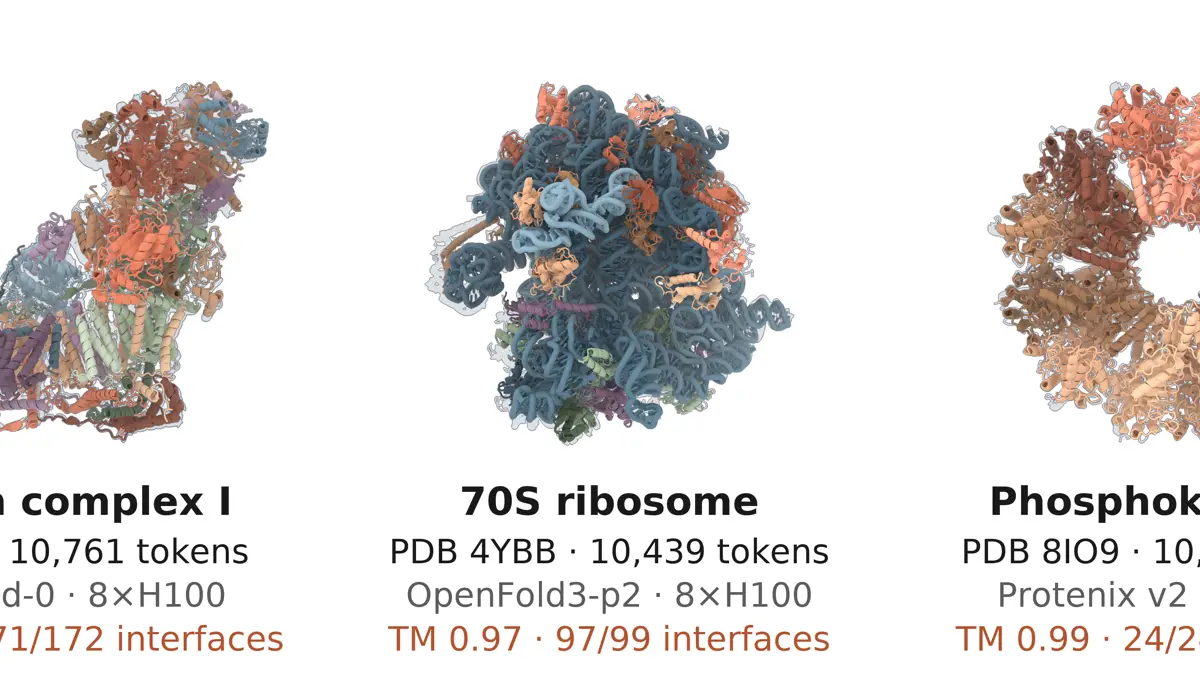
Anthropic、Claudeがオープンソースの生体分子モデル30超を4週間弱で平均約4倍高速化 三角注意のカーネル「FlashPairformer」は既存標準比2.7〜2.9倍、「Big」モードで1万トークン超のリボソーム等を1ノードで予測。結合タンパク質の設計はH200 1枚・約150ドルで前回(GPU時間100分の1)と同等。Adaptyv Bioと設計コンペ、クレジット最大100万ドル
Anthropic、Claudeがオープンソースの生体分子モデル30超を4週間弱で平均約4倍高速化三角注意のカーネル「FlashPairformer」は既存標準比2.7〜2.9倍、「Big」モードで1万トークン超のリボソーム等を1ノードで予測。結合タンパク質の設計はH200 1枚・約150ドルで前回(GPU時間100分の1)と同等。Adaptyv Bioと設計コンペ、クレジット最大100万ドル
Ai2、LLMの公平性を「説得されたときの変わりやすさ」で測るFairStress(フェアストレス)を公開 300場面・1,300万件超、データとコードも配布
Ai2、LLMの公平性を「説得されたときの変わりやすさ」で測るFairStress(フェアストレス)を公開300場面・1,300万件超、データとコードも配布