NVIDIAとCisco(シスコ)、1レーン400Gb/sの光モジュール規格「USFP」を発表OSFPサイズで12.8Tb/s、200Gb/sレーン品比で帯域密度4倍・電力効率約1.3倍をうたう計画段階の新規格
NVIDIAとCiscoは2026年10月12日(米国時間)、1レーン400Gb/sの光モジュール規格USFPを計画として発表した。OSFPサイズで12.8Tb/s、200Gb/sレーン品に対し帯域密度4倍・電力効率約1.3倍と両社は説明する。TE ConnectivityとAmphenolが部品づくりに参加する。
目次
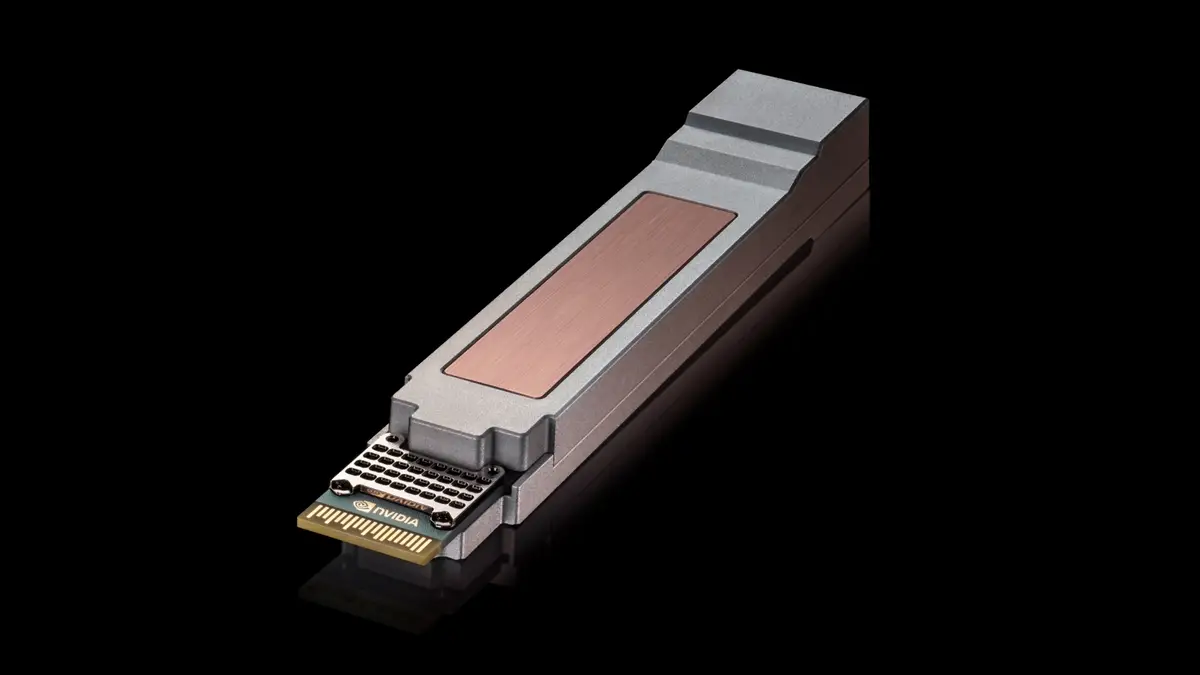
NVIDIAとCisco(シスコ)は、2026年10月12日(米国時間)、1レーンあたり400Gb/sの電気信号に対応する光モジュール規格「Ultra-Dense Small Form Factor Pluggable(USFP)」を計画として発表した。NVIDIAの公式ニュースルームによると、最初に計画されている製品はOSFPサイズの筐体に16本の双方向レーンを詰める設計で、USFPで全体12.8Tb/sの容量を実現できるとしている。TE ConnectivityとAmphenolが、対応するケージ・コネクタ・モジュールづくりに加わる。
3行まとめ
- NVIDIAとCiscoが2026年10月12日(米国時間)、1レーン400Gb/sの光モジュール規格USFPを発表。OSFPサイズで12.8Tb/sの容量をうたう。
- 両社の説明では、200Gb/sレーンの差し込み式モジュールに対し帯域・前面パネルの帯域密度が4倍、電力効率が約1.3倍。
- 発表は「計画」の段階。今回確認したNVIDIAの発表ページには、出荷時期も価格も書かれていない。
本記事の内容は、日本時間10月13日0時台に公式ページで確認したものです。
USFPは何をするための部品なのか
USFPは、データセンターのスイッチやネットワークカードの前面に差し込む「光トランシーバー」(電気信号と光信号を変換する小型モジュール)の新しい形状と仕様である。NVIDIAの発表は、これを「次世代のAI工場向け」と位置づけている。AI工場とは、同社がAI向けの計算設備を指して使う言い方だ。
発表がまず挙げる課題はこうだ。AIモデルが大きくなり推論の需要が増えると、AI工場はより多くの計算機をつなぐ必要がある。スイッチが容量の上限に達すると、ネットワークを広げるために層やリンクを足すことになり、発表によれば遅延・消費電力・コストが増える。USFPは、1本あたりの帯域と1台のスイッチにつなげる本数の両方を増やして、この層の追加を避けるためのものだと説明されている。
数字で見るUSFP
NVIDIAの発表に書かれた主な数字は次のとおり。いずれも両社の設計目標・説明であり、第三者の測定ではない。
| 項目 | 発表の内容 |
|---|---|
| 1レーンの電気信号 | 400Gb/s(USFPは400Gb/s対応の最初のモジュールになるよう設計されたとNVIDIAは書く) |
| 最初の計画製品のレーン数 | 16本の双方向(full-duplex)レーン。OSFPサイズの筐体 |
| 将来のレーン数 | 32本以上へ拡張可能(コネクタ技術で対応) |
| 全体の容量 | 12.8Tb/s |
| 比較対象 | 200Gb/sレーンの差し込み式モジュール |
| 帯域・前面パネルの帯域密度 | 4倍 |
| 電力効率 | 約1.3倍 |
| 放熱 | 最大100ワットまで、モジュール内に専用の冷却回路を持たずに対応 |
発表は、レーン数と1レーンあたりの帯域をどちらも2倍にすることで、1.6Tb/sの端点をより多くつなげられると説明している。また、400Gb/s向けのコネクタなので、200Gb/sレーンで使う場合の性能も改善するとしている。
どんな仕組みで実現するのか
NVIDIAの発表によると、USFPは新しい二次元配列のコネクタを使う。モジュールを差し込んだあとで高速の接点がかみ合う「二段階挿入」の設計で、接点の摩耗を減らし、信号品質を高め、挿入に必要な力を予測しやすくするという。
もうひとつは放熱だ。USFPは最大100ワットの熱を、モジュール内の専用の埋め込み冷却回路なしで扱えるとされる。発表は、これによりスイッチの設計が単純になり、信頼性が上がると説明している。光学方式については、信号処理を簡素にして遅延と消費電力を減らす設計に、全構成が対応するとしている。対応する光技術や接続距離の幅は広いと書かれているが、具体的な距離は今回の発表ページに載っていない。
誰が作るのか──TE ConnectivityとAmphenol、そして業界仕様
発表によると、NVIDIAとCiscoはTE ConnectivityおよびAmphenolと組んで、USFPのケージ、コネクタ、モジュールを作る。今後ほかの協力企業が加わる見込みとも書かれている。共通の形状を持つことで、供給側が400Gb/sレーン向けの高密度な差し込み式機器を作るための土台になる、というのが両社の説明だ。
さらに、両社はコミュニティ主導のマルチソースプロジェクトを通じて、USFPのオープンな業界仕様をつくる計画だとしている。この文はあくまで「計画(plan)」であり、プロジェクトがすでに発足したとは書かれていない。Ciscoの将来予測に関する注意書きも、USFPのマルチソース合意(MSA)の設立とその期待される効果を、予測の対象として挙げている。
今回の取り組みは、NVIDIAのSpectrum-X Ethernetと、Cisco Silicon One搭載のEthernetネットワークをつなぎ合わせてきた既存の協力関係の上にある、と発表は書く。企業・ネオクラウド・ソブリンクラウド向けのAIインフラ導入を簡単にするのが狙いだという。
引用された両社幹部の言葉
NVIDIAのGilad Shainer(シニアバイスプレジデント)は、発表の中で次のように述べたと記されている。
“Building the world’s largest AI factories starts with rethinking the smallest of connections,” (世界最大のAI工場づくりは、最も小さな接続を考え直すことから始まる)
CiscoのBill Gartner(光システム・光学部門のシニアバイスプレジデント兼ゼネラルマネージャー)は、400Gb/sレーンへの拡張は「今のモジュール設計の延長では足りない」という認識を両社が共有したと述べ、USFPは差し込み式光モジュールの保守性・展開の柔軟性・運用の簡単さを保ちながら新しい帯域密度を狙うものだと説明している。いずれも発表資料に載った当事者の発言であり、評価は両社の主張として読む必要がある。
日本の読者にとっての関係
USFPは、AIを使う個人が直接触る製品ではない。データセンターの事業者や機器メーカーが対象の部品規格だ。日本での提供や、国内の事業者への展開については、今回確認したNVIDIAの発表ページに記載がなかった。このため、日本の企業が近い時期に使えるのかどうかは、この発表からは判断できない。
AIのサービスが重い、遅いといった話とも直接はつながらない。ただ、発表が掲げる論点(スイッチの層を増やさずに計算機をつなぐ、ネットワークが占める電力の割合を下げる)は、発表自身が「ネットワークが電力に占める割合を下げる」ことを利点に挙げているとおり、AI向けデータセンターの電力という論点につながっている。本サイトでも、国内の「ワット・ビット連携」の実証を扱った記事(/news/ntt-anode-energy-watt-bit-renkei-ai-power)がある。
筆者が公式ページで確認できたこと
日本時間10月13日0時9分にNVIDIAのニュースルームのページを取得した時点で、発表の日付は2026年10月12日と表示されていた。本文はニュースサマリー、本文、将来予測に関する注意書きで構成され、価格表や出荷日、対応する具体的な製品名の一覧は見当たらなかった。本文中を「price」「availab」「ship」「2027」などの語で検索すると、「price」「2027」は0件。「available」「ship」は将来予測の注意書きの「currently available」や会社紹介の「partnership relationship」といった別の文脈でだけ出てきて、価格や出荷時期を示す記述ではなかった。なお、同じ日に取得したCiscoのニュースルームのページ(2026年8月25日付の別の発表)は、USFPには触れておらず、Supermicroとの提携によるCisco Secure AI Factory with NVIDIAの拡張(Supermicro製計算機の提供は2026年10月開始とCiscoは書く)を扱っていた。USFPとは別件で、両社が同じネットワーク構成の周辺で協力を続けていることを示す背景として読める。
今回の発表から分からないこと
- 提供時期と価格: 今回確認したNVIDIAの発表ページには、最初の製品がいつ出荷されるのか、いくらなのかの記載がない。発表の文面は「計画」「設計されている」が中心である。
- 性能の根拠: 4倍・約1.3倍・12.8Tb/sは、両社の設計上の説明として書かれている。測定条件や第三者の検証は、このページには載っていない。「4倍」は帯域と前面パネルの帯域密度の比較で、比較対象は200Gb/sレーンの差し込み式モジュールである。電力効率の約1.3倍も同じ比較対象だ。
- 業界仕様の進み具合: マルチソースプロジェクトは「これから(upcoming)」と書かれており、発足や参加企業は今回のページでは確認できない。
- 対応する製品: 対応する具体的なスイッチやSuperNICの製品名は、今回確認したページには書かれていなかった。
出典と確認時刻
- NVIDIA Newsroom「NVIDIA and Cisco Introduce New Pluggable Optics Form Factor to Scale AI Factories」(2026年10月12日付): https://nvidianews.nvidia.com/news/nvidia-and-cisco-introduce-new-pluggable-optics-form-factor-to-scale-ai-factories (日本時間2026年10月13日0時9分に確認)
- Cisco Newsroom「Cisco Expands Secure AI Factory with NVIDIA for the Rack-Scale Era」(2026年8月25日付・背景としてのみ参照): https://newsroom.cisco.com/c/r/newsroom/en/us/a/y2026/m08/cisco-secure-ai-factory-nvidia-rack-scale.html (日本時間2026年10月13日0時9分に確認)
本記事は続報があり次第更新します。
この記事でよく聞かれること
- USFPとは何ですか?
- NVIDIAとCisco(シスコ)が2026年10月12日(米国時間)に計画として発表した、Ultra-Dense Small Form Factor Pluggableの略称の光モジュール規格です。1レーンあたり400Gb/sの電気信号に対応する高密度のモジュールで、AI工場(AI向けデータセンター)のネットワーク向けです。
- USFPで何がどのくらい良くなるのですか?
- 両社の発表によると、OSFPサイズのモジュールで200Gb/sレーンの差し込み式モジュールと比べ、帯域と前面パネルあたりの帯域密度が4倍、電力効率が約1.3倍です。最初に計画されている製品は16本の双方向レーンを持つ設計で、USFPで全体12.8Tb/sの容量を実現できるとしています。
- いつから買えますか?価格は?
- 今回確認したNVIDIAの発表ページには、提供開始時期も価格も書かれていません。発表の表現は「計画(plans)」で、最初の製品は「計画されているもの」と書かれています。
- USFPはNVIDIAとCisco以外も作れますか?
- 発表によると、TE ConnectivityとAmphenolとともにUSFP用のケージ、コネクタ、モジュールを作っており、ほかの協力企業の参加も見込んでいます。両社はコミュニティ主導のマルチソースプロジェクトを通じて、オープンな業界仕様をつくる計画とも書いています。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
NVIDIA、Vera Rubin(ベラ・ルービン)のラック設計をOCPに提供 MGX 1.2は最大250kW、MetaはSpectrum-6の102.4Tb/sスイッチを採用
NVIDIA、Vera Rubin(ベラ・ルービン)のラック設計をOCPに提供MGX 1.2は最大250kW、MetaはSpectrum-6の102.4Tb/sスイッチを採用
NVIDIA GTC Washington, D.C. 2026は11月30日開幕 基調講演は12月1日Jensen Huang氏、AWS re:Inventと4日間重複しAWS自身がダイヤモンドスポンサーに
NVIDIA GTC Washington, D.C. 2026は11月30日開幕基調講演は12月1日Jensen Huang氏、AWS re:Inventと4日間重複しAWS自身がダイヤモンドスポンサーに
AWS re:Invent 2026 11/30-12/4開催、セッション2,200超。Emeraldスポンサーに今年はAnthropic・OpenAI
AWS re:Invent 202611/30-12/4開催、セッション2,200超。Emeraldスポンサーに今年はAnthropic・OpenAI
ヒューマノイドロボット(人型ロボット)とは 2026年10月の主な機体と価格、日本の動き、家庭で買えるかを各社の公式資料で整理
ヒューマノイドロボット(人型ロボット)とは2026年10月の主な機体と価格、日本の動き、家庭で買えるかを各社の公式資料で整理
Emerald AI・Google・NVIDIAが「AI Energy Management Alliance(AEMA)」を設立 AIデータセンターを「電力を柔軟に減らせる資源」として電力網につなぐ。負荷の移動・蓄電・併設発電で系統の逼迫に応じ、接続前にライドスルー・抑制・緊急応答の義務を定め、検証可能な柔軟性を約束した事業者には速い接続経路を
Emerald AI・Google・NVIDIAが「AI Energy Management Alliance(AEMA)」を設立AIデータセンターを「電力を柔軟に減らせる資源」として電力網につなぐ。負荷の移動・蓄電・併設発電で系統の逼迫に応じ、接続前にライドスルー・抑制・緊急応答の義務を定め、検証可能な柔軟性を約束した事業者には速い接続経路を
NVIDIAの次世代ラック「Vera Rubin NVL72」がMLPerf Inference v6.1に初登場 Qwen3-VLでGB300 NVL72の最大3.7倍、DeepSeek-R1で最大2.5倍(プレビュー提出)。GB300は4ラック288GPUで99%のスケーリング効率、ソフトウェア改善だけでv6.0比最大1.6倍。エージェント向け指標では30倍という自社測定も
NVIDIAの次世代ラック「Vera Rubin NVL72」がMLPerf Inference v6.1に初登場Qwen3-VLでGB300 NVL72の最大3.7倍、DeepSeek-R1で最大2.5倍(プレビュー提出)。GB300は4ラック288GPUで99%のスケーリング効率、ソフトウェア改善だけでv6.0比最大1.6倍。エージェント向け指標では30倍という自社測定も
NVIDIAが「商用規模で走る主要ロボタクシーはすべて自社スタックの上」と書いた 訓練(DGX+Alpamayo)・シミュレーション(Omniverse/Cosmos)・車載(Hyperion=Thor×2、カメラ14・レーダー9・ライダー3)の3台構成。日本はTIER IV・いすゞのレベル4バス、日産×Wayve×Uber。Uberは2028年に28都市
NVIDIAが「商用規模で走る主要ロボタクシーはすべて自社スタックの上」と書いた訓練(DGX+Alpamayo)・シミュレーション(Omniverse/Cosmos)・車載(Hyperion=Thor×2、カメラ14・レーダー9・ライダー3)の3台構成。日本はTIER IV・いすゞのレベル4バス、日産×Wayve×Uber。Uberは2028年に28都市