Maia 300(マイア)とNVIDIA Rubin(ルービン)を公表値で比べる計算は約4割、でも計算1あたりの運ぶ力は約2.4倍
Microsoftが2026年10月12日に発表した推論特化のAIチップ「Maia 300」を、公式の技術解説から立体図で分解し、NVIDIAのGPU「Rubin」と各社の公表値で並べた。4ビットの計算はRubinが約2.5倍、メモリの量と運ぶ速さはほぼ同じ。計算1あたりに使える運ぶ力はMaia 300が約2.4倍で、一番速い網で1つにできる数は最大1万2288基と72基。
目次
Microsoftが2026年10月12日に発表した、AIの推論に特化した自社チップ「Maia 300(マイア 300)」を、公式の技術解説をもとに立体図で分解し、NVIDIAのいちばん新しいGPU「Rubin(ルービン)」と各社の公表値で並べた。結論を先に書くと、メモリの量と運ぶ速さはほぼ同じで、4ビットの計算はRubinが約2.5倍ある。Maia 300は計算を厚くする代わりに、計算1あたりに使える運ぶ力(約2.4倍)と、一番速い網でつなげる数(最大1万2288基)に力を入れている。分解と比べの流れは、上の動画でそのまま見られる。発表そのものの概要は自動速報の記事にまとめてある。
3行まとめ
- Maia 300はHBM4を8つ載せて288GB・18TB/秒、4ビットの計算は13.8ペタ、電力は950W。Microsoftは推論のためだけに設計したと書いている。
- NVIDIA Rubinと公表値で比べると、メモリの量と運ぶ速さはほぼ同じ、4ビットの計算はRubinが約2.5倍。計算1あたりに使える運ぶ力はMaia 300が約2.4倍。
- 一番速い網で1つにできる数は、Maia 300が最大128ラック・1万2288基、Rubinが72基。比べた数字は各社の公表値で、測り方の条件はそろっていない。
本記事の数字は、2026年10月13日(日本時間)時点の各社の公式ページで確認したものです。
Microsoftは何に向けて作ったのか
Azureの技術解説は、Maiaは最初から大規模言語モデルの推論のためにシステム全体を最適化してきた、と書いている。その理由として、Microsoftの公式ブログはこう説明する。
Moving data efficiently, rather than raw compute power, is increasingly the bottleneck in large inference systems.
(大規模な推論システムでは、計算の力そのものより、データを効率よく運ぶことが詰まる所になりつつある)
発表の日、CEOのSatya NadellaはXに「Today we are announcing our biggest bet yet on our own silicon.」(自社のチップへの、これまでで一番大きな賭けを発表する)と投稿した。Maia 300は2027年から本番の展開に入り、Microsoftの製品とサービスの推論の主力にする計画だ。
チップの中身──計算は1枚、運ぶ係とつなぐ係を分けた
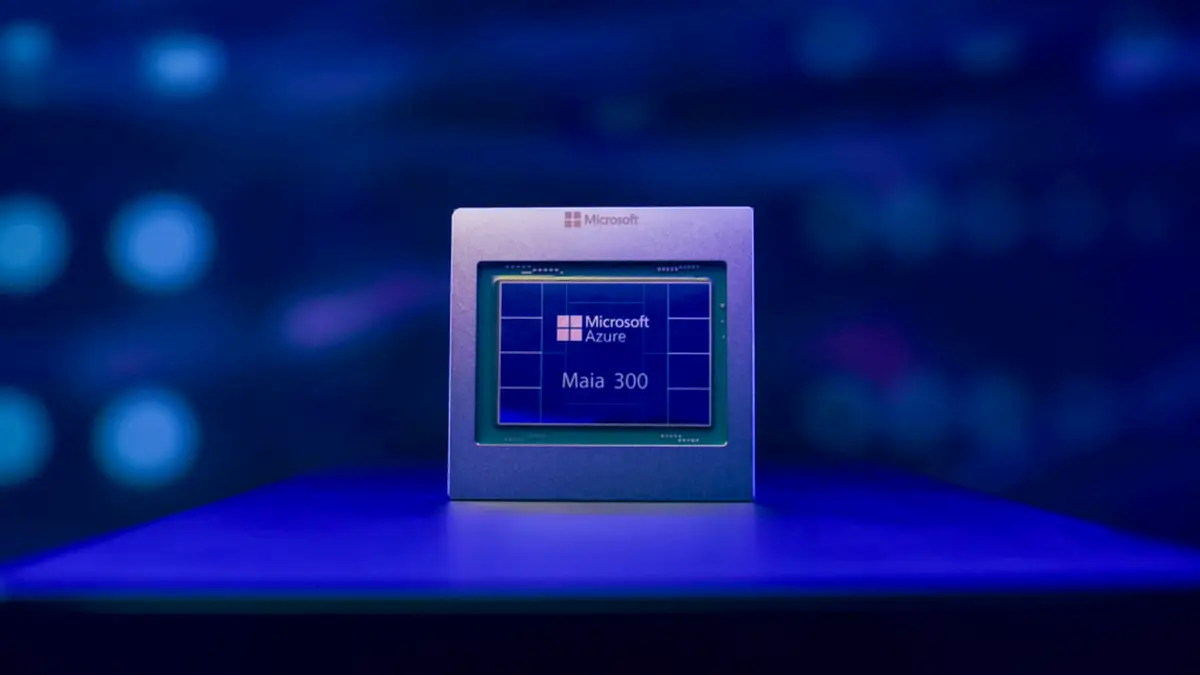
公式ブログの図と技術解説によると、Maia 300のパッケージは次の部品でできている。
| 部品 | 数 | 役目(公式の説明から) |
|---|---|---|
| 計算のチップ | 1 | 掛け算と足し算。TSMCのN2P(2ナノ世代)で作る |
| IOのチップ | 2 | 外の機械とデータをやり取りする |
| メモリのチップ | 4 | HBMとの出し入れを受け持つ |
| HBM4 | 8 | モデルの数字を置くメモリ。合計288GB・18TB/秒 |
N2Pで作るのは計算のチップで、メモリの制御とIOは、運ぶ速さ・つなぎやすさ・費用に合わせた別のチップに分けたと技術解説は書いている。チップの中には小さく速いメモリ(SRAM)を置き、よく使うデータを手元に置いてHBMへ取りに行く回数を減らす。メモリは均一な置き方(UMA)から、計算の近くに置く形(NUMA)に変わり、技術解説は「データが動く距離が短くなり、運ぶのに使う電力が減る」と説明している。
前の世代のMaia 200(2026年1月発表)と比べると、計算は36%増、HBMの運ぶ速さは2.5倍(7TB/秒→18TB/秒)。計算より運ぶ方を大きく伸ばした。
数字を粗くして、運ぶ量そのものを減らす
技術解説によると、Maia 300は4ビットの改良形式(強化版MXFP4)と、3ビット未満の保存形式を入れた。16ビットの数字を4ビットにすれば、同じ数の数字を運ぶ量は4分の1になる。公式ブログは、会話の途中の記憶(KVキャッシュ)を置く量と運ぶ量も減ると書いている。
一方、粗くしたことで答えの質がどれだけ変わるかの数字は、本記事が確認した公式の2ページには載っていなかった。
1万2288基を、1台のように動かす網
Azureの技術解説によると、つなぎ方は次の段になっている。
- 1枚のトレイに4基。トレイの中は2基ずつが直接つながる
- トレイ24枚で1ラック96基(167kW)。ラックの中の96基は、スイッチを1回通ればどれとでもつながる
- 2段目のスイッチで最大128ラックをつなぎ、1万2288基の「スーパーポッド」にする
There are three latency domains: A direct connected accelerator pair is the lowest latency domain, then accelerators within a pod are one switch hop away, and any accelerator across pods is three switch hops away.
(遅れの段は3つある。直接つながった2基が一番短く、ラックの中はスイッチ1回、ラックをまたぐ相手はスイッチ3回)
この網の上で、推論の「入力を読む係(prefill)」と「答えを書き出す係(decode)」を、それぞれ必要な数と場所に分けて置ける。読み終わった時点の記憶(KVキャッシュ)は、同じ網の中で書き出す係へ直接渡す。どこかのトレイが壊れても、別のラックの予備のトレイに切り替えて動き続けられる。ラックの熱の8割以上は液体で冷やす。
NVIDIA Rubinと公表値で並べる
比べる相手は、NVIDIAで今いちばん新しいGPUのRubin(Vera Rubin NVL72の1基)。NVIDIAには推論専用のチップ(Groqの技術を使ったLPX)もあるが、ここでは同社の軸になっている、学習も推論もこなすGPUと比べる。
| 項目 | Maia 300 | NVIDIA Rubin |
|---|---|---|
| メモリの量(HBM) | 288GB | 288GB |
| メモリの運ぶ速さ | 18TB/秒 | 19.2TB/秒 |
| 4ビットの計算 | 13.8ペタ | 35ペタ(計算を省く工夫を使わない値) |
| 電力 | 950W | 製品ページに記載なし(NVIDIAの比較の前提は1,800W) |
| 1ワットあたりの計算 | 約14.5テラ | 約19.4テラ(1,800Wで計算) |
| 計算1ペタあたりの運ぶ速さ | 約1.30TB/秒 | 約0.55TB/秒 |
| 1バイト届くあいだの計算 | 約770回 | 約1,820回 |
| 一番速い網で1つにできる数 | 最大1万2288基 | 72基 |
下の4行は、上の公表値から筆者が計算した。読み方は次のとおり。
- 計算はRubinが厚い。 4ビットの計算はRubinが約2.5倍、1ワットあたりでもRubinが約1.3倍多い
- 運ぶ速さはほぼ同じなので、計算1あたりではMaia 300が厚い。 計算1ペタあたりに使える運ぶ速さはMaia 300が約2.4倍。言いかえると、1バイト届くあいだにRubinは約1,820回計算するが、Maia 300は約770回で、計算が待たされにくい
- つなぐ数は桁が違う。 Rubinを一番速い網(NVLink 6・1基あたり3TB/秒)で1つにできるのは72基。NVIDIAも、もう1段遅い別の網(1基あたり0.45TB/秒)を足せばさらに増やせる
Microsoftは、こうした作りによって「主要なGPU系のシステムと比べ、メガワットあたり40%多くのトークンを出す見込み」と公式ブログに書いた。
By improving efficiency across the system, we expect Maia 300 to deliver 40% more tokens per megawatt compared to leading GPU-based systems.
(システム全体の効率を上げることで、Maia 300は主要なGPU系のシステムより、メガワットあたり40%多くのトークンを出すと見込んでいる)
ただし、比べた相手の機種や条件は書かれていない。前の世代のMaia 200については、TeamsやCopilotに組み込んだAIの機能で、主要なGPUの基盤より1ワットあたり最大1.7倍のトークンを出していると、同じブログが書いている。こちらも比べたGPUの名前は無い。
推論特化はMicrosoftだけではない
推論に向けた自社のチップは、ほかの大手も出している。
- Google:2026年4月に第8世代のTPUを発表し、学習用の「8t」と推論用の「8i」に分けた
- Meta:自社チップMTIAについて、主流のチップは事前学習に合わせて作られ推論に流用されるが、自分たちは推論を先に考える、と書いている
- OpenAI:2026年6月に初めての自社チップ(推論専用)を発表した。TechCrunchによると、初期の展開は2026年末が目標
- NVIDIA:Groqの技術を使った推論専用のチップ(Groq 3 LPX)が8月に量産に入った。ただし軸はRubin
NVIDIAのJensen Huang CEOは、8月26日の決算説明会でこう話している。
many of these XPUs are inference-specific chips for one cloud or one service, NVIDIA is a platform, an entire AI factory platform that spans the entire AI life cycle that you can use in any cloud.
(こうした専用チップの多くは、1つのクラウドや1つのサービス向けの推論専用だ。NVIDIAはどのクラウドでも使える、AIの全体をこなすプラットフォームだ)
MicrosoftはNVIDIAのGPUを大量に買う客でもある。それでもNVIDIAは年次報告書(2026年2月提出)で、Microsoftを競合の1社に挙げている。一方、Microsoftでクラウド+AIを率いるScott Guthrieは、発表の日のTae Kimによるインタビューで「we're big partners of NVIDIA and AMD, and we'll continue to be big partners of them.」(NVIDIAやAMDとは大きなパートナーで、これからもそうだ)と話し、「in the same way that we're multi model, we are multi silicon」(モデルと同じで、チップも1つに絞らない)とも述べた。
立体図を作っていて見つかった、筆者の勘違いと数字の変更
動画では、チップと網の作りを、Claude Codeのスキル「Anatomy」で立体図にして見せた(Anatomyそのものは実演の記事を参照)。作る途中で、筆者の思い込みが2つ見つかった。
1つ目は網の図。筆者は図を頼む文に「トレイの中の4基はすべて直接つながる」と書いたが、図を作ったClaude Codeは、Maia 300の資料の原文(「Direct links connect two accelerators in a tray」)を挙げて、4基すべてが直結なのは前の世代のMaia 200で、Maia 300は2基ずつだと返してきた。図は資料どおり2基ずつの2組で作り直している。
2つ目はRubinの数字。比べの表を作るために10月12〜13日にNVIDIAの製品ページを読んだところ、Rubinのメモリの運ぶ速さは19.2TB/秒だった。同じページは、Web Archiveに残る9月1日の記録では22TB/秒で、9月中に改められている(ページの最終更新は10月9日で、Maia 300の発表の3日前)。NVIDIAは理由を書いていない。本記事と動画は、改めた後の19.2TB/秒で計算している。22TB/秒のままなら、計算1あたりの運ぶ力の差は約2.4倍ではなく約2.1倍になる。
まだ分からないこと
- 本番の性能:Maia 300の本番の展開は2027年から。外の機関が測った数字はまだ無い
- 数ギガワットに届く時期:Guthrieは同じインタビューで「I don't know the exact time frame for when we'll get to multi gigawatt.」(数ギガワットにいつ届くか、正確な時期は分からない)と話している
- 数字の条件:Maia 300の13.8ペタが、計算を省く工夫を使った値か使わない値かは公表されていない。Rubinの35ペタは使わない値(使う値は50ペタ)
- 40%の相手:比べたGPUの機種と条件は書かれていない
Microsoftは、来月のMicrosoft Ignite 2026(サンフランシスコ)でさらに詳しく話すとしている。続報が出たら、この記事に追記する。
数字の出どころと計算のしかた
- Maia 300の仕様:Microsoft公式ブログ・Azureの技術解説(2026/10/12)。13.8ペタは公式ブログの仕様の図の「FP4 POPS」
- Rubinの仕様:NVIDIA Vera Rubin NVL72の製品ページ(最終更新 2026/10/9)。1,800WはNVIDIAのデータシートの注記(Vera Rubin NVL4の比較の前提)
- 計算した値:1ワットあたりの計算=4ビットの計算÷電力。計算1ペタあたりの運ぶ速さ=運ぶ速さ÷4ビットの計算。1バイト届くあいだの計算=4ビットの計算÷運ぶ速さ。Rubinの電力は公表値ではないので、1ワットあたりの値は仮の値
- AIチップの売上でNVIDIAが占める割合は、調査会社や報道の推計で約7〜8割台と幅がある(動画で触れた数字。本記事の比べには使っていない)
この記事でよく聞かれること
- Maia 300とNVIDIA Rubinは何が違いますか?
- 各社の公表値では、メモリの量(288GB)と運ぶ速さ(18TB/秒と19.2TB/秒)はほぼ同じで、4ビットの計算はRubinが約2.5倍(13.8ペタと35ペタ)です。そのかわり、計算1あたりに使えるメモリの運ぶ力はMaia 300が約2.4倍、一番速い網で1つにできる数はMaia 300が最大1万2288基、Rubinが72基です。測り方の条件はそろっていません。
- Maia 300はいつから使われますか?
- Microsoftの公式ブログによると、Maia 300は2027年に本番の展開を始めます。前の世代のMaia 200は、すでにMicrosoft Copilotなどの本番で動いています。
- 「GPUより40%多くのトークン」の比べた相手は?
- Microsoftの公式ブログは「主要なGPU系のシステムと比べて、メガワットあたり40%多くのトークンを出す見込み」と書いていますが、相手の機種や測り方の条件は、本記事が確認した公式の2ページには書かれていませんでした。
- Rubinの電力はどれくらいですか?
- NVIDIAの製品ページにRubin 1基の電力の値は載っていません。本記事では、NVIDIAのデータシートの注記で比較の前提に使われている1基1,800Wを仮に使っています。Maia 300は950Wと公表されています。
出典・参照資料
- 一次資料Microsoft to expand Azure Maia system to multi-gigawatt deployments — Microsoft公式ブログ(2026/10/12) ↗
- 一次資料Deep dive into Azure Maia 300 architecture — Microsoft Azure公式ブログ(2026/10/12) ↗
- 一次資料Maia 200: The AI accelerator built for inference — Microsoft公式ブログ(2026/1/26) ↗
- 一次資料NVIDIA Vera Rubin NVL72 製品ページ ↗
- 一次資料Satya NadellaのX投稿(2026/10/12) ↗
- 二次資料An interview with Microsoft's Scott Guthrie — Tae Kim(2026/10/12) ↗
- 一次資料NVIDIA 2027年度第2四半期 決算発表(2026/8/26) ↗
- 一次資料NVIDIA Groq 3 LPX の量産開始(2026/8/24) ↗
- 一次資料Google 第8世代 TPU(2026/4) ↗
- 一次資料Expanding Meta's custom silicon to power our AI workloads — Meta(2026/3) ↗
- 二次資料OpenAI unveils its first custom chip built by Broadcom — TechCrunch(2026/6/24) ↗
- 一次資料AI時短ラボの解説動画(2026年10月13日) ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Microsoft、自社AIチップAzure Maia(マイア)を2027年からマルチギガワット規模に拡大 Maia 200は稼働中、Maia 300は2027年に量産展開、同社は「GPU比で電力あたり40%多くトークンを出せる見込み」
Microsoft、自社AIチップAzure Maia(マイア)を2027年からマルチギガワット規模に拡大Maia 200は稼働中、Maia 300は2027年に量産展開、同社は「GPU比で電力あたり40%多くトークンを出せる見込み」
GPU(ジーピーユー)とは 画面を描くために生まれ、いまはAIの計算も担うチップ。CPUとの違い、AIでGPUが使われる理由、NPUとの違い【2026年10月版】
GPU(ジーピーユー)とは画面を描くために生まれ、いまはAIの計算も担うチップ。CPUとの違い、AIでGPUが使われる理由、NPUとの違い【2026年10月版】
 動画
Claude Codeの新スキル「Anatomy(アナトミー)」を実演 文章で頼むと、触って動かせる仕組みの図が出てくる
Claude Codeの新スキル「Anatomy(アナトミー)」を実演文章で頼むと、触って動かせる仕組みの図が出てくる
AIチップ 業界地図 NVIDIA/AMD/Intel/Apple/独自チップ【2026年】
AIチップ 業界地図NVIDIA/AMD/Intel/Apple/独自チップ【2026年】
AnthropicがMicrosoft独自チップ「Maia 200」でのClaude推論を協議中 Azure初の外部顧客候補に
AnthropicがMicrosoft独自チップ「Maia 200」でのClaude推論を協議中Azure初の外部顧客候補に
量子コンピューター(量子コンピュータ)とは 量子ビットで計算する新しい方式のコンピューター、AIとはまだ別の技術。Google Willow・IBM・NVIDIAの2026年10月時点の現在地【2026年10月版】
量子コンピューター(量子コンピュータ)とは量子ビットで計算する新しい方式のコンピューター、AIとはまだ別の技術。Google Willow・IBM・NVIDIAの2026年10月時点の現在地【2026年10月版】
NVIDIAとCisco(シスコ)、1レーン400Gb/sの光モジュール規格「USFP」を発表 OSFPサイズで12.8Tb/s、200Gb/sレーン品比で帯域密度4倍・電力効率約1.3倍をうたう計画段階の新規格
NVIDIAとCisco(シスコ)、1レーン400Gb/sの光モジュール規格「USFP」を発表OSFPサイズで12.8Tb/s、200Gb/sレーン品比で帯域密度4倍・電力効率約1.3倍をうたう計画段階の新規格