AWS、Amazon BedrockのGrok 4.7(グロック)でエージェントを作る手順と実測を公開72回中67回正解、xhighは18回すべて正解、lowは出力トークン約8分の1
AWSは2026年10月13日(米太平洋時間)、SpaceXAIのGrok 4.7をAmazon Bedrockで使うエージェントの作り方を公式ブログで公開した。推論の強さ4段階で72回実行し67回正解、xhighは18回すべて正解、lowは出力トークンが約8分の1だった。
目次
AWSは2026年10月13日(米国太平洋時間・日本時間では10月14日0時台)、SpaceXAIの Grok 4.7(グロック 4.7)を Amazon Bedrock で使ってエージェントを作る手順と実測結果を、公式の機械学習ブログに公開しました。推論の強さ(reasoning effort)を low・medium・high・xhigh の4段階に変え、3種類のタスクを各6回、合計72回実行した結果、67回が正解でした。xhigh は18回すべて正解、low は15/18で出力トークンは xhigh の約8分の1だった、とAWSは書いています。
3行まとめ
- AWSが2026年10月13日、Amazon Bedrock上の Grok 4.7 でエージェントを作る手順を公開。呼び出しは
us.xai.grok-4.7(米国内)かglobal.xai.grok-4.7の推論プロファイルで、文脈は500Kトークン。- AWSの実測は72回中67回正解。xhigh は18/18、low は15/18で出力トークンは約8分の1(1,184対9,147トークン)。
- 実験は合成環境・各6回・中央値18〜106秒で、AWS自身が「統計的に確定したものではない」と限界を書いている。日本からの利用可否は今回の記事に記載なし。
本記事の内容は、日本時間10月14日0時台に公式ページで確認したものです。
何が公開されたのか
AWSの記事は、製品の発表というより「使い方と測り方」の解説です。9月28日にAWSが別記事「Grok 4.7 is now available on Amazon Bedrock」で提供開始を伝えており、今回の10月13日の記事はその続編にあたります。Grok 4.7 自体は、x.aiの発表ページの日付が2026年9月21日です。
AWSは、次の3つのタスクを用意しました。いずれも「答えを調べて読み取る」のではなく「候補を立てて確かめる」必要があるもので、総当たりで正解がちょうど1つになることを確かめてあるといいます。
| タスク | エージェントがやること | 難しさの理由(AWSの説明) |
|---|---|---|
| two_fault_diagnosis | 03:00に静かに止まった2サービスを、12サービスのアラートから特定する | 止まったサービス自身はアラートを出さない。190通りの組み合わせのうち、観測と完全に合うのは1つ |
| maintenance_schedule | 8サービスを4晩・1晩2つで、10個の制約と「同じチームは同じ夜にしない」規則の下でパッチ当てする | 2,520通りのうち有効な日程は1つ。チームの規則は調べないと分からない |
| migration_budget | 予算内でリスク低減が最大になる移行の組を選ぶ | 実行可能な組は53通りで最適は1つ。比率の良い順に選ぶと最適より9ポイント低い |
環境は20サービスと7つのツールの合成データで、最終行 FINAL: だけを採点する方式です。システムプロンプトは短く、「答える前にすべての規則に照らして確認する」ことを求めています。
結果──xhighは18回すべて正解、lowは約8分の1のトークン
AWSの表を、そのまま整理します(各タスク・各段階6回)。
| 段階 | low | medium | high | xhigh |
|---|---|---|---|---|
| 全タスクの正解数 | 15/18 | 17/18 | 17/18 | 18/18 |
| 出力トークン平均(1回あたり) | 1,184 | 6,430 | 6,778 | 9,147 |
| lowを1.0としたときの倍率 | 1.0倍 | 5.4倍 | 5.7倍 | 7.7倍 |
| ツール呼び出し平均 | 17.2 | 18.7 | 17.8 | 18.1 |
| 所要時間(中央値) | 18秒 | 98秒 | 89秒 | 106秒 |
タスク別では、two_fault_diagnosis と migration_budget は low が5/6、medium 以上が6/6でした。maintenance_schedule は low・medium・high が5/6、xhigh だけが6/6で、AWSは「最上位の段階が最もはっきり差を出したタスク」と書いています。
AWSが挙げる観察は3つです。
- xhigh は全部正解: ただし6回ずつなので、段階間の差は「参考値であって統計的に確定したものではない」とAWSは明記しています。
- 推論の強さが変えるのは考える量: ツール呼び出しの回数は17.2〜18.7回でほぼ横ばい。集める事実は同じで、それを考える量が変わった、という解釈です。
- low は費用対効果が高い: 正解は15/18、出力トークンは xhigh の約8分の1、中央値は18秒。答えが後段で検査される場合や、少し正答率が下がってよい場合に向く、とAWSは書いています。全部を一発で正解させたいなら上の段階が安全、という整理です。
AWSは使い分けとして、段階をエージェント単位ではなくリクエスト単位で指定することを勧めています。計画と検証の手順は高い段階に、ツール結果の整形のような機械的な手順は low にする、という考え方です。
使い方──モデルID・API・必要な権限
呼び出しの要点は、AWSの2本の記事から次のとおりです。
| 項目 | 内容 |
|---|---|
| モデルの指定 | 推論プロファイル us.xai.grok-4.7(米国内で処理)または global.xai.grok-4.7(商用AWSリージョンのどこでも) |
| 使えるAPI | OpenAI互換の Chat Completions と Responses、Amazon Bedrock の Converse(9/28の記事には InvokeModel も記載) |
| 入出力 | 入力はテキストと画像、出力はテキスト。文脈は500Kトークン |
| 推論の強さ | low / medium / high / xhigh。9/28の記事では既定は high |
| Converse での指定 | additionalModelRequestFields に reasoning_effort。inferenceConfig には maxTokens だけを置く |
| 必要な権限 | bedrock:InvokeModel を、推論プロファイルとアカウントの default プロジェクトの両方に付ける(9/28の記事では、基盤モデル本体も対象に挙げ、ベアラートークン認証には bedrock:CallWithBearerToken も要るとしている) |
注意点が2つあります。推論トークンは出力トークンとして数えられ、max_completion_tokens を先に消費します。推論の途中で上限に達すると回答本文が無いまま返るので、AWSは空の内容を確認するよう勧めています。今回の実験の上限は32,768トークンでした。
また、グローバルのプロファイルは地理指定のプロファイルより安いとAWSは書く一方、個々のリクエストがどこで処理されるかを制御しにくく、遅延がぶれうる、とも書いています(9/28の記事)。データの所在に制約があるならUS側を選ぶ、という整理です。
料金は?
今回の記事は、意図的にトークン数で報告しています。AWSは「トークン単価は変わるが、トークン数は自分のコストを計算する元になる」という理由を書いています。Bedrock上の単価は、記事から「料金ページを見る」形で案内されているだけです。
筆者が今回取得した Amazon Bedrock の料金ページは、提供元の一覧に「xAI」の項目はあったものの、取得できた本文に Grok の語や単価は見当たりませんでした(取得時刻は日本時間0時57分)。そのため、Bedrock 上の Grok 4.7 の単価は、本記事では確認できていません。
参考として、x.aiの発表ページは、Grok 4.7 を「100万入力トークンあたり2ドル、100万出力トークンあたり6ドルから」と書き、Grok 4.6 と同じ価格・速度だとしています。これはx.ai側が示す価格で、Bedrock 上の価格とは限りません。AWSは、Bedrock のサービス階層のうち Flex と Priority では単価に倍率が掛かること、Global と US のプロファイルでも価格が違うことも書いています。
前のバージョンと何が違うのか
同じAWSの記事は、SpaceXAIの発表を引いて Grok 4.6 との差を次のように紹介しています。いずれも発表者側の数字です。
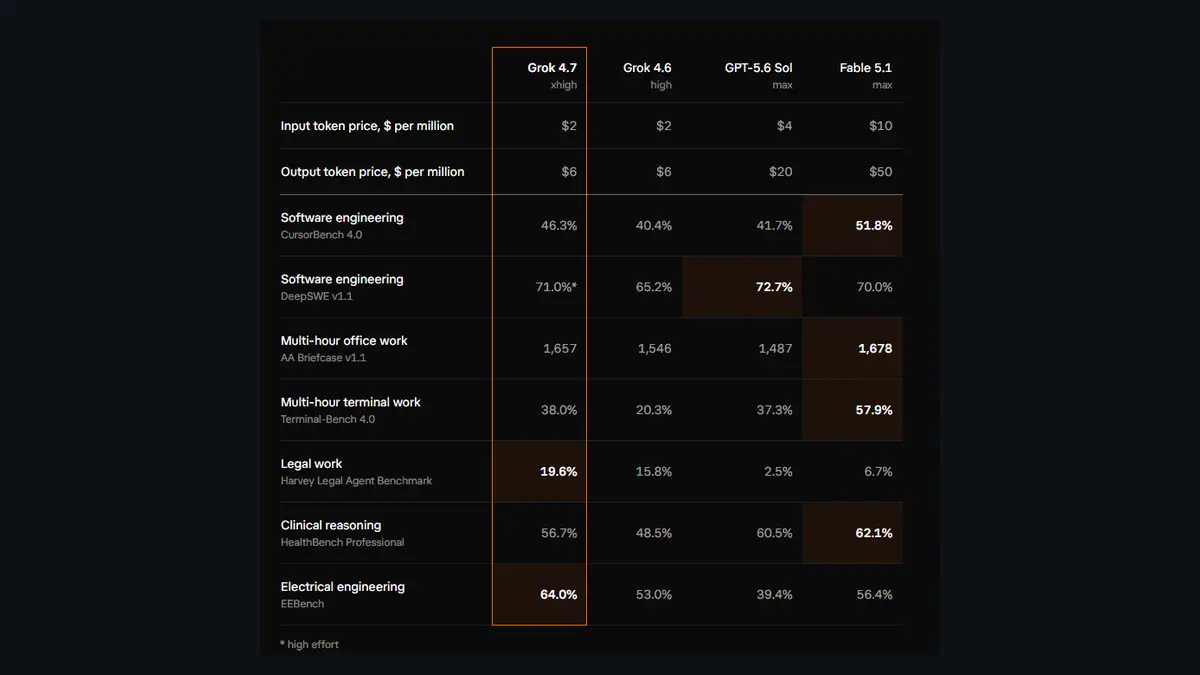
| ベンチマーク | 区分 | Grok 4.6 | Grok 4.7 |
|---|---|---|---|
| Terminal-Bench 4.0 | 数時間規模の端末作業 | 20.3% | 37.6% |
| EEBench | 電気工学 | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | 法務 | 15.8% | 19.6% |
| CursorBench 4.0 | 長めのコーディング | 40.4% | 46.3% |
| HealthBench Professional | 臨床推論 | 48.5% | 56.7% |
| AA Briefcase v1.1 | 数時間規模の事務作業 | 1,546 | 1,657 |
SpaceXAIの説明では、Grok 4.7 は新しい大きな基盤モデルを使い、数時間かかる問題に重みを置いた強化学習をより長く回したとされています。9/28のAWS記事には第三者機関 Artificial Analysis の数字もあり、Intelligence Index は46(Grok 4.6 は44)、Coding Agent Index は56(同47)です。ただし同じ表の最終行では、1タスクあたりの出力トークンが約81k(同約38k)と、おおよそ倍になっています。AWSは「だから推論の強さを意図的に決めるべきだ」と書いています。
x.aiの発表ページには、Grok 4.7 のほか GPT-5.6 Sol・Fable 5.1 の価格とベンチマークの比較表もあります。点数は項目ごとに上下が分かれ、たとえば Terminal-Bench 4.0 は Fable 5.1 の57.9%に対し Grok 4.7 は37.6%です。比較の詳細はx.aiの発表を参照してください。
公式ページを確認して気づいたこと
日本時間0時57分に3つのページを取得して読み比べたところ、会社名の表記がページごとに違っていました。10月13日のAWS記事は「SpaceXAI」、9月28日のAWS記事は「xAI」、x.aiの発表ページ(9月21日付)は「SpaceXSI」と書いています。同じ時刻に取得したページの間で同じ会社の表記が揃っていないため、本記事では10月13日のAWS記事に合わせて「SpaceXAI」と書き、引用元ごとの表記は上に記しました。
読むときの注意──AWSが書く限界と、書かれていないこと
AWSは「この測定の限界」を自分で列挙しています。
- 回数が少ない: タスクと段階ごとに6回。方向の一貫性は見えるが、信頼区間を出すには足りない。
- 合成環境: ツールは、コードで生成したデータを読む。実際のツールにある遅延・部分的な結果・エラーは試していない。
- 数時間ではなく数分: 所要時間の中央値は18秒(low)〜106秒(xhigh)。「長時間作業の縮小した代用品」で、方法は応用できるが絶対値は当てはまらない。
- 1モデル版・1リージョン・タスクごとに1つのプロンプト: 言い回しを変えると結果が変わりうる。
- 費用ではなくトークン数: 通貨に直すには、推論プロファイルとサービス階層の現行単価が要る。
加えて、今回確認した公式ページの範囲では、日本からの利用可否や、日本のリージョン(東京)で使えるかどうかは書かれていませんでした。AWSは対応リージョンの一覧を、Bedrock ユーザーガイドの Grok 4.7 モデルカードで見るよう案内しています。そのモデルカードは今回取得していないため、確認できていません。
ベンチマークの数字(Terminal-Bench 4.0 など)はSpaceXAI発表の値で、AWSが再現したものではありません。AWSの72回の実験は、あくまでAWSが自作したタスクでの結果です。
出典と確認した時刻
- Build long-horizon agents with Grok 4.7 on Amazon Bedrock(AWS公式・2026年10月13日): https://aws.amazon.com/blogs/machine-learning/build-long-horizon-agents-with-grok-4-7-on-amazon-bedrock/
- Grok 4.7 is now available on Amazon Bedrock(AWS公式・2026年9月28日): https://aws.amazon.com/blogs/machine-learning/grok-4-7-is-now-available-on-amazon-bedrock/
- Introducing Grok 4.7(x.ai公式・2026年9月21日): https://x.ai/news/grok-4-7
上記3ページを、日本時間2026年10月14日0時57分に取得して確認しました。Amazon Bedrock の料金ページも取得しましたが、Grok 4.7 の単価は見つからなかったため、本文では引用していません。製品は筆者が試したものではなく、すべて公式ページの記載に基づきます。本記事は続報があり次第更新します。
この記事でよく聞かれること
- Amazon BedrockでGrok 4.7を使うにはどのモデルIDを指定しますか?
- AWSの公式ブログによると、素のモデルIDではなく推論プロファイルを指定します。米国内で処理を完結させたい場合は us.xai.grok-4.7、データの所在に制約がなく広い処理能力を使いたい場合は global.xai.grok-4.7 です。OpenAI互換のChat CompletionsとResponses API、Bedrock の Converse API で呼び出せると書かれています。
- Grok 4.7の推論の強さ(reasoning effort)はどう選べばよいですか?
- AWSの実測(6回×3タスク×4段階=72回)では、全体で67回が正解でした。xhighは18回すべて正解、medium と high は17/18、low は15/18で、low の出力トークンは xhigh の約8分の1でした。AWS自身は、差は参考値であって統計的に確定したものではないと書いています。別記事では既定値は high とされ、明示的に設定することを勧めています。
- Grok 4.7のコンテキスト長と入力形式は?
- AWSの記事によると、コンテキストウィンドウは500Kトークンで、入力はテキストと画像、出力はテキストです。Amazon Bedrock上では、推論の強さの設定、ツール呼び出し、構造化出力に対応すると書かれています。
- AWSの72回の実験は、実際の長時間エージェントの性能を示していますか?
- AWS自身が「縮小した代用品」と書いています。実験は合成データの環境で、1回の実行は中央値で18秒(low)から106秒(xhigh)です。数時間かかる作業ではなく、タスクごと・段階ごとに6回ずつの実行なので信頼区間も出せないと、AWSは限界を明記しています。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Grok(グロック)のログイン方法 公式サイトgrok.comの右上「サインイン」から、Xのアカウントでも入れる。無料で使え、画面は日本語。入れない時の直し方【2026年10月版】
Grok(グロック)のログイン方法公式サイトgrok.comの右上「サインイン」から、Xのアカウントでも入れる。無料で使え、画面は日本語。入れない時の直し方【2026年10月版】
Cognition、Devinの次世代コーディングモデル「SWE-2」をエージェント選択の研究プレビューに追加 有効化はエンタープライズ管理者→組織管理者の2段階、Fable 5.1と組む「Fusion」にも先行採用
Cognition、Devinの次世代コーディングモデル「SWE-2」をエージェント選択の研究プレビューに追加有効化はエンタープライズ管理者→組織管理者の2段階、Fable 5.1と組む「Fusion」にも先行採用
 動画
SpaceXAIがGrok 4.7を公開 価格は4.6と同じ2ドル/6ドルのまま、公式表7項目で対Fable 5.1は3勝4敗・対GPT-5.6 Solは5勝2敗
SpaceXAIがGrok 4.7を公開価格は4.6と同じ2ドル/6ドルのまま、公式表7項目で対Fable 5.1は3勝4敗・対GPT-5.6 Solは5勝2敗
xAIの新製品「Grok Bot」 常設クラウドPCを持つAIチームメイトを公式ドキュメントで読む
xAIの新製品「Grok Bot」常設クラウドPCを持つAIチームメイトを公式ドキュメントで読む
 動画
xAIがGrok 4.6を公開 GPT-5.6 Solと同点、出力価格は6ドルで5分の1
xAIがGrok 4.6を公開GPT-5.6 Solと同点、出力価格は6ドルで5分の1
AWS、Amazon SageMaker(セージメーカー)AIの推論コンテナでMoEモデルのカーネルを最適化 H200で最大10%のスループット向上、初回トークンまでの時間は最大9%短縮
AWS、Amazon SageMaker(セージメーカー)AIの推論コンテナでMoEモデルのカーネルを最適化H200で最大10%のスループット向上、初回トークンまでの時間は最大9%短縮
IBM「Granite 4.2」の作り方 初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
IBM「Granite 4.2」の作り方初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00