SpaceXAIがGrok 4.7を公開──価格は4.6と同じ2ドル/6ドルのまま、公式表7項目で対Fable 5.1は3勝4敗・対GPT-5.6 Solは5勝2敗
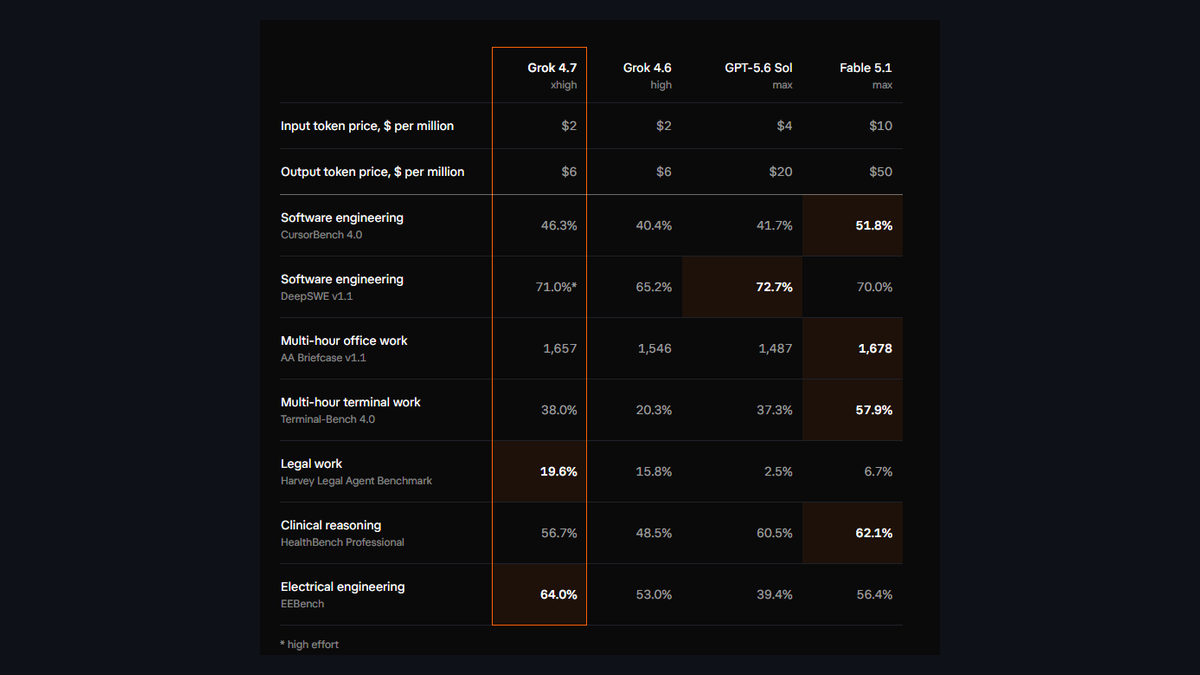
SpaceXAI(旧xAI)が2026年9月21日(米国時間)にGrok 4.7を公開。価格は入力2ドル・出力6ドル(100万トークン)でGrok 4.6から据え置き、コンテキスト50万トークン、知識カットオフ2026年5月(docs.x.ai)。公式の比較表7項目では前世代4.6に7勝0敗、GPT-5.6 Sol maxに5勝2敗、Fable 5.1 maxに3勝4敗。首位を取ったのは法務のHarvey(19.6%)と電気工学のEEBench(64.0%)の2項目で、表にOpus 5の列はありませんでした。
目次
2026年9月22日未明・日本時間時点の情報です。SpaceXAI(旧xAI)が米国時間の9月21日、Grok 4.7を公開しました。同社の発表によると、コーディングと知識労働向けの最上位モデルで、価格は入力100万トークンあたり2ドル、出力6ドルとGrok 4.6から据え置きです。公式が出した比較表は7項目で、前世代の4.6には7勝0敗、GPT-5.6 Sol maxには5勝2敗、Claude Fable 5.1 maxには3勝4敗でした。表を7項目ぜんぶ読んだ解説はYouTube(約12分)にまとめました。
動画版も公開しています: https://youtu.be/FIGB3ZLlDMI
3行まとめ
- 価格は入力2ドル/出力6ドルで4.6と同額。20万トークン超は4ドル/12ドル、キャッシュ入力0.50ドル。Fast版(速度2倍・料金2倍)はCursorとGrok Build限定で、公開APIには無い(docs.x.ai)
- 公式比較表7項目:対4.6は7勝0敗、対GPT-5.6 Sol maxは5勝2敗、対Fable 5.1 maxは3勝4敗。首位はFable 5.1が4項目、Grok 4.7が2項目(Harvey 19.6%・EEBench 64.0%)、Solが1項目(DeepSWE 72.7%)。表にOpus 5の列は無い
- コンテキスト50万トークン・知識カットオフ2026年5月(docs.x.ai)。安全は今回数字あり:LatchBioの生物安全ベンチ62.4%で首位、HackerBench v0.3で危険な両用プロンプトの通過3.3%(いずれもSpaceXAI発表)
何が公開されたか
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年9月21日(米国時間・公式ページの日付) |
| モデル名 | grok-4.7(Responses API/Chat Completions) |
| 価格 | 入力2ドル/出力6ドル(100万トークン)。20万トークン超は4ドル/12ドル。キャッシュ入力0.50ドル |
| Fast版 | 同じモデルを速い基盤で提供。出力速度2倍・料金2倍。CursorとGrok Build限定、Grok Buildの無料枠には含まれず、公開APIには無い |
| コンテキスト | 500,000トークン(docs.x.ai) |
| 知識カットオフ | 2026年5月(docs.x.ai) |
| 入出力 | テキスト+画像入力/テキスト出力。reasoning effortはlow/medium/high(既定)/xhigh |
| 利用できる場所 | Cursor(全プラン)/Grok Build(既定モデル)/API/OpenRouter・Vercel・Cloudflare(公式記載) |
| 記載が無い項目 | パラメータ数(「4.6より大きい新しいベースモデル」とだけ)、マルチモーダルの数値、Grok 4.8への言及、一般向けGrokアプリでの提供 |
SpaceXAIは位置づけをこう書いています。
Grok 4.7 is our most capable model for coding and knowledge work. It works longer on difficult tasks, checks its own work more carefully, and comes with our best-calibrated safeguards to date. Served at the same price and speed as Grok 4.6, it is highly competitive in its class.
(訳: Grok 4.7はコーディングと知識労働向けで当社の最も高性能なモデルである。難しいタスクにより長く取り組み、自分の作業をより注意深く確認し、当社でこれまでで最も較正されたセーフガードを備える。Grok 4.6と同じ価格と速度で提供され、同クラスの中で高い競争力がある)
ページの見出しには「Twice as fast, at half the price of comparable models.(同等のモデルの半額で2倍の速さ)」とあります。速さの実測値はページに載っておらず、これは公式の言い回しです。
比較表7項目の勝ち負け
SpaceXAIが公開した比較表の数値です。列は Grok 4.7 xhigh/Grok 4.6 high/GPT-5.6 Sol max/Fable 5.1 max。8月の4.6発表時と違い、GDPVal-AA・APEX・FrontierCode・AA Intelligence Indexは今回の表にありません。
| 評価(公式の分類) | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol max | Fable 5.1 max |
|---|---|---|---|---|
| CursorBench 4.0(Software engineering) | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1(Software engineering) | 71.0%※ | 65.2% | 72.7% | 70.0% |
| AA Briefcase v1.1(Multi-hour office work) | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0(Multi-hour terminal work) | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark(Legal work) | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional(Clinical reasoning) | 56.7% | 48.5% | 60.5% | 62.1% |
| EEBench(Electrical engineering) | 64.0% | 53.0% | 39.4% | 56.4% |
※DeepSWEのGrok 4.7の値だけはhigh設定の値(公式の注記「* high effort」)。
数え直すと、Grok 4.6には7項目すべてで上回り7勝0敗。GPT-5.6 Sol maxには5勝2敗で、負けたのはDeepSWE(71.0%対72.7%)とHealthBench(56.7%対60.5%)。Terminal-Benchは38.0%対37.3%の僅差勝ちです。Fable 5.1 maxには3勝4敗で、勝ったのはDeepSWE(71.0%対70.0%)、Harvey(19.6%対6.7%)、EEBench(64.0%対56.4%)、負けたのはCursorBench(46.3%対51.8%)、AA Briefcase(1,657対1,678)、Terminal-Bench(38.0%対57.9%)、HealthBench(56.7%対62.1%)です。Terminal-Benchの差が一番大きく、ここは4.6の時(26%対Fable 5の34.1%)と同じく開いたままです。
7項目の首位を数えると、Fable 5.1が4つ、Grok 4.7が2つ(法務のHarveyと電気工学のEEBench)、Solが1つ(DeepSWE)でした。
この表にOpus 5の列はありません。 Elon Musk氏は9月14日のX投稿で「Grok 4.7 should be roughly on par with Opus 5.0, not 5.1. Better in some ways, worse in others.(Grok 4.7はOpus 5.0とほぼ同等のはずで、5.1ではない。良い点も悪い点もある)」と書いていましたが、公式表の比較相手はAnthropicの最上位であるFable 5.1 maxで、Opus 5との直接比較は公式には出ていません。Opus 5が出てくるのは、次に述べるCursorBench 4.0の図だけです。
図にはOpus 5とGPT-6 Astraが入っている
発表ページの冒頭にはCursorBench 4.0のスコアを縦軸、1タスクあたりの平均コスト・出力トークン数・ステップ数を横軸にした図が3面あり、Fable 5.1・Opus 5・Grok 4.7・Sonnet 5・GPT-5.6 Solの曲線が描かれています。公式はこの図について「at the frontier in price-performance(価格性能でフロンティアにいる)」と書いています。図を見る限り、Grok 4.7の曲線はOpus 5とほぼ同じスコア帯で、コストの軸ではOpus 5より安い側にあります。ただしこれは図の読み取りで、各点の数値は本文に載っていません。
文書・プレゼン作成の説明に付いている図は、比較表と違ってGPT-6 Astra maxが入っています。
| 図 | Fable 5.1 max | Grok 4.7 xhigh | Grok 4.6 high | GPT-6 Astra max |
|---|---|---|---|---|
| GDPval(Elo) | 1735 | 1695 | 1605 | 1542 |
| AA Briefcase(Elo) | 1678 | 1657 | 1546 | 1569 |
| EEBench | 56.4% | 64.0% | 53.0% | 69.3% |
GDPvalとAA BriefcaseではGrok 4.7がAstraより上でFable 5.1のすぐ下、EEBenchではAstraがGrok 4.7より上です。比較表でGrok 4.7が「首位」だったEEBenchは、表の4列の中での話で、Astraを入れると2番目になります。 SpaceXAI自身はこの結果を「improves upon Grok 4.6 on both benchmarks and performs comparably to other frontier models(両ベンチで4.6から改善し、他のフロンティアモデルと同等の性能)」と書いており、首位とは書いていません。
価格は各社の公式ページで確認した
公式表の他社価格(GPT-5.6 Sol 4ドル/20ドル、Fable 5.1 10ドル/50ドル)は、この記事を書いた2026年9月22日にOpenAIとAnthropicの公式価格ページを筆者が直接開いて確認した値と一致しました。Opus 5は同じページで5ドル/25ドルです。
| モデル | 入力(100万トークン) | 出力(100万トークン) |
|---|---|---|
| Grok 4.7 | 2ドル | 6ドル |
| GPT-5.6 Sol(20万トークン以下・標準) | 4ドル | 20ドル |
| Claude Opus 5 | 5ドル | 25ドル |
| Claude Fable 5.1 | 10ドル | 50ドル |
出力で比べると、Grok 4.7はSolの10分の3、Opus 5のおよそ4分の1、Fable 5.1のおよそ8分の1(50÷6=8.33)です。8月の4.6記事ではSolを5ドル/30ドルで比べましたが、OpenAIの価格ページは現在4ドル/20ドル(20万トークン以下)になっています。
docs.x.aiのモデル一覧に埋め込まれた価格データでは、米国内で推論を完結させる専用エンドポイント(us.api.x.ai)が標準の10%増し(2.20ドル/6.60ドル)で、これは4.6と同じ構造です。
訓練の記述は4点
SpaceXAIが書いている改善点は4つです。(1)Grok 4.6より大きい新しいベースモデルを使った、(2)数時間かかる問題に重み付けした、より難しい課題の組み合わせで、より長い強化学習を回した、(3)自分の作業の検証と長いコンテキストの扱いが改善した、(4)Grok Botのハーネスをネイティブに理解するよう学習させ、会話タスクと一般的な知識労働が改善した。
Grok 4.7 uses a new, larger base model compared to Grok 4.6. It was trained with a longer reinforcement learning run on a harder mix of tasks, weighted toward problems that take many hours to complete.
(訳: Grok 4.7はGrok 4.6と比べて新しい、より大きなベースモデルを使っている。完了までに何時間もかかる問題に重み付けした、より難しいタスクの組み合わせで、より長い強化学習を回して訓練した)
ベースモデルの規模の数字はありません。4.6の発表にあった「4.5でSFTの学習軌跡を作り直した」という工程の記述は、今回の発表にはありませんでした(本記事が確認した範囲)。
安全については今回は数字が出ている
4.6の発表は「過去最大規模のテスト」という規模の記述だけで数字がありませんでしたが、今回は2つの数字があります。SpaceXAIによると、セーフガードの仕組みを丸ごと新しくし、拒否とジェイルブレイク耐性は自社で試した中で最も強いとしています。生物分野ではLatchBioの生物安全ベンチマークで62.4%で首位、サイバー分野では自社のHackerBench v0.3で危険な両用プロンプトを通してしまう割合が3.3%で、正当なセキュリティ作業はほとんどブロックしないと書かれています。あわせて、一部のサイバーセキュリティ・パートナーに招待制でレッドチーム能力の提供を始めたとしています。いずれもSpaceXAIの発表であり、第三者の検証ではありません。
公開から1時間の時点で見えたこと
筆者は9月22日0時54分(日本時間)に、docs.x.aiのモデル一覧にgrok-4.7が載ったのを監視スクリプトで検知し、公式発表ページを開きました。その時点で、OpenRouterのモデル一覧にgrok-4.7はまだ無く(最新はx-ai/grok-4.6)、Artificial AnalysisのSpaceXAIページにもGrok 4.7は掲載されていませんでした。公式Xアカウント(@SpaceXAI)の投稿も、1時5分の時点では検索に出ていません。公式ページが先に出て、周辺がまだ追いついていない状態で書いています。
なお、Artificial AnalysisのIntelligence Indexは現在v4.3.2で、8月の4.6記事で使った「61」とは版が違います(現在の表示では4.6 highが44)。Grok 4.7の指数が出ても、8月の数字とは並べません。
書かれていないこと
- パラメータ数(「より大きいベースモデル」とだけ)。Musk氏が以前に言及したとされる規模の数字は、本記事では一次投稿を確認できていないため使っていません
- マルチモーダルの数値。Musk氏は9月14日に「We need to fix multimodal performance.」と書いていましたが、公式ページに画像関連のベンチはありません
- Grok 4.8への言及。Musk氏は9月14日に「Grok 4.8, which is a 2.5T model ... will finish training this week and start RL」と投稿していますが、今回の発表に4.8の記述はありません
- 一般向けのGrokアプリ(grok.com・X・SuperGrok)で4.7が使えるかどうか。公式ページとdocsが挙げている入口はCursor・Grok Build・API・ゲートウェイです
- ベンチマークの版が8月の表と違います(CursorBench v3.2→4.0、Terminal-Bench v3.0→4.0、AA Briefcase→v1.1)。同じDeepSWE v1.1でも4.6の値が65.9%→65.2%に変わっており、本記事は8月の表と今回の表を混ぜて比べていません
- ベンチの数字はすべてSpaceXAIの発表と公式図に基づくもので、筆者が再現テストをしたものではありません
- 価格は2026年9月22日に各社公式ページで確認した値です。価格改定があれば変わります
参照した発表と価格ページ
- SpaceXAI 公式発表「Introducing Grok 4.7」(2026年9月21日) https://x.ai/news/grok-4-7
- docs.x.ai「Grok 4.7」(Context window・Knowledge cutoff・Fast variant・Where it runs) https://docs.x.ai/developers/grok-4-7
- docs.x.ai「Models」(価格) https://docs.x.ai/developers/models
- OpenAI 公式価格ページ(2026年9月22日確認) https://developers.openai.com/api/docs/pricing
- Anthropic 公式価格ページ(2026年9月22日確認) https://platform.claude.com/docs/en/about-claude/pricing
- 前世代の記事: xAIがGrok 4.6を公開
- 本記事は続報があり次第更新します(Artificial Analysisの掲載、OpenRouterへの登録、公式Xの投稿、一般向けアプリでの提供など)
「この項目の見方が違う」「実際に使ったらこうだった」という指摘をコメントでもらえたら、次の記事と動画に反映します。
出典・参照資料
- 一次資料SpaceXAI 公式発表: Introducing Grok 4.7 (2026-09-21) ↗
- 一次資料docs.x.ai: Grok 4.7(Context window・Knowledge cutoff・Fast variant・Where it runs) ↗
- 一次資料docs.x.ai: Models(価格・長文脈・キャッシュ) ↗
- 一次資料OpenAI 公式価格ページ ↗
- 一次資料Anthropic 公式価格ページ ↗
- 二次資料Elon Musk のX投稿 (2026-09-14) 「Grok 4.7 should be roughly on par with Opus 5.0, not 5.1」 ↗
この記事の解説動画
YouTubeで見る ↗AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事

xAIがGrok 4.6を公開──GPT-5.6 Solと同点、出力価格は6ドルで5分の1

Claude・GPT・Gemini API料金の読み方──2026年8月27日に公式ページで確認した単価早見表

xAI、Grok 4.5を発表──ベンチ1位はゼロだがトークン効率4.2倍・入力$2出力$6で別の土俵へ
XiaomiがMiMo-V2.6を公開──1.02兆パラメータのオープンウェイト、公式掲載のArtificial Analysis指数46、価格はV2.5据え置き

xAI、コスト効率型『Grok 4.3』と専用コーディングモデル『Grok Build 0.1』を投入
Google Antigravity(アンチグラビティ)とは──無料で使えるGoogleのAIエージェント開発環境。Antigravity 2.0(単体アプリ)・CLI(agy)・IDE拡張の3つの入口、無料/AI Pro/AI Ultraで変わる上限、日本で使えるか、Claude Codeなど他社ツールからのログインが規約違反になる理由
xAIの新製品「Grok Bot」──常設クラウドPCを持つAIチームメイトを公式ドキュメントで読む