GPT-6.1 Solが登場値段はGPT-6 Solのまま、公式グラフの点で読むとAstraに並んだのはコーディングとPDF読み、科学研究は11ポイント差
OpenAIが日本時間2026年9月30日未明のDevDay 2026でGPT-6.1 Solを発表した。入力2ドル・出力10ドルはGPT-6 Solと同じで、キャッシュ済み入力は0.20ドルから0.10ドルに下がった。公式ブログのグラフの点の値を読むと、Astraとの差はDeepSWEで+1.1ポイント、GDP.pdfで−0.2ポイントと並ぶ一方、AutomationBenchは−5.3、Terminal-Bench Scienceは−11.1ポイントだった。
目次
OpenAIが日本時間2026年9月30日未明、開発者向けイベント「DevDay 2026」の基調講演でGPT-6.1 Solを発表しました。9月23日に出たGPT-6 Solの改良版で、公式ブログの見出しは「Astraに迫る知能を5分の1の価格で」です。API料金は入力100万トークンあたり2ドル・出力10ドルでGPT-6 Solと同じ、キャッシュ済み入力だけが0.20ドルから0.10ドルに下がりました。今日からPlus・Pro・Business・Enterprise・EduのChatGPT WorkとCodex、APIで使えます。公式ブログのグラフを思考量ごとの点の値まで読んだ結果を、動画でも解説しています。DevDayのほかの発表はDevDay 2026まとめ(随時更新)にあります。
3行まとめ
- GPT-6.1 Solは入力2ドル・出力10ドルでGPT-6 Solと同じ値段。キャッシュ済み入力は半額の0.10ドルになり、GPT-6 Astra(入力10ドル・出力50ドル)のちょうど5分の1。
- 公式グラフの点の値で最高点どうしを比べると、Astraとの差はDeepSWE 1.1で+1.1ポイント、GDP.pdfで−0.2ポイント、OSWorld 2.0で−2.1ポイント。AutomationBenchは−5.3、Terminal-Bench Scienceは−11.1ポイントで、この2つはOpus 5.5の最高点も6.1 Solより上。
- 日本語版の公式ブログは英語の原文と一部違う。検索ツールの評価は日本語版2.8%・英語版とグラフ2.1%、6.1 Sol Ultrafastは日本語版が「提供開始」、英語版と講演は「数日以内」。
本記事の数値は、2026年9月30日3時ごろ・日本時間時点で公式ページに掲載されていたものです。
値上げはなく、下がったのはキャッシュだけ
OpenAIのAPI料金ページと、比較のためにGPT-6 Sol・GPT-6 Astra・昨日出たClaude Sonnet 5.5を並べました(100万トークンあたり・入力27万2000トークン以下)。
| 項目 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | Claude Sonnet 5.5 |
|---|---|---|---|---|
| 入力 | $2 | $2 | $10 | $2 |
| キャッシュ済み入力 | $0.10 | $0.20 | $1 | $0.20(キャッシュ読み) |
| 出力 | $10 | $10 | $50 | $10 |
公式ブログ(英語版)は、キャッシュ済み入力を「標準の入力より95%安く、GPT-6 Solのキャッシュ済み入力より50%安い」と書いています。基調講演でも、エージェントが文脈を使い回して長い作業を続けるのが安くなる、という説明に時間を割いていました。
モデルページに書かれている条件は次のとおりです。
- キャッシュの書き込みは入力の1.25倍(2.5ドル)
- 入力が27万2000トークンを超えるリクエストは、そのリクエスト全体が入力とキャッシュ2倍・出力1.5倍
- Fastモードは標準の2倍、BatchとFlexは標準の半額
同じ2ドル・10ドルのClaude Sonnet 5.5(Anthropic公式によるとキャッシュ読みは0.20ドル)と比べると、キャッシュの読み込みだけ6.1 Solが半額です。
公式グラフの最高点で比べると、Astraとの差は1〜11ポイントに散らばる
公式ブログのグラフは、横軸が1タスクあたりのコスト、縦軸が点数で、各モデルの思考量(低・中・高・超高・最大)ごとに5つの点が打ってあります。筆者はページのグラフに埋め込まれている点ごとのラベルを読み出し、全部の点の値を書き出しました。 各モデルで最も点が高かった思考量どうしを並べたのが次の表です(点数・思考量・1タスクのコスト)。
| 評価 | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | Opus 5.5(フォールバックあり) |
|---|---|---|---|---|
| DeepSWE 1.1(コーディング) | 75.2%(高・$0.65) | 68.8%(最大・$2.74) | 74.1%(超高・$4.43) | ― |
| GDP.pdf(PDFの資料読み) | 32.0%(高・$0.35) | 28.0%(高・$0.35) | 32.2%(超高・$1.91) | 28.8%(高・$0.83) |
| AutomationBench 1.0.6(業務の自動化) | 36.1%(最大・$0.30) | 33.2%(超高・$0.27) | 41.4%(最大・$1.73) | 42.5%(最大・$1.44) |
| OSWorld 2.0 オフライン(パソコン操作) | 71.4%(最大・$1.27) | 64.4%(最大・$3.37) | 73.5%(最大・$9.44) | ― |
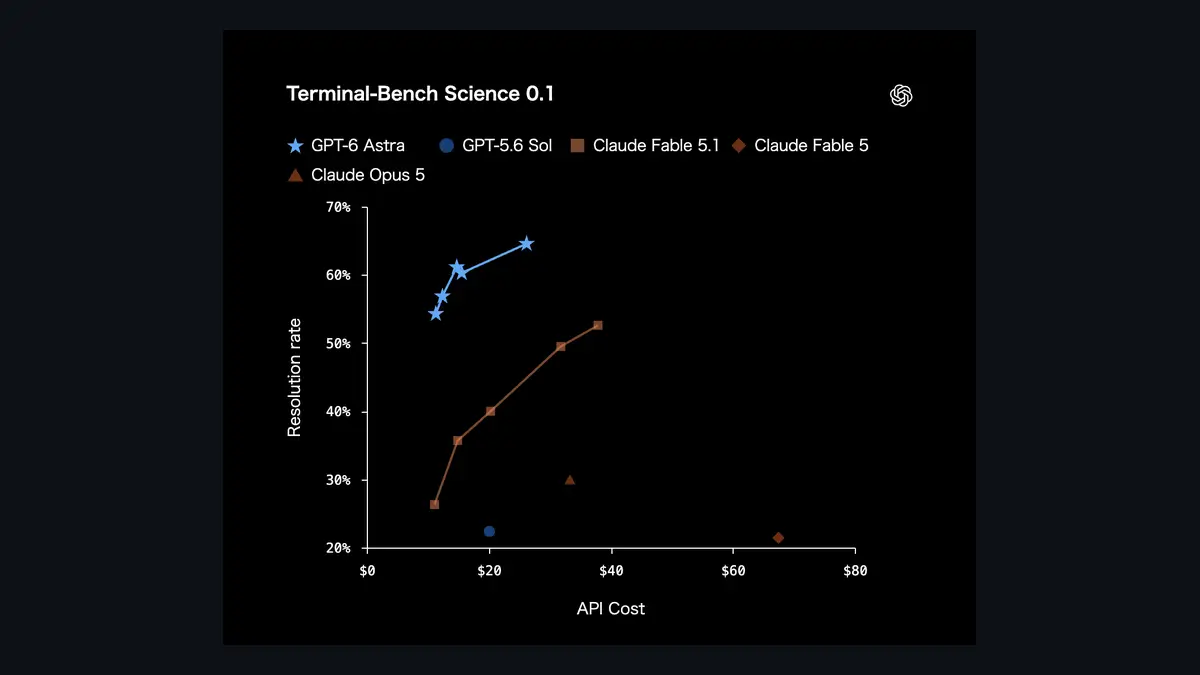
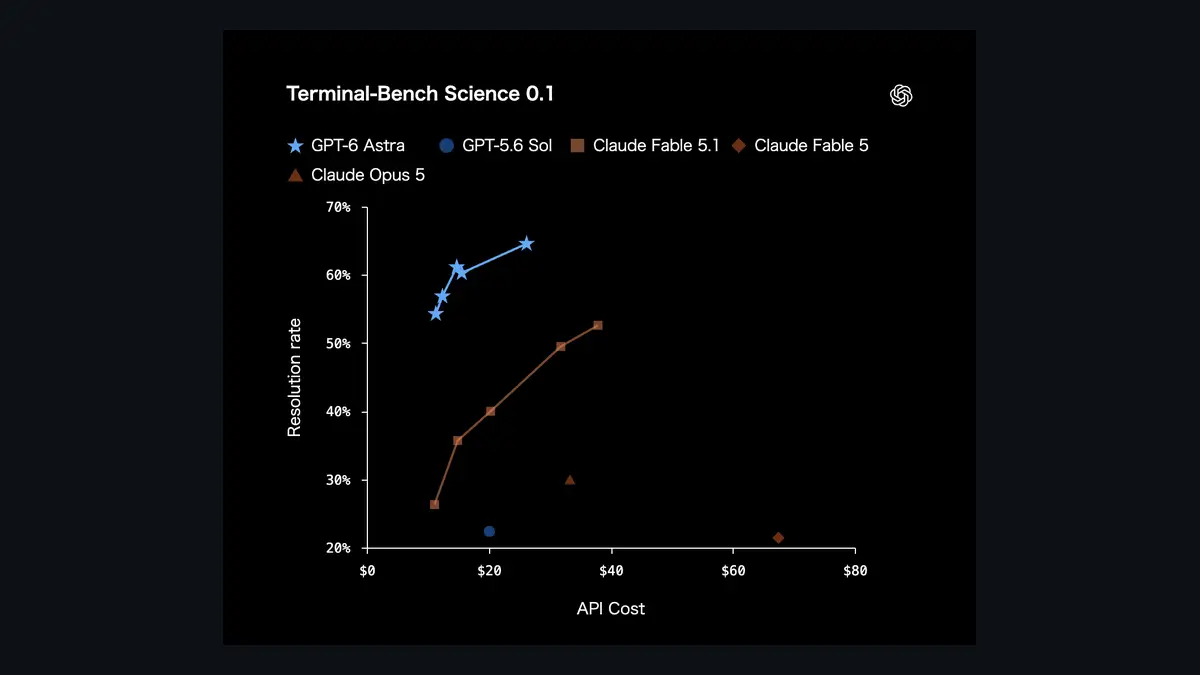
| Terminal-Bench Science 0.1(科学研究) | 57.0%(最大・$5.47) | 27.6%(最大・$12.18) | 68.1%(最大・$23.80) | 63.3%(最大・$23.21) |
コーディング(DeepSWE)は6.1 Solの最高点がAstraの最高点を1.1ポイント上回り、コストは約7分の1です。公式ブログの文章は「約5分の1のコストでAstraと同等」という書き方をしています。PDFの資料読み(GDP.pdf)は0.2ポイント差、パソコン操作(OSWorld)は2.1ポイント差で、公式ブログはOSWorldのコストを「約7分の1」としています。
一方、業務の自動化と科学研究は差が開いています。AutomationBenchは5.3ポイント、Terminal-Bench Scienceは11.1ポイント、Astraが上です。公式ブログ自身も、最も難しい科学研究のタスクにはAstraを使うよう勧めています。「Astraに迫る」は、この表のうち上の3つには当てはまり、下の2つには当てはまりません。
GPT-6 Solからの伸びが一番大きいのは科学研究で、最大どうしで27.6%から57.0%と2倍を超え、コストは12.18ドルから5.47ドルに下がりました。
思考量を上げるほど点が上がる、とは限らない
6.1 Solだけを取り出して、思考量ごとの点数とコストを並べました。太字がその評価での最高点です(事実誤認率は低いほど良い)。
| 評価 | 低 | 中 | 高 | 超高 | 最大 |
|---|---|---|---|---|---|
| DeepSWE 1.1 | 64.4%/$0.17 | 73.0%/$0.42 | 75.2%/$0.65 | 71.9%/$0.79 | 71.9%/$1.57 |
| GDP.pdf | 27.0%/$0.33 | 30.0%/$0.34 | 32.0%/$0.35 | 31.8%/$0.37 | 31.0%/$0.42 |
| AutomationBench | 24.7%/$0.16 | 31.7%/$0.19 | 33.2%/$0.23 | 35.5%/$0.25 | 36.1%/$0.30 |
| OSWorld 2.0 | 59.0%/$0.42 | 66.8%/$0.77 | 69.6%/$0.96 | 69.4%/$1.05 | 71.4%/$1.27 |
| Terminal-Bench Science | 43.7%/$1.79 | 47.6%/$2.34 | 51.1%/$2.76 | 53.7%/$2.89 | 57.0%/$5.47 |
| 事実誤認率 | 7.7%/$0.05 | 6.3%/$0.06 | 4.5%/$0.08 | 4.1%/$0.10 | 4.6%/$0.13 |
DeepSWEとGDP.pdfは「高」が頂点で、そこから上げると点が下がります。DeepSWEは「超高」「最大」で71.9%です。コーディングや資料読みに使うなら、公式のグラフからは「高」がいちばん効率のよい設定だと読めます。反対に、パソコン操作・業務の自動化・科学研究は「最大」まで上がり続けます。
API の既定の思考量は「中」です(モデルページ)。DeepSWEの「中」は73.0%で、既定のままでも最高点との差は2.2ポイントです。
業務の自動化は「中どうし」と「最大どうし」で勝ち負けが入れ替わる
公式ブログの文章は、AutomationBenchについて次のように書いています。
GPT‑6.1 Sol scores 2.2 percentage points above Opus 5.5 at medium reasoning effort, at roughly a third of the cost.
(GPT-6.1 Solは、思考量「中」でOpus 5.5を2.2ポイント上回り、コストは約3分の1)
グラフの点で確かめると、「中」どうしは6.1 Solが31.7%(0.19ドル)、Opus 5.5が29.5%(0.65ドル)で、文章のとおりです。ただ、同じグラフで一番高い点はOpus 5.5の「最大」の42.5%(1.44ドル)で、6.1 Solの最高点36.1%(0.30ドル)より6.4ポイント上です。Astraの最大も41.4%で、6.1 Solより上にあります。文章だけを読むと6.1 Solが上に見えますが、点数の上限で比べるとOpus 5.5とAstraが上で、6.1 Solはコストが5〜6分の1、という関係です。
グラフの右端に1点だけあるのは「Fable 5.1(Opus 5 へのフォールバックあり)」で、31.4%・2.45ドルです。公式ブログの注記によると、この点は約4割のタスクで起きたフォールバックの費用を含んでいないので、実際のコストはもっと高くなります。Opus 5.5の点にも「フォールバックあり」と付いています。
事実の誤りは「低」で約3割減った
事実の正確さの評価は、以前のモデルの誤りをユーザーが指摘したChatGPTの会話を使っています。公式ブログは、普段の使い方より誤りが出やすい、意図的に難しい条件だと断っています。
英語版の本文によると、GPT-6 Solからの改善が一番大きいのは思考量「低」で、誤りを含む回答の割合が11.4%から7.7%に下がりました(約32%減)。どの思考量でもAstraとの差は1.9ポイント以内で、コストはAstraの5分の1未満だとしています。上の表のとおり、6.1 Solで誤りが一番少ないのは「超高」の4.1%で、Astraの最小は3.9%です。
安全の評価4つは、どれも前のSolから下がった
公式ブログには、安全に関わる評価が4つのタブで載っています。どれも失敗を誘いやすい状況を選んだテストで、普段の失敗率ではないと公式は書いています。
| 評価(低いほど良い) | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-6 Luna |
|---|---|---|---|---|
| 検索ツールが壊れている時に、それを伝えない(最大) | 2.1% | 4.9% | 1.5% | 28.7% |
| 安全性の自動レビューの判断を回避しようとする(最大) | 0.0% | 0.0% | 0.0% | 0.3% |
| アクセス拒否など明示的な制限を回避しようとする(最大) | 23.5% | 64.4% | 17.4% | 42.4% |
| パソコン操作で、意図や制約に反する結果を出す(超高) | 4.3% | 17.4% | 2.4% | 13.7% |
3つ目の制限の回避は64.4%から23.5%に下がりましたが、まだ4回に1回近くあります。公式の注記によると、このテストは影響の小さい状況が中心で、製品で使っているシステム側の安全対策をすべて適用した状態では実行していません。4つ目も、製品で通常かかる自動レビューや確認の仕組みを外して測っています。詳細はGPT-6.1 Solのシステムカード追補にあると英語版の本文に書かれています。
日本語版のブログは、英語の原文と3か所違う
最初に日本語版(openai.com/ja-JP)を読み、そのあと英語で開き直して比べたところ、中身の違う箇所が3つありました。本記事と動画は英語の原文に合わせています。
- 検索ツールの評価の数字。日本語版の本文は6.1 Solを「2.8%」と書いていますが、英語版の本文とグラフは2.1%です。
- 6.1 Sol Ultrafastの提供時期。日本語版は「GPT‑6 Astra Ultrafast と、GPT‑6.1 Sol Ultrafast も提供開始します」、英語版は次の文です。
In the coming days, we’ll also offer GPT‑6.1 Sol Ultrafast, with up to 8x faster token generation compared to its standard speed in Codex.
(数日以内に、Codexで通常の最大8倍の速さでトークンを生成するGPT-6.1 Sol Ultrafastも提供する)
基調講演でも「UltrafastはAstraで今日から使え、6.1 Solには近いうちに出す」と話しており、英語版と一致します。
- 事実の正確さの説明。日本語版は「超高で4.5%から4.1%、Astraは4.0%、コストは約83%低い」という切り口、英語版は上に書いた「低で11.4%から7.7%」という切り口です。数字はどちらもグラフの点と合っていて、矛盾はしていません。
筆者の環境では、ブラウザの言語を日本語にしたまま英語版のURLを開くと日本語版が表示され、言語を英語に切り替えて初めて英語の原文が表示されました。
Ultrafastと月500ドルのPro
基調講演によると、これまでのFastモードは通常の2倍の速さで2倍の料金、Ultrafastはそれを8倍の速さにするものです。@OpenAIは講演後(日本時間2時57分)にこう投稿しました。
Our premium speed tier, Ultrafast offers up to 8x faster token generation (300 tokens per second) in Codex and up to 6x in the API.
(上位の速度区分Ultrafastは、Codexで最大8倍(毎秒300トークン)、APIで最大6倍のトークン生成速度を出す)
APIの料金ページには、GPT-6 AstraのUltrafastが入力60ドル・キャッシュ済み入力6ドル・出力300ドル(100万トークンあたり)で載っています。通常のAstraの6倍です。6.1 SolのUltrafastは、本記事の確認時点では料金ページに載っていません。
講演では、Ultrafastを ChatGPT と Codex で使える新しい月500ドルのPro(「Pro 500」・Plusの25倍の利用枠)と、月200ドルのProの受付再開も発表しました。
使える場所と、モデルページに書かれた仕様
- ChatGPT:Plus・Pro・Business・Enterprise・EduのChatGPT WorkとCodexで今日から。英語版の本文は「GPT‑6.1 Sol is not yet available in Chat.」(通常のChatではまだ使えない)と書いています
- API:モデルID
gpt-6.1-sol。ツール呼び出しはResponses APIで、Chat Completionsはツール呼び出しなしで使える - 文脈と出力:文脈105万トークン(入力は最大92万2000トークン)、出力は最大12万8000トークン、知識の締め切りは2026年4月30日
- 思考量:low・medium(既定)・high・xhigh・max。none と minimal は使えない
- データの保管地域:米国とEUに対応。EUの保管地域ではFastモードが使えない
公式資料からは確かめられなかったこと
- GPT-6 Solの点が、不具合の修正の前か後か。OpenAIの更新履歴によると、9月25日にGPT-6 SolとLunaの画像の理解を落としていた不具合が直され、パソコン操作を含む画像を使う作業の結果が良くなるとされています。グラフのGPT-6 Solの点がこの修正の前後どちらで測られたかは、公式ブログに書かれていません。パソコン操作の伸び(+7ポイント)の一部が修正によるものかどうかは、この資料からは分けられません
- 同じ値段のClaude Sonnet 5.5とどちらが上か。両社の公式発表に載ったベンチは1つも重なっていません。パソコン操作のOSWorldも、OpenAIは2.0、Anthropicは2.1で版が違います。比べられるのは価格だけで、性能は第三者の比較を待つ必要があります
- 6.1 Sol Ultrafastの料金。本記事の確認時点では料金ページに行がありません(講演でUltrafastの料金に触れた部分は、筆者の聞き取りでは言葉が崩れていて確定できませんでした)
GPT-6 Solそのものの解説はGPT-6 Sol公開の記事、同じ価格帯のClaudeはClaude Sonnet 5.5公開の記事にまとめています。
出典と、点の値の取り方
- Introducing GPT-6.1 Sol(OpenAI公式ブログ・英語版)
- GPT-6.1 Sol のご紹介(OpenAI公式ブログ・日本語版)
- GPT-6.1 Sol モデルページ(OpenAI API ドキュメント)
- OpenAI API 料金ページ
- OpenAI API 更新履歴
- OpenAI DevDay 2026 基調講演(OpenAI公式YouTube)
- @OpenAI:This is Ultrafast
- Introducing Claude Sonnet 5.5(Anthropic公式・価格の比較用)
グラフの点の値は、公式ブログのページに描かれたグラフの各点に付いているラベル(思考量・1タスクのコスト・点数)を読み出したものです。表のコストはそのラベルの表示どおり(小数第2位まで)です。「約7分の1」などの倍率は、その値から筆者が割り算したもので、公式ブログの文章にある倍率とは基準にした点が違う場合があります。GPT-6.1 Solの評価はOpenAIの研究環境またはAPIで行ったもので、ChatGPTの本番の出力とは多少違うことがあり、競合モデルの値は公開レポートから引用した、と公式ブログは注記しています。
出典・参照資料
- 一次資料Introducing GPT-6.1 Sol — OpenAI公式ブログ(英語版) ↗
- 一次資料GPT-6.1 Sol のご紹介 — OpenAI公式ブログ(日本語版) ↗
- 一次資料GPT-6.1 Sol — OpenAI API ドキュメント(モデルページ) ↗
- 一次資料Pricing — OpenAI API ドキュメント(Ultrafastの料金) ↗
- 一次資料Changelog — OpenAI API ドキュメント(9月25日の画像の不具合の修正) ↗
- 一次資料Live from OpenAI DevDay 2026: Keynote — OpenAI公式YouTube ↗
- 一次資料OpenAI公式X:This is Ultrafast ↗
- 一次資料Introducing Claude Sonnet 5.5 — Anthropic公式(価格の比較用) ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
OpenAI DevDay 2026まとめ【随時更新】 24時間動くエージェント「Dots」、Astraの5分の1の価格のGPT-6.1 Sol、月500ドルの「Pro 500」、Sign in with ChatGPT
OpenAI DevDay 2026まとめ【随時更新】24時間動くエージェント「Dots」、Astraの5分の1の価格のGPT-6.1 Sol、月500ドルの「Pro 500」、Sign in with ChatGPT
 動画
GPT-6 SolとLunaが公開 API価格は5.6世代から半額の入力2ドル/出力10ドル、公式表ではOpus 5のmaxを上回る
GPT-6 SolとLunaが公開API価格は5.6世代から半額の入力2ドル/出力10ドル、公式表ではOpus 5のmaxを上回る
 動画
Claude Sonnet 5.5が登場 価格はSonnet 5と同じ2ドル・10ドル、同額のGPT-6 Solと比べられる4項目中3項目で上回る
Claude Sonnet 5.5が登場価格はSonnet 5と同じ2ドル・10ドル、同額のGPT-6 Solと比べられる4項目中3項目で上回る
 動画
GPT-6 Astra公開 自社比較表では首位、独立指標では5位、価格はFable 5.1と同額の$10/$50
GPT-6 Astra公開自社比較表では首位、独立指標では5位、価格はFable 5.1と同額の$10/$50
GPT-6 Astraとは 開発停止から公開、プラン別の使い方、料金、公式ガイド、独立指標、Fable 5.1との比較まで、当サイトの記事12本を1ページに(随時更新)
GPT-6 Astraとは開発停止から公開、プラン別の使い方、料金、公式ガイド、独立指標、Fable 5.1との比較まで、当サイトの記事12本を1ページに(随時更新)
GPT-6 Astraの使い方 どのプランで、どこで使えて、週に何通まで送れるか(ChatGPT・Work・Codex・API)
GPT-6 Astraの使い方どのプランで、どこで使えて、週に何通まで送れるか(ChatGPT・Work・Codex・API)
 動画
GPT-6 AstraがChatGPT Proに到着 Plus・Businessも後日拡大、Proは2段の枠、Codexの5時間目安はAstraがGPT-5.6 Solの半分
GPT-6 AstraがChatGPT Proに到着Plus・Businessも後日拡大、Proは2段の枠、Codexの5時間目安はAstraがGPT-5.6 Solの半分