Claude Sonnet 5.5が登場価格はSonnet 5と同じ2ドル・10ドル、同額のGPT-6 Solと比べられる4項目中3項目で上回る
Anthropicが2026年9月28日(日本時間29日未明)にClaude Sonnet 5.5を公開した。価格は入力2ドル・出力10ドルでSonnet 5から据え置き、GPT-6 Solとも同じ。公式ベンチ8項目すべてでSonnet 5を上回り、Terminal-Bench 4.0は10.3%から70.6%になってOpus 5.5の66.4%も上回った。GPT-6 Solの値がある4項目のうち3項目はSonnet 5.5が上、FrontierCodeは設定によって上下が入れ替わる。
目次
Anthropicが現地2026年9月28日(日本時間29日未明)、Claude Sonnet 5.5を公開しました。価格は入力100万トークンあたり2ドル・出力10ドルで、Sonnet 5から据え置きです。この2ドル・10ドルは、OpenAIが9月23日に出したGPT-6 Solと同じ値段です。公式ベンチマーク8項目のすべてでSonnet 5を上回り、Terminal-Bench 4.0ではOpus 5.5も上回りました。モデルIDは claude-sonnet-5-5 で、Claude Platform・AWS・Google Cloud・Microsoft Azureで公開と同時に使えます。動画でも公式のベンチ表とグラフを通しで読んでいます。
3行まとめ
- Claude Sonnet 5.5は入力2ドル・出力10ドルでSonnet 5と同じ価格。公式は、同じ仕事に使うトークンが少ないため1タスクあたり最大30%安く、出力は30%以上速いとしている。
- 公式ベンチ8項目すべてでSonnet 5を上回り、Terminal-Bench 4.0は10.3%から70.6%。Opus 5.5(66.4%)を上回ったのはこの1項目で、残り7項目はOpus 5.5が上。
- GPT-6 Solの値が載っている4項目のうち、GDPval-AA・AA-Briefcase・Chartographyの3項目はSonnet 5.5が上。FrontierCodeはxhighなら上、maxだと下になる。
本記事の数値は、2026年9月29日未明・日本時間時点で公式ページに掲載されていたものです。
位置づけは「Opus 5.5を補う、速くて安い方」
公式発表はSonnet 5.5を「Claude 5.5ファミリーの2番目のモデル」と書いています。1番目は9月22日のOpus 5.5で、そこから6日後の公開です。
役割の分け方も書かれています。Opus 5.5は慎重な判断が要る複雑な仕事向けで、Sonnet 5.5は範囲のはっきりした日常の仕事、バグ修正、資料・スライド・表計算の作成に強い、としています。残るClaude Haiku 5.5は「数週間以内」に続く予定です。
価格はSonnet 5のまま、GPT-6 Solとも同じ
公式発表の価格表と、比較のためにSonnet 5・GPT-6 Sol・Opus 5.5を並べました(100万トークンあたり)。
| 項目 | Claude Sonnet 5.5 | Claude Sonnet 5 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|---|---|
| 入力 | $2 | $2 | $2 | $4 |
| 出力 | $10 | $10 | $10 | $20 |
| キャッシュ読み込み | $0.20 | $0.20 | $0.20 | $0.20 |
| キャッシュ書き込み | $2.50 | $2.50 | $2.50 | $5 |
表の上では4項目ともGPT-6 Solと同じです。違いが出るのは長い入力で、OpenAIの公式ページによると、GPT-6 Solは入力が27万2千トークンを超えるリクエストで入力とキャッシュが2倍、出力が1.5倍になります。Claudeの料金ページは、Claude 4.6以降のモデルは100万トークンのコンテキスト全体を標準価格で使えると書いています。長い資料を丸ごと読ませる使い方では、Sonnet 5.5の方が安くなります。
公式は、単価が同じでも1タスクあたりの費用は下がるとしています。
Sonnet 5.5 is priced the same as Sonnet 5 ... but it typically needs far fewer tokens to do the same work. In our testing, it costs up to 30% less per task than its predecessor.
(Sonnet 5.5の価格はSonnet 5と同じだが、同じ仕事に要するトークンは通常ずっと少ない。社内テストでは、1タスクあたりの費用が前モデルより最大30%低い)
出力の生成はSonnet 5より30%以上速く、「これまでで最も速いSonnet」とされています。effort(考える量)の既定値は、ClaudeのアプリとClaude Codeが medium、Claude Platform(API)が high です。
公式ベンチ8項目:Sonnet 5には全勝、Opus 5.5を上回ったのは1項目
公式発表のベンチ表をそのまま写しました。
| 項目 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4%(xhigh) | — |
| FrontierCode 1.1 (Main) | 46.2%(max)/52.1%(xhigh) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam(ツールあり) | 64.5% | 54.9% | 67.7% | — |
| OSWorld 2.1(partial) | 80.1% | 57.0% | 81.8% | — |
| Chartography(ツールなし) | 61.6% | 15.6% | 64.4% | 53.6% |
Sonnet 5との差が最も大きいのはTerminal-Bench 4.0で、10.3%から70.6%になりました。Chartographyも15.6%から61.6%です。
Opus 5.5を上回ったのはTerminal-Bench 4.0の1項目だけで、Opus 5.5の66.4%は公式の注記によるとxhighでの最高値です。残り7項目はOpus 5.5が上ですが、GDPval-AAは1844点と1846点で2点差、OSWorldは80.1%と81.8%です。公式自身は「ベンチの点数は能力の一面にすぎず、判断が続く複雑で自由度の高い仕事ではOpus 5.5がはっきり強いまま」と書いています。
表の外では、スクリーンショットだけを見てポケモン赤をクリアした最初のSonnetだとも書かれています。
GPT-6 Solの値があるのは4項目
GPT-6 Solの列に数字があるのは8項目中4項目です。
- GDPval-AA v2.1:Sonnet 5.5が1844点、GPT-6 Solが1487点
- AA-Briefcase v1.1:1811点と1483点
- Chartography:61.6%と53.6%
- FrontierCode 1.1:Sonnet 5.5はxhighの52.1%ならGPT-6 Solの49.3%を上回り、maxの46.2%だと下回る
FrontierCodeでmaxがxhighより低い理由を、公式は脚注で説明しています。maxではClaude Codeのコードレビュー用スキルを使う頻度が上がり、レビューを多数のサブエージェントに分けた結果、タイムアウトや頼まれていない範囲の編集が出た、というものです。FrontierCodeは人手の修正なしにマージできるかを見るベンチで、範囲外の変更は減点されます。
GPT-6 Solの数字にも注記が付いています。OpenAIが最近GPT-6 Solの画像理解のバグを直しており、Artificial AnalysisのAA-BriefcaseとGDPval-AA、Surge AIのChartographyの公式スコアには、まだ反映されていない可能性がある、としています。一方、GDPval-AAとAA-Briefcaseは公開前のSonnet 5.5で測られ、構造化出力に関わるバグがあった(現在は修正済み)とも書かれています。
同じ値段なのに1タスクの費用が違う
公式発表は、点数と1タスクあたりの費用を同じグラフに並べています。本文に書かれている比較は次の4つです。
| ベンチ | Sonnet 5.5の設定 | 比べた相手 | 費用 |
|---|---|---|---|
| Terminal-Bench 4.0 | medium(アプリの既定) | Sonnet 5の最高点を大きく上回る | 10分の1未満 |
| FrontierCode | high(Platformの既定) | GPT-6 Solの最高点に並ぶ | 約5分の1 |
| CursorBench 4.0 | low | Sonnet 5の最高点を上回る | 10分の1未満 |
| AA-Briefcase | medium | Sonnet 5の最高点を上回る | 約9分の1 |
FrontierCodeの行は、単価が同じGPT-6 Solとの比較です。単価が同じなので、1タスクあたりの費用の差はおおむね使ったトークンの量の差になります(Solの27万2千トークン超の割増を除く)。なお、Terminal-Bench 4.0とCursorBench 4.0のグラフに載っているSolは、GPT-6 SolではなくGPT-5.6 Solです。GPT-6 Solの値が公表されていないため、と公式が注記しています。
コーディングでは、FrontierCodeのhighで同じ設定のSonnet 5より10ポイント高く、費用は約15分の1と書かれています。
導入企業が挙げた数字
公式発表には、先行して試した企業のコメントが載っています。数字が出ているものを並べます。
| 企業 | コメントに書かれた数字 |
|---|---|
| Base44 | 118本のアプリ制作でOpus 5と同水準。1本あたりの反復は平均3.6回(Opus 5は7.7回) |
| Balyasny Asset Management | 2,441件の金融タスクで、1回答あたり約12万1千トークン(Sonnet 5は約49万7千) |
| Slack | プロンプトを変えずにほぼ全ての社内評価でSonnet 5を上回り、出力トークンは約14%減 |
| Zendesk | 本番で使っているClaudeモデルより、問い合わせの処理が20%速くなった |
| Box | 前のモデルより正確で、2.4倍速く、総トークンは12%少ない(Sonnet 5が見落とした誤りを拾ったとも) |
| Unity | 複数手順のUnity Editorとコーディングのテストで90%のタスクを完了 |
公式の社内テストでは、上場企業の決算資料と電話会議の書き起こし、スライドのひな形を渡して10枚の業績レビューを作らせ、専門家2人が最初の下書きを「そのまま送れる」と判断した、とされています。
カットオフは2026年6月、Sonnet 5から5ヶ月進んだ
公式ドキュメントの諸元です。
| 項目 | Claude Sonnet 5.5 | Claude Sonnet 5 |
|---|---|---|
| モデルID | claude-sonnet-5-5 |
claude-sonnet-5 |
| リリース | 2026年9月28日 | — |
| コンテキスト | 100万トークン | 100万トークン |
| 最大出力 | 12万8千トークン(Batch APIのベータで30万) | — |
| 知識のカットオフ(Reliable / Training data) | 2026年6月 / 2026年6月 | 2026年1月 / 2026年1月 |
| APIの既定effort | high |
— |
| 提供終了 | 2027年9月28日より前にはしない | — |
カットオフの2026年6月は、Opus 5.5・Fable 5.1と同じ月です。
Sonnet 5で動くコードに影響する変更が5つ
公式ドキュメントは、Sonnet 5で動いているコードに影響する破壊的変更として次の5つを挙げています。
- 最初の思考(up-front thinking)を切るには、新しい
between_tools設定を使う。thinkingをオフにして使っていた場合は、移行前にこの設定へ切り替える - ツールの強制指定(forced tool use)がエラーを返す
- thinkingブロックが、それを出したモデルと会話に紐づく
- Claude APIとGoogle Cloudで、以前の
computer_20251124コンピューター操作ツールが受け付けられない - advisorツールが、Claude Opus 4.8・Claude Opus 4.7・Claude Sonnet 5をadvisorとして受け付けない
加えて、リクエストは失敗しないものの応答の形が変わる変更として、ツール呼び出しの間の文章が thinking ブロックで返るようになります。その文章をユーザーに流しているアプリは、display を設定するか between_tools にしない限り、ツール呼び出しの間が無言になります。
Sonnetで初めて付いた2つの安全装置
公式は、Sonnet 5.5のサイバー能力がOpus 5と同程度になったため、Sonnetとして初めてサイバー用のセーフガードとフォールバックを付けて公開したと書いています。通常のバグ修正は影響を受けず、危険度の高いサイバーの作業は目に見える形でSonnet 5に切り替わります。
もう1つは蒸留への対策です。大量の偽アカウントで能力を抜き出す攻撃に対して、思考の抜き取りを防ぐ分類器を付けたのもSonnetで初めてとしています。生物分野のセーフガードはSonnet 5と同じです。
整合性の評価では、約1,850の場面で試す自動の行動監査で、ほとんどの項目がSonnet 5と同じか上回ったとされています。全体ではOpus 5.5がわずかに上で、ユーザーの意図に反する目標を追う証拠は見つからなかった、とも書かれています。
発表の46分前に配られたClaude Codeに、定義が先に入っていた
筆者は今回、公式ページが出た瞬間を拾うための監視を回していました。発表ページ(anthropic.com/claude-sonnet-5-5)の公開を検知したのは日本時間2時58分です。
その約46分前、2時11分59秒に、npmの @anthropic-ai/claude-code の next チャネルで2.1.284が配布されていました。この版の実行ファイルを展開すると、claude-sonnet-5-5 という文字列が24件あり、1つ前の2.1.283には1件もありませんでした。中には次のようなモデル定義が入っていました(抜粋)。
{id:"claude-sonnet-5-5",family:"sonnet",display_name:"Sonnet 5.5",knowledge_cutoff:"June 2026",
 context:{window:1e6,native_1m:!0,...},max_output_tokens:{default:128000,upper:128000},
 pricing:"tier_2_10",default_effort:"medium",...}
カットオフのJune 2026、最大出力12万8千、Claude Codeでの既定effortのmediumは、後から出た公式ドキュメント・発表と一致していました。価格ティアの名前 tier_2_10 もSonnet 5と同じで、結果として価格は据え置きでした。Opus 5.5のときも、公式発表の約40分前に同じ形でClaude Codeの配布物へ定義が入っており、2回続けて同じ順番でした。
公式の資料だけでは分からなかったこと
- GPT-6 Solとの比較は4項目に限られる:Terminal-Bench 4.0、CursorBench 4.0、Humanity's Last Exam、OSWorld 2.1には、GPT-6 Solの値が表に載っていません。
- 一部のスコアは前提付き:GPT-6 Solの画像理解のバグ修正が反映されていない可能性、Sonnet 5.5の公開前の版で測ったGDPval-AAとAA-Briefcaseのバグ、の2つの注記があります。
- 導入企業の数字の条件:発表ページに載っているのは各社のコメントで、どの設定でどう測ったかまでは本記事が確認した範囲では書かれていません。
出典と確認した範囲
- 公式発表「Introducing Claude Sonnet 5.5」(2026年9月28日):https://www.anthropic.com/claude-sonnet-5-5
- 公式ドキュメント Claude Sonnet 5.5:https://platform.claude.com/docs/en/models/sonnet-5-5/overview
- 公式ドキュメント What's new in Claude Sonnet 5.5:https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- Claude Sonnet 5.5 System Card:https://www.anthropic.com/claude-sonnet-5-5-system-card
- Claude 料金ページ:https://platform.claude.com/docs/en/about-claude/pricing
- GPT-6 Sol(OpenAI公式ドキュメント・価格の比較に使用):https://developers.openai.com/api/docs/models/gpt-6-sol
ベンチの数値は公式発表の表から写しています。GPT-6 Solの価格と長い入力の割増は、9月23日に本サイトがOpenAI公式ページで確認した値です。System Cardはページの取得のみで、本文の読み込みは本記事ではしていません。
出典・参照資料
- 一次資料Introducing Claude Sonnet 5.5 — Anthropic公式 ↗
- 一次資料Claude Sonnet 5.5 — Anthropic公式ドキュメント(モデルID・価格・カットオフ) ↗
- 一次資料What's new in Claude Sonnet 5.5 — Anthropic公式ドキュメント(破壊的変更) ↗
- 一次資料Claude Sonnet 5.5 System Card — Anthropic公式 ↗
- 一次資料Pricing — Anthropic公式ドキュメント(長いコンテキストの価格) ↗
- 一次資料GPT-6 Sol — OpenAI公式ドキュメント(価格の比較用) ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
Claude Opus 5.5が登場 入力4ドル・出力20ドルでOpus 5より2割安、公式ベンチ9項目のうち7項目で首位
Claude Opus 5.5が登場入力4ドル・出力20ドルでOpus 5より2割安、公式ベンチ9項目のうち7項目で首位
 動画
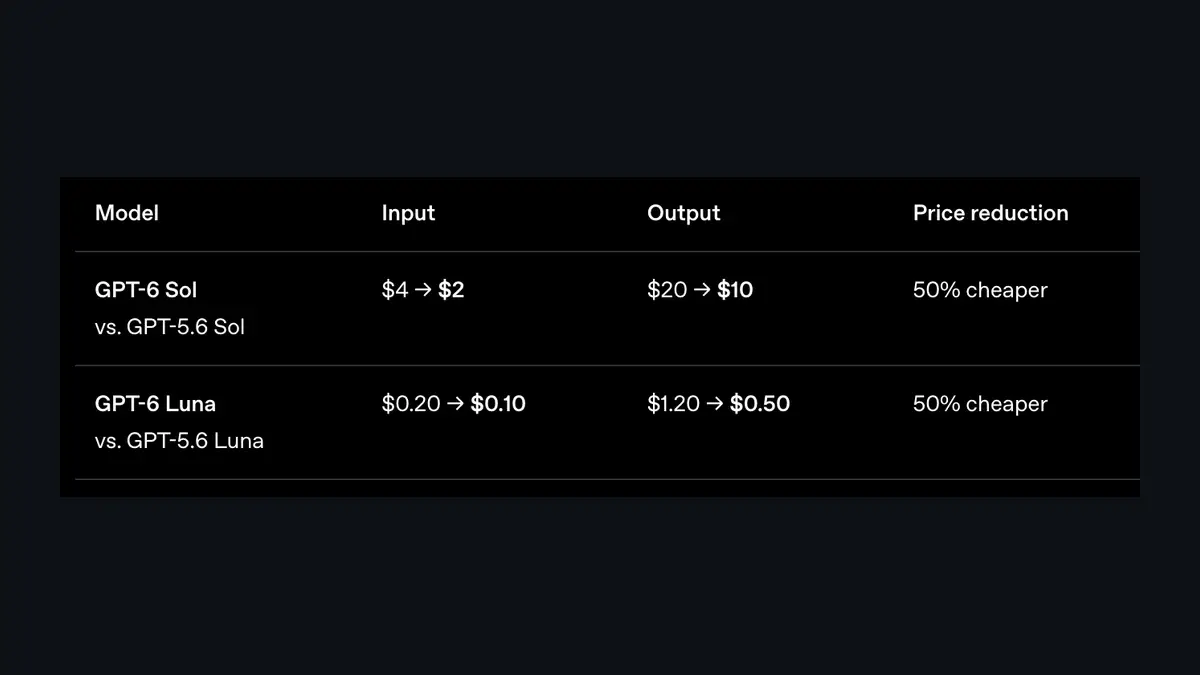
GPT-6 SolとLunaが公開 API価格は5.6世代から半額の入力2ドル/出力10ドル、公式表ではOpus 5のmaxを上回る
GPT-6 SolとLunaが公開API価格は5.6世代から半額の入力2ドル/出力10ドル、公式表ではOpus 5のmaxを上回る
【リーク】Claude Sonnet 5.5、Anthropicがステルステスト中と投稿 提携先には2つ目のチェックポイント、公開は「来週」
【リーク】Claude Sonnet 5.5、Anthropicがステルステスト中と投稿提携先には2つ目のチェックポイント、公開は「来週」
Claude Fable 5.1とは 公開、プラン別の使える条件、料金、公式プロンプトガイド、370年暗号の検算、GPT-6 Astraとの比較まで、当サイトの記事を1ページに(随時更新)
Claude Fable 5.1とは公開、プラン別の使える条件、料金、公式プロンプトガイド、370年暗号の検算、GPT-6 Astraとの比較まで、当サイトの記事を1ページに(随時更新)
GPT-6 Astra vs Claude Fable 5.1 比較 同じ$10/$50で何が違うか。公式ベンチの突合・独立指標・プラン別に使える条件・キャッシュ単価の4倍差を1枚に
GPT-6 Astra vs Claude Fable 5.1 比較同じ$10/$50で何が違うか。公式ベンチの突合・独立指標・プラン別に使える条件・キャッシュ単価の4倍差を1枚に
 動画
Claude Fable 5.1公開 科学研究ベンチが24.7%から52.6%へ、価格据え置きで実質25%安
Claude Fable 5.1公開科学研究ベンチが24.7%から52.6%へ、価格据え置きで実質25%安
Anthropic「Claude Platformで費用を下げつつ性能を上げる3つの直し方」 ①プロンプトキャッシュの命中率(時刻を先頭に置かない、長い処理はTTL1時間)②古いモデル向けの「2回検証しろ」を消す(Opus 5移行で費用14.6%減・精度5.3%増)③effortの較正(低effortのFable 5.1は高effortのFable 5と同等で費用3分の1)
Anthropic「Claude Platformで費用を下げつつ性能を上げる3つの直し方」①プロンプトキャッシュの命中率(時刻を先頭に置かない、長い処理はTTL1時間)②古いモデル向けの「2回検証しろ」を消す(Opus 5移行で費用14.6%減・精度5.3%増)③effortの較正(低effortのFable 5.1は高effortのFable 5と同等で費用3分の1)