Claude Opus 5.5が登場──入力4ドル・出力20ドルでOpus 5より2割安、公式ベンチ9項目のうち7項目で首位
Anthropicが2026年9月22日にClaude Opus 5.5を公開した。入力4ドル/出力20ドルとOpus 5から2割下がり、キャッシュ読み込みは0.5ドルから0.2ドルへ6割下がった。公式ベンチ9項目のうち7項目で首位、AutomationBenchとTerminal-Bench-ScienceはGPT-6 Astraが上。Opus 5で動くコードに影響する破壊的変更が4つある。
目次
Anthropicが現地2026年9月22日、Claude Opus 5.5を公開しました。入力100万トークンあたり4ドル・出力20ドルで、Opus 5の5ドル・25ドルから2割下がっています。公式ベンチマーク9項目のうち7項目で首位に立ち、公式は「ほとんどの作業でClaude Fable 5.1の水準で動き、Opus 5より40%安く動く」としています。モデルIDは claude-opus-5-5、Claude API・Amazon Bedrock・Google Cloud・Microsoft Foundryで公開と同時に使えます。動画でも公式ベンチ9項目と価格表を全部読んでいます(本記事末尾に埋め込み)。
Claude Opus 5.5は入力4ドル/出力20ドル、キャッシュ読み込みは0.5ドルから0.2ドルへ6割下がった。公式は既定設定の典型的な作業でOpus 5比40%安になるとしている。 公式ベンチ9項目のうち7項目で首位。AutomationBench(41.4%対40.0%)とTerminal-Bench-Science 0.1(64.6%対58.7%)はGPT-6 Astraが上回っている。 知識のカットオフは2026年6月で、9月1日公開のClaude Fable 5.1と同じ日付。Opus 5で動いているコードに影響する破壊的変更が4つある。
本記事の数値は2026年9月23日午前・日本時間時点で公式ページに掲載されていたものです。
価格はどこが下がったのか
公式発表に掲載された価格表は次の通りです(100万トークンあたり)。
| 項目 | Claude Opus 5.5 | Claude Opus 5 | 差 |
|---|---|---|---|
| キャッシュ読み込み | $0.20 | $0.50 | −60% |
| 入力 | $4 | $5 | −20% |
| 出力 | $20 | $25 | −20% |
| キャッシュ書き込み(5分) | $5 | $6.25 | −20% |
キャッシュ書き込みの1時間保持版は8ドルです(公式ドキュメントの価格表)。Fast modeはClaude CodeとClaude Platformで利用でき、最大2.5倍の速度で入力8ドル・出力40ドルとなっています。
公式は下げ幅の意味をこう説明しています。
Cache reads (which make up the majority of agentic and coding work costs) are $0.20 per million tokens, 60% less than Opus 5.
(キャッシュ読み込みは──エージェントとコーディングの作業費用の大半を占めるものですが──100万トークンあたり0.20ドルで、Opus 5より60%安くなっています)
単価は2割減ですが、公式は「既定設定での典型的な作業ではOpus 5より40%安くなる」としています。その内訳について公式は「トークンあたりの価格が下がり、かつタスクあたりに使うトークン数も減るため、合わせて40%のコスト低下になる」と書いています。出力の生成速度についても「Opus 5より30%以上速い」としています。
APIの価格とは別に、Pro・Max・Teamプランの5時間あたりの利用上限が引き上げられ、サブスクリプション利用者にはレート制限のリセットが付与されると公式は書いています。
公式ベンチは9項目中7項目で首位、2項目はGPT-6 Astraが上
公式発表の比較表は、Claude Opus 5.5・Claude Fable 5.1・Claude Opus 5・GPT-6 Astra・GPT-5.6 Solの5モデルを9項目で並べています。
| 項目 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1 (Main) | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| GDPval-AA v2.1(Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity's Last Exam(ツール使用) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0(partial) | 81.8% | 80.7% | 74.0% | — | — |
| Chartography(ツール使用) | 89.0% | 88.4% | 83.4% | — | — |
GPT-6 Astraが上回っているのは、業務ワークフローのAutomationBenchと、エージェント型の科学研究にあたるTerminal-Bench-Science 0.1の2項目です。
数値の取り方について、公式は表の直下に条件を書いています。Terminal-Bench 4.0はClaude Opus 5.5がxhigh、GPT-6 Astraがhighの値で、それぞれのモデルの最高スコア同士の比較だとしています。またAutomationBenchについては、Zapierがフォールバックモデル無しで実行したため、安全装置が作動して停止した場合が失敗として数えられており、実際にClaude Opus 5.5が出せる点より低くなったと注記しています。
「一番お金をかけた設定が一番いい」が成り立っていない
公式は精度とコストを同じ軸に並べたグラフも公開しています。ここで目に留まるのは、努力設定(effort)を上げても点数が上がりきらない、あるいは下がる区間があることです。
FrontierCodeについて公式は「既定の努力設定(medium)でClaude Opus 5.5は54.6%を記録し、他のどのモデルよりも高い」と書いています。一方、比較表に載っている値は54.4%で、こちらは最大努力(max)での値です。既定設定のほうが最大設定より高いということになります。
Terminal-Bench 4.0でも同じ構図が見られます。公式は脚注で、Claude Opus 5.5についてはxhighの値を掲載しており、それが同モデルの最高スコアだと書いています。つまりmaxはxhighより下ということです。
コストとの関係についても公式は具体的に書いています。Terminal-Bench 4.0では「既定の努力設定でOpus 5の最大設定を、およそ5分の1のコストで上回る」、GDPval-AA v2.1では「既定の努力設定(medium)でGPT-6 Astraの最大設定を、およそ5分の1のコストで上回る」としています。
Opus 5との差はカットオフに出ている
公式ドキュメントの比較表から、Claude Opus 5との違いを抜き出すと次のようになります。
| 項目 | Claude Opus 5.5 | Claude Opus 5 |
|---|---|---|
| モデルID | claude-opus-5-5 |
claude-opus-5 |
| リリース | 2026年9月22日 | 2026年7月24日 |
| コンテキスト | 1Mトークン | 1Mトークン |
| 最大出力 | 128Kトークン | 128Kトークン |
| 既定の努力設定 | medium |
high |
| 思考 | Adaptive(常時オン) | Adaptive |
| Reliable knowledge cutoff | 2026年6月 | 2026年5月 |
| Training data cutoff | 2026年6月 | 2026年5月 |
知識のカットオフは1か月しか動いていません。ただし注目したいのは、この2026年6月という日付が、9月1日に公開されたClaude Fable 5.1と同じだという点です(公式ドキュメントの比較表で、Fable 5.1もReliable/Training dataとも Jun 2026)。
公式発表はClaude Opus 5.5を「新しいClaude 5.5ファミリーの最初のモデル」と位置づけ、Claude Sonnet 5.5とClaude Haiku 5.5が数週間以内に続くとしています。カットオフの一致と合わせると、Opus 5.5はFable 5.1と同じデータの区切りの上に立っていて、Opus 5が前の区切りの最後だった、という読み方はできます。ただしこれは本記事の解釈で、Anthropicはバージョン番号の意味も、学習の構成も公開していません。
Opus 5で動いているコードに影響する変更が4つある
公式ドキュメントは、Claude Opus 5で動作しているコードに影響する破壊的変更を4つ挙げています。
- 思考を無効化できない(
thinkingを無効にする指定が通らない) - 強制的なツール使用がエラーを返す
- 思考ブロックがモデルと会話に紐づく(別のモデルへ渡せない)
computer_20251124の旧コンピュータ使用ツールが受け付けられない(Claude APIとGoogle Cloud)
公式は、このうち最初の3つはClaude Fable 5.1にも適用されると書いています。
加えて、リクエストが失敗しないまま応答の形が変わる変更が1つあります。公式ドキュメントの記述はこうです。
text between tool calls comes back in
thinkingblocks whose text is empty at the defaultdisplaysetting. An application that streams that text to its users as progress updates goes quiet between tool calls until it sets adisplayvalue that returns the text.(ツール呼び出しの間のテキストが
thinkingブロックで返るようになり、既定のdisplay設定ではそのテキストが空になります。そのテキストを進捗表示としてユーザーへ流しているアプリケーションは、テキストを返すdisplay値を設定するまで、ツール呼び出しの間は無言になります)
エラーが出ないぶん、気づくまでに時間がかかる種類の変更です。
安全の記述は「ペース調整を呼びかけて以来の最初のリリース」から始まっている
公式発表は、安全に関する説明を次の一文から始めています。
Claude Opus 5.5 is our first release since we called for pacing the frontier.
(Claude Opus 5.5は、私たちがフロンティアのペース調整を呼びかけて以来、最初のリリースです)
公開前に外部の評価者としてFrontier DesignとMETRがテストに入ったこと、社内で最も網羅的なアライメントテストである自動行動監査(automated behavioral audit)でこれまでで最高のスコアだったことを公式は挙げています。プロンプトインジェクションについては、AIセキュリティ企業Gray Swanのベンチマークで、Claude Fable 5.1と並んでテストされた中で最も成功率が低かったとしています。
一方で、生物とサイバーセキュリティの能力はClaude Mythos 5.1と同等と判定されたため、Claude Fable 5.1と同じ安全装置を付けて提供するとしています。サイバーセキュリティの作業の大半はClaude Opus 4.8へ再ルートされ、研究用途で制限に当たる場合はLife Sciences Verification ProgramやCyber Verification Programへの申請という経路が案内されています。
公開の約40分前、Anthropicが配った実行ファイルに答えが入っていた
ここは筆者が手元で確かめたことです。
公式発表が出る前に、npmの @anthropic-ai/claude-code の先行配布チャンネル(next タグ)に 2.1.280 が上がっていました。公開時刻は2026年9月22日15時44分39秒(UTC)、日本時間では9月23日の0時44分です。このバージョンのmacOS向け実行ファイルを取得して文字列を調べたところ、claude-opus-5-5 が39か所、Opus 5.5 が17か所含まれていました。ひとつ前の latest(2.1.278)には0件です。
埋め込まれていたモデル定義には、価格の区分名として tier_4_20_cache_read_0_20 が入っていました。同じファイル内でClaude Opus 5は tier_5_25、Claude Fable 5は tier_10_50、Claude Fable 5.1は tier_10_50_cache_read_0_25 となっており、これらはいずれも公開済みの公式価格(5ドル/25ドル、10ドル/50ドル、10ドル/50ドル・キャッシュ読み0.25ドル)と一致します。この命名規則のまま読めば4ドル/20ドル・キャッシュ読み0.20ドルで、約40分後に出た公式発表の価格表と同じ値でした。
再現手順は次の通りです。
curl -s https://registry.npmjs.org/@anthropic-ai/claude-code   # dist-tags を見る
curl -sL <claude-code-darwin-arm64 の tarball> | tar xz
strings -a package/claude | grep claude-opus-5-5
これはリークや又聞きではなく、Anthropic自身が公開の場に置いた配布物です。とはいえ先行チャンネルの内容が最終的な公式発表と一致する保証はないため、本記事の価格・仕様の数値はすべて公式発表と公式ドキュメントの記載を出典としています。
この記事で確かめられなかった3点
- Opus 5.5 System Cardの中身。公式発表からリンクされていますが、本記事は分量の都合で読み込んでいません。安全評価の詳細はそちらにあります。
- 公式ドキュメントの「What's new in Claude Opus 5.5」ページ。執筆時点ではまだ公開されておらず(404)、破壊的変更の詳細は
overviewページの記述と移行ガイドから取っています。 - 実際に使った体感。本記事は公式が出した数値と記述の整理に絞っています。公式自身が「この能力水準では、ベンチマークの差が実世界の差の目安として当てにならなくなってきた」「自分たちの利用では、Opus 5.5とClaude Fable 5.1の差はスコアが示すほど開いていない」と書いていることも、そのまま付記しておきます。
出典と、確認できた範囲について
本記事の数値はすべて、Anthropicの公式発表ページと公式ドキュメント(モデルページ・価格ページ・提供終了予定ページ)に掲載されていたものです。リリース日は公式ドキュメントの Released 欄の記載によります。他社モデルの数値はAnthropicの公式発表に掲載されたもので、その取得条件は公式の脚注に記載があります。
Claude Opus 5.5とClaude Fable 5.1のカットオフが同じ日付であることは公式ドキュメントの記載ですが、そこから「同じデータの区切りの上に立つ兄弟モデルではないか」と読んだ部分は本記事の解釈であり、Anthropicはそのような説明をしていません。
価格・仕様は今後変更される可能性があります。続報があり次第、本記事を更新します。
動画では、公式ベンチの9項目と価格表、精度とコストのグラフを順に読んでいます。数字を目で追いたい方はそちらもどうぞ。
出典・参照資料
この記事の解説動画
YouTubeで見る ↗AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事

Claude Opus 5が登場──価格据え置きでFable 5級の知能、アライメントは歴代最高
Claude Fable 5.1公開──科学研究ベンチが24.7%から52.6%へ、価格据え置きで実質25%安

Claude・GPT・Gemini API料金の読み方──2026年8月27日に公式ページで確認した単価早見表
Claude Fable 5.1とは──公開、プラン別の使える条件、料金、公式プロンプトガイド、370年暗号の検算、GPT-6 Astraとの比較まで、当サイトの記事を1ページに(随時更新)
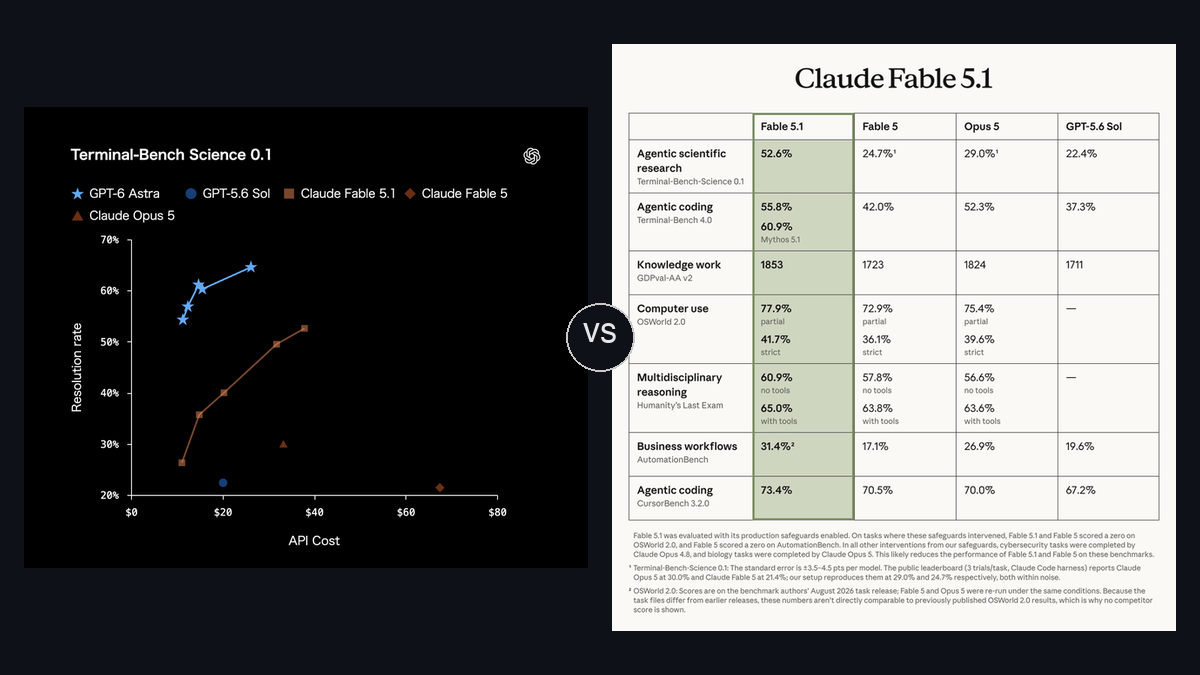
GPT-6 Astra vs Claude Fable 5.1 比較──同じ$10/$50で何が違うか。公式ベンチの突合・独立指標・プラン別に使える条件・キャッシュ単価の4倍差を1枚に
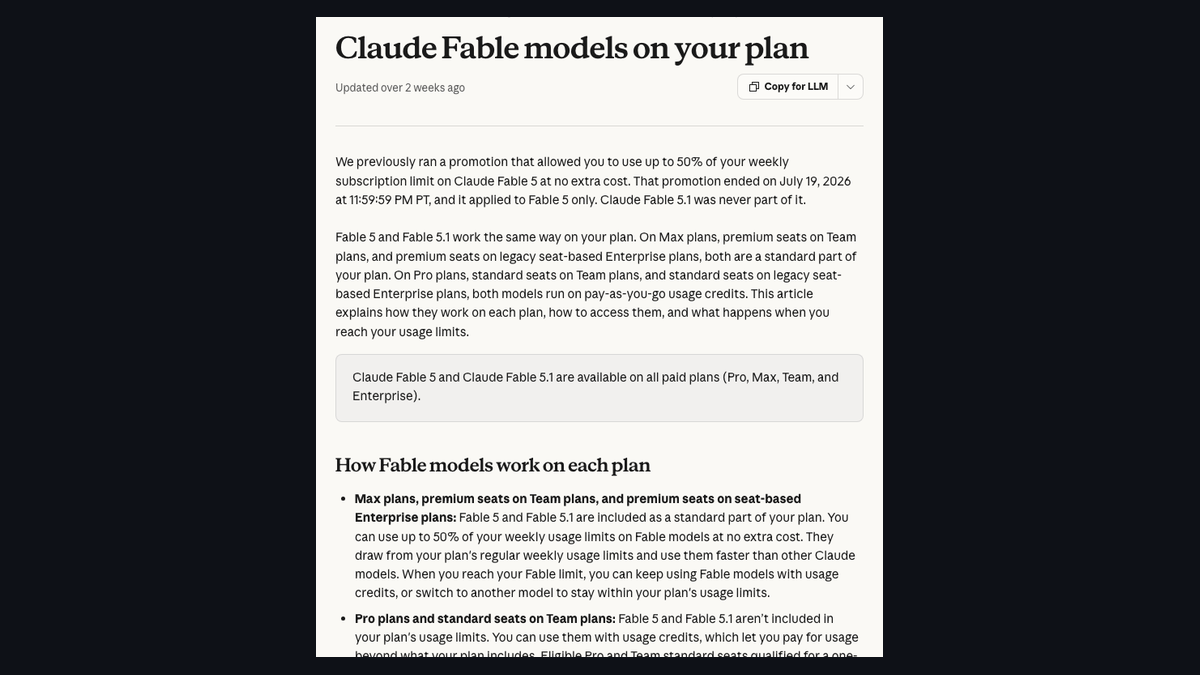
Claude Fable 5.1の使い方──どのプランで使えて、上限に当たるとどうなり、遮断されたら何が起きるか(Pro・Max・Claude Code・API)
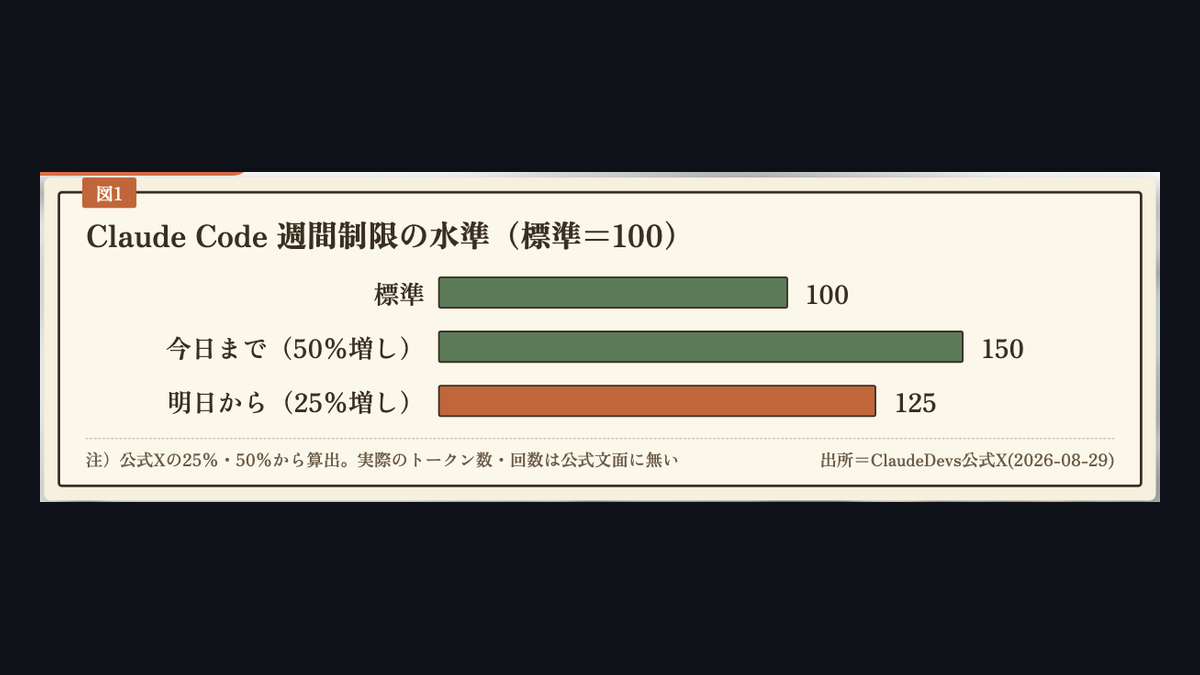
Claude Codeの週間上限、9月14日から恒久+25%に──+50%キャンペーンは9月13日で終了、Anthropic公式が「今日と比べて17%減」と明記