Anthropic「Claude Platformで費用を下げつつ性能を上げる3つの直し方」①プロンプトキャッシュの命中率(時刻を先頭に置かない、長い処理はTTL1時間)②古いモデル向けの「2回検証しろ」を消す(Opus 5移行で費用14.6%減・精度5.3%増)③effortの較正(低effortのFable 5.1は高effortのFable 5と同等で費用3分の1)
AnthropicのLance Martin氏は2026年9月8日、Claude Platformで費用と性能はトレードオフではないとして3つの直し方をまとめ、Claude Codeのclaude-apiスキルに組み込んだ。①プロンプトキャッシュ:KVキャッシュはモデルに固定・バイト単位で一致・TTLあり。effortの設定を途中で変えない、時刻やIDを先頭に置かない、ツール定義の順序を変えない、5分を超える処理はTTLを1時間に。Consoleのキャッシュ診断、defer_loading、max_tokens: 0での事前加温。②指示:「2回検証しろ」「最大限に徹底しろ」、固定手順、古い少数例、矛盾する規則、廃止された思考設定は最前線モデルで逆効果。Opus 4.8→Opus 5の移行で/claude-api prompt-auditにより費用14.6%減・精度5.3%増。③effort:Fable 5.1のHLEは最後の一段が費用46%増で約0.5点。CursorBench 3.2では低effortのFable 5.1が高effortのFable 5と同等で費用3分の1。
2026年9月18日・日本時間時点の情報です。 claude.comのブログ(9月8日)を読んだ。当サイトのAI APIの料金ガイドは単価の話で、「同じ単価でどう安く回すか」はこの記事が具体的なので残す。effortの基本はOpus 4.8のeffort制御に。
3行まとめ
- プロンプトキャッシュ。 応答前にプロンプトを内部状態に変換するプリフィルが入力側の高い部分で、その状態(KVキャッシュ)を保存して同じ接頭辞なら読み戻す。読み取りは全額の一部の課金。守るべき性質は3つ──モデルに固定・バイト単位で一致・TTLあり。よくある失敗は、effortや思考の設定を会話途中で変える(設定は内容より前に描画される。Opus 5とFable 5.1は途中変更可)、時刻やIDをシステムプロンプトに置く、ツール定義の順序が変わる、分岐やサブエージェントが同一プレフィックス・同一モデル・同一effortでないのに共有を期待する、5分のTTLを超える同期ツール呼び出しやサブエージェント(次のターンで書き直し=通常入力の1.25倍、1時間キャッシュなら2倍)。直し方は、Consoleのキャッシュ診断(2つの要求がどこで分岐したかを示す)を見る、稀にしか使わないツールはdefer_loadingで接頭辞の外に出しツール検索で読ませる、システム指示の更新はメッセージとして追加、静的部分→会話の順に並べる、コンパクションのように既に壊れる場面でモデルやeffortを変える、自動キャッシュで区切りを最後のブロックへ、max_tokens: 0で入力中に事前に温める、長い処理はTTLを1時間に。
- 指示の負の遺産。 古いモデルの弱点を塞ぐために積んだ指示が、最前線モデルでは逆効果になる。「2回検証しろ」のような検証の儀式(文字通り実行してトークンを浪費)、「最大限に徹底しろ」「CRITICAL: YOU MUST ALWAYS」の強調(冗長化と余計なツール呼び出し)、「スクラッチパッドで段階的に」の固定手順(内蔵の推論の上に重なる)、古い失敗に合わせた少数例、矛盾する規則(「方針内なら常に返金」と「エスカレーションなしに返金するな」)、廃止された思考予算の設定(APIに拒否される)。Claude Codeで**/claude-api prompt-auditを走らせると作業ディレクトリ内のプロンプト・スキル・ツール説明・CLAUDE.mdを点検する。実験では顧客対応ベンチで清潔なプロンプトに負の遺産を1つずつ植えた6本を、Opus 4.8→Opus 5でモデルIDだけ変えた場合と、監査後で比較。監査後は費用14.6%減・精度5.3%増**(廃止設定でルーティング要求が全部拒否、矛盾規則で返金4件を保留、手動スクラッチパッドと内蔵思考が衝突して3件でツール呼び出しを推論内に書いて実行しなかった、が原因)。
- effortの較正。 effortは「どれだけ頑張るか」で、曲線はモデルと課題で違う。Fable 5はFrontierCode Diamond(最難50問)で低11.5%(5.35ドル/課題)→最高30.9%(19.00ドル)、約2.7倍の得点に約3.5倍の費用。Fable 5.1のHumanity's Last Exam(ツールなし)は低約53%(0.30ドル/問)→最高約61%(2.23ドル)で、最後の一段は費用46%増で約0.5点(実行ごとの雑音の範囲)。高すぎれば考えすぎで費用と遅延が増え質も落ち、低すぎれば1件目の検索結果で答えて「完成に見えるが不完全」になる。直し方は、強いモデルを低effortで試す(CursorBench 3.2で低effortのFable 5.1が高effortのFable 5と同等、費用は3分の1。5.1のキャッシュ読み取りは100万トークン0.25ドル対5の1.00ドル。同価格でも約40%安い)、effortの掃引で曲線が平らなら思考量に縛られていない課題と判断。/claude-api hillclimbは評価を訓練・テストに分けて設定変更を提案し、失敗例を読んで直す。顧客対応ベンチでOpus 4.8既定(高)から始め、Opus 5低effort+監査で訓練精度98.9%・1件2.6セント。
効果が一番大きいのは指示の掃除
- 一番効果が出やすいのは②で、「モデルを上げたのに費用が増えた」の原因がプロンプトの古い儀式にある、という指摘。CLAUDE.mdやスキルに書いた「必ず2回確認」の類は、筆者の環境にも心当たりがある
- キャッシュの並べ方はコマースエージェントの設計図の「グローバル→セッション→揮発」と同じ話で、9月にAnthropicが2本で繰り返している
- OpenAI側の同種の落とし穴はプロンプトキャッシュが働かない時に。ツール定義の途中変更は会話途中のツール変更
- 数字はすべてAnthropicの自社ベンチマークと自社課金での計算
14.6%減・5.3%増を原文で確認
この記事の下調べで、筆者は9月18日にclaude.comのブログを取得し、キャッシュの3性質・1.25倍/2倍・6つの負の遺産・14.6%/5.3%・effortの各数字(11.5%/30.9%・5.35/19.00ドル・53%/61%・0.30/2.23ドル・46%・0.25/1.00ドル・98.9%・2.6セント)がその原文にあることを確認した。claude-apiスキルのリポジトリとキャッシュ診断APIの文書は開いていない。筆者は自分のプロンプトで/claude-api prompt-auditを走らせていない。
hillclimbの費用や診断APIの条件は不明
- /claude-api hillclimbの探索にかかる費用
- キャッシュ診断APIの利用条件
- 顧客対応ベンチマークの中身
出典はclaude.comのブログ
- Reducing cost and improving performance with Claude Platform(Anthropic・Lance Martin・2026年9月8日)
関連記事
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Claude・GPT・Gemini API料金の読み方 2026年8月27日に公式ページで確認した単価早見表
Claude・GPT・Gemini API料金の読み方2026年8月27日に公式ページで確認した単価早見表
Claude Opus 4.8登場、回答の「がんばり度」を選べるEffort Controlを追加
Claude Opus 4.8登場、回答の「がんばり度」を選べるEffort Controlを追加
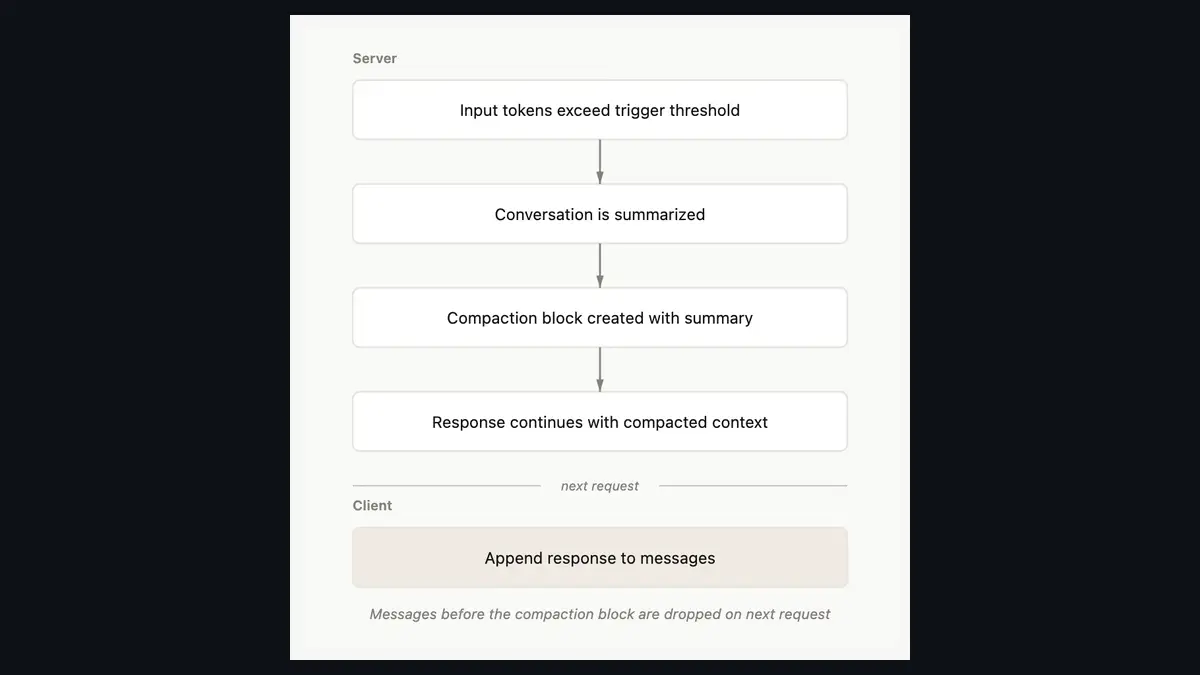
Claude APIに「任意のタイミングで会話を圧縮する」オンデマンド圧縮(ベータ) 署名付きの要約ブロックを返し、直近の会話は原文のまま残せる。しきい値型との違い、課金の見方、失敗時の挙動
Claude APIに「任意のタイミングで会話を圧縮する」オンデマンド圧縮(ベータ)署名付きの要約ブロックを返し、直近の会話は原文のまま残せる。しきい値型との違い、課金の見方、失敗時の挙動
Claude APIが会話の途中でツールセットを変えられるようになった プロンプトキャッシュを保ったまま
Claude APIが会話の途中でツールセットを変えられるようになったプロンプトキャッシュを保ったまま
Anthropicが「コマースエージェント」の設計図を公開 Claudeの買い物エージェントはカートが最大35%大きく購入完了が60%高い(小売各社の実績)。要点は「サブエージェントでなくスキル」「UI部品はツール」「3分の1超のトラフィックが使う指示はシステムプロンプト」「プロンプトキャッシュは90〜99%命中を最初から設計」。Visa・Mastercard・Shopify等がコメント
Anthropicが「コマースエージェント」の設計図を公開Claudeの買い物エージェントはカートが最大35%大きく購入完了が60%高い(小売各社の実績)。要点は「サブエージェントでなくスキル」「UI部品はツール」「3分の1超のトラフィックが使う指示はシステムプロンプト」「プロンプトキャッシュは90〜99%命中を最初から設計」。Visa・Mastercard・Shopify等がコメント
プロンプトキャッシュが効いていない時のサイン OpenAI公式ドキュメントが認める「キャッシュが逆に高くつく」5パターン
プロンプトキャッシュが効いていない時のサインOpenAI公式ドキュメントが認める「キャッシュが逆に高くつく」5パターン
Claude Code、autoモードのclassifierがAPI/Enterprise/Bedrock/Vertex/Foundryでもサーバー側実行に既定変更 オーバーヘッド課金なし(v2.1.278)
Claude Code、autoモードのclassifierがAPI/Enterprise/Bedrock/Vertex/Foundryでもサーバー側実行に既定変更オーバーヘッド課金なし(v2.1.278)