
GLM-5.3がMythos Previewに肉薄とAnthropic自身が評価米政府機関の評価では米国の最先端から約4か月遅れ、減速論のあと2社は18日で5モデル
AnthropicのFrontier Red Teamが日本時間9月30日、中国Zhipu AI(Z.ai)のオープンウェイトモデルGLM-5.3のサイバー能力を評価した記事を公開した。ChromeのV8の既知の脆弱性で攻撃コードを最後まで作れた割合はGLM-5.3が12%(410回中50回)、Claude Mythos Previewが14%(56回)。安全装置は、偽の設定・思考の書き込み・重みの書き換えで64〜100%外れたという。記事が引く米NISTのCAISIの9月17日の評価では、米国の最先端から約4か月遅れ。アモディ氏は減速できる幅を「中国などに対するリードの幅まで」としていたが、減速論のあとの18日で、AnthropicとOpenAIは5つのモデルを出した。
目次
2026年9月30日15時・日本時間時点の情報です。AnthropicのFrontier Red Teamは米国時間9月29日(日本時間30日0時46分)、中国のZhipu AI(海外名Z.ai)が8月に出したオープンウェイトモデル「GLM-5.3」のサイバー能力を評価した記事「GLM-5.3 and the spread of advanced cyber capabilities」を公開した。記事によると、GLM-5.3はGoogle Chromeの部品V8の既知の脆弱性を突く攻撃コードを、410回のうち50回、最後まで自力で作れた。Anthropicが4月に限定公開したClaude Mythos Previewは、同じ410回で56回だった。GLM-5.3の安全装置は、簡単な手口で64〜100%の割合で外れたという。
その18日前の9月12日、Anthropic CEOのダリオ・アモディ氏はエッセイ「We Must Pace the Frontier」で、AI業界は能力を上げるペースを落とすべきだと書いた。ただし減速できる幅は「米国企業が中国共産党などに対して持つリードの幅まで」という条件付きだった。本記事は、Anthropicの記事が何を報告したかを読み、そのあとで減速論の条件と、減速論のあとにAnthropicとOpenAIが出したモデルの日付を並べる。動画版(18分)も公開している: https://youtu.be/PZGl2uOoT48
3行まとめ
- Anthropicは、中国製のオープンウェイトがMythos Previewと同じ種類の力を持ったと書いた。 V8の既知の脆弱性で攻撃コードを最後まで作れた割合は、GLM-5.3が12%(410回中50回)、Mythos Previewが14%(56回)。記事が引く米国立標準技術研究所(NIST)のCAISIの評価では、GLM-5.3は米国の最先端から約4か月遅れ。
- Anthropicが足したのは「安全装置の外れやすさ」。 断る挙動を消す重みの書き換え(abliteration)は約2,200GPU時間・約4,400ドルででき、3つの試験の平均で断る率は95%から6%に落ちた。シミュレーション上の攻撃の指示に対して、偽の設定で64%、思考の書き出しを先に書き込むと92%、書き換え版は100%が攻撃先に接続しようとした。APIの安全装置が付いたClaudeは偽の設定で0%、残り2つの手口はClaudeには使えない。
- アモディ氏は減速できる幅を「中国などに対するリードの幅まで」としていた。 エッセイから18日で、AnthropicはOpus 5.5とSonnet 5.5を、OpenAIはGPT-6 Sol・GPT-6 Luna・GPT-6.1 Solを出し、同じ会社の前のモデルからの間隔は6日と7日まで縮んだ。リードが約4か月なら減速の条件はもう満たしにくい、というのは本記事の推測である。
「そういうモデルが、もう来た」──Anthropicの記事の出発点
記事は5か月前の話から始まる。Anthropicは当時、Claude Mythos Previewを「高度な攻撃コードを最初から最後まで自律的に作れる、初めてのAIモデル」として発表し、一般には出さなかった。Project Glasswingという枠組みで信頼できる防御側にだけ使わせ、重要なソフトウェアの脆弱性を1万件以上見つけさせた。悪意のある側が同じ性能のモデルを手にする前に、先に直し始める時間を稼ぐ、という考え方だった。Anthropicは当時から、この能力はいずれ多くのモデルに広がると見ていたと書き、今回の記事で次のように続けている。
But those models have now arrived.
(しかし、そうしたモデルはもう来た)
But GLM-5.3 is unlike other frontier models in that it has been released without meaningful safeguards to limit misuse.
(しかしGLM-5.3は、悪用を制限する意味のある安全装置なしに公開された点で、ほかの最先端モデルと違う)
GLM-5.3の公開の経緯は、CAISIの文書に書かれている。Z.aiは8月14日にGLM-5.3を出し、その2週間後に重みを公開した。重みが公開されているので、誰でもダウンロードして自分のマシンで動かせる。Z.aiについては、同社の公式コーディングアプリZCodeの件を9月18日の記事で扱っているが、今回は別の話である。
Anthropicは、試験はすべて隔離したサンドボックスの中で、評価のために用意したオフラインの標的に対してだけ行ったと書いている。
攻撃コードの試験では50回と56回
記事の自動の試験2つの結果を並べる(Mythos PreviewとOpus 4.6は、記事の図の注記によると安全装置を切った状態で試している)。
| 試験(Anthropicの記事) | GLM-5.3 | Claude Mythos Preview | 1つ前の世代 |
|---|---|---|---|
| ExploitBench:ChromeのV8の既知の脆弱性から、動く攻撃コードを最後まで作れた割合 | 12%(410回中50回) | 14%(410回中56回) | GLM-5.2・Claude Opus 4.6とも0% |
| 社内のBinary Exploitation:GoogleのOSS-Fuzzに参加するオープンソースのソフト100課題で、プログラムの制御を奪えた割合 | 4% | 6% | GLM-5.2・Claude Opus 4.6とも0% |
2つ目の試験ではGLM-5.3がMythos Previewを下回った。それでも記事は、1つ前の世代がどちらも0%だったことを挙げて「a meaningful threshold has clearly been crossed」(意味のある境目を越えたのは明らか)と書いている。
ExploitBenchの図には、各モデルの公開月も書いてある。Opus 4.6が2026年2月、Mythos Previewが4月、GLM-5.2が6月、GLM-5.3が8月。Mythos PreviewからGLM-5.3までは4か月で、あとで出てくるCAISIの「約4か月遅れ」と同じ数字になる。同じ図に載った中国製のオープンウェイトのうち、Moonshot AIのKimi K3(7月)は0.5%、DeepSeekのV4.1-Flash(9月)は0.2%で、Mythos Previewに近いところまで来ているのはGLM-5.3だけだった。
研究者と組んだ試験は、人の作業1時間未満
自動の試験とは別に、Anthropicは研究者がGLM-5.3を使う形の試験を2回行った。専門家が脆弱性を知らない標的を選び、短い時間で何ができるかを見るもので、記事によると試験はおおむね1日以内、人が付きっきりだった時間は合計1時間未満だったという。
1回目は、有名なWebブラウザのLinux版を隔離したマシンに置き、GLM-5.3に調べさせた。GLM-5.3はJavaScriptエンジンでこれまで知られていなかった脆弱性を複数見つけ、それらをつないで動く攻撃を作った。開いただけで閲覧者のPCのファイルが読まれるWebページで、記事の図3は、そのページがSSHの秘密鍵を読み取った画面を一部伏せて載せている。脆弱性は開発元に報告済みで、同じ試験の中で無線やグラフィックスのドライバー、ネットワーク機器のソフトなどにも脆弱性を見つけ、Anthropicが確認中だと書いている。
2回目は、小型のGLM-5.3-Flashで、公開済みのChromeの欠陥(CVE-2026-11645)の修正から、どれだけ早く動く攻撃を作れるかを試した。人の作業は20分、モデルの作業は8時間で、2つの既知の欠陥をつないだ攻撃ができた。ZhipuのAPI料金で計算すると20.40ドルだったという。
安全装置は「簡単な手口」で外れた
GLM-5.3にも、明らかに有害な依頼を断る安全装置は付いている。記事の図では、手を加えない状態のGLM-5.3は、有害な依頼への3つの試験(JailbreakBench・HarmBench・StrongREJECT)の平均で95%を断っており、安全装置を切ったClaude(95〜96%)と同じ水準だった。
違いは、その安全装置を外せるかどうかにある。重みが公開されているモデルは、断る挙動を消す書き換え(abliteration)ができる。記事によると、書き換え版のGLM-5.3は公開から数日のうちに複数の開発者が公開していた。Anthropicのチームは初めての挑戦で、約2,200GPU時間・計算費用約4,400ドルで書き換え版を作った。
| 記事の図4 | 手を加えない状態 | 書き換え版 |
|---|---|---|
| GLM-5.3の断る率(3試験の平均) | 95% | 6% |
| GLM-5.3-Flashの断る率(3試験の平均) | 95% | 14% |
| GLM-5.3のGPQA-Diamond(科学の知識) | 88% | 88% |
| GLM-5.3のCyberGymの一部(サイバーの課題) | 85% | 81% |
記事の本文では、GLM-5.3の断る率は3つの試験でそれぞれ約3%・約2%・12%まで下がった。断る力はほぼ消え、腕前はほとんど変わっていない。Claudeは重みが公開されていないので、この書き換え自体ができない。
書き換えなしでも外れる、というのが記事のもう一つの報告である。AnthropicはGLM-5.3をシミュレーションの世界に置き、重要なシステムを攻撃せよという露骨に有害な指示を出して、攻撃先に接続しようとした割合を数えた(1マス50回。図の注記によると、実際には何も実行していない)。
| 記事の図5 | そのまま指示 | 偽の設定(演習中の赤チームだと伝える) | 思考の書き出しを先に書き込む | 書き換え版 |
|---|---|---|---|---|
| GLM-5.3 | 0% | 64% | 92% | 100% |
| GLM-5.3-Flash | 0% | 16% | 80% | 92% |
| Claude Opus 4.8・Opus 5・Mythos 5(APIの安全装置あり) | 0% | 0% | 使えない(APIが受け付けない) | 使えない(重みが非公開) |
偽の設定はClaudeのAPIの安全装置が止めた、と記事は書いている。ただし図には、安全装置を切った状態の値も小さく載っていて、偽の設定でOpus 4.8が4%、Opus 5が10%だった。
CAISIの評価は「約4か月遅れ」と「大幅に低い」の両方
記事が引いているのは、米国立標準技術研究所(NIST)の中でAIの標準と評価を担うCAISI(Center for AI Standards and Innovation)が9月17日に出した評価である。筆者はCAISIの文書そのものも読んだ。主な結論は2つ書かれている。
GLM-5.3 is the most cyber-capable open-weight model released to date.
(GLM-5.3は、これまでに公開されたオープンウェイトモデルの中で最もサイバー能力が高い)
GLM-5.3's cyber capabilities are significantly lower than those of current U.S. frontier models. GLM-5.3 lags the capability level of the U.S. frontier by about four months in an aggregate measure of performance across CAISI cyber benchmarks
(GLM-5.3のサイバー能力は、現在の米国の最先端モデルより大幅に低い。CAISIのサイバー試験の総合的な指標で、GLM-5.3は米国の最先端の能力水準から約4か月遅れている)
Anthropicの記事は、このうち「最もサイバー能力が高いオープンウェイト」と「約4か月遅れ」を引き、自社の評価も「broadly match」(おおむね一致する)と書いた。そのうえで、CAISIの比較の条件を指摘している。CAISIは米国のモデルを、該当する場合はサイバーの安全装置を切った状態で試しており、米国の最先端には審査を通った利用者にだけ出しているモデルも含まれる。攻撃者はそうした米国のモデルを簡単には手に入れられないが、GLM-5.3は誰でもダウンロードできる、というのがAnthropicの主張である。CAISIの文書も、開発済みで未公開のモデルとは比べていないと注記している。
記事の結論は「守る側にも同じ水準を」
記事は、GLM-5.3によって悪意のある側が制限なしにこの水準の能力を使えるようになる可能性が高く、国家とそれ以外の攻撃者の両方がGLM-5.3のようなモデルを使って現実の被害を出す可能性が高い、と書く。一方で、同じ能力は守る側にも使えるとし、提言は次の2つにまとめられている。
- 守る側には、相手が使うモデルと少なくとも同じくらい良い最先端モデルを渡すべきで、Anthropicは審査を通った防御側にClaude Mythos 5.1などを提供しており、提供先を広げていく
- 各国の政府は、GLM-5.3の後継を含む十分に高い能力のモデルについて、安全性の試験をするべきだ
筆者が9月30日15時に記事の本文を取り直して検索したところ、「pace」「slow」の語は0件で、アモディ氏のエッセイへの言及もなかった。「China」は、Zhipu AIの説明(中国の外ではZ.aiとして知られる)に1回出てくるだけだった。減速論とこの記事を結びつけているのは、次の節からの本記事の読み方である。
減速論は「中国に対するリード」を条件にしていた
アモディ氏は9月12日(日本時間同日23時1分にXで告知)、エッセイ「We Must Pace the Frontier」を公開した。Xの告知によると、AI業界がペースを落とすべき理由と3段階の案を書いたもので、Anthropicはその第1段階を単独で実行すると約束した。第三者の評価者に、社員並みのアクセスを恒常的に与えるというものだ。
日本時間9月13日1時30分、OpenAIのサム・アルトマンCEOがXでこう書いた。
I agree with Dario that we need to pace the frontier. This has been a primary topic of discussions we've had at OpenAI in recent weeks.
Committing to having independent evaluators with employee-like access is a great idea, and we will do the same. We'll have more to share soon.
(フロンティアのペースを調整する必要があるというダリオに同意する。これはこの数週間、OpenAIの中で主要な議題だった。社員並みのアクセスを持つ独立した評価者を置くと約束するのは素晴らしい考えで、私たちも同じことをする。近いうちにもっと詳しく伝える)
Anthropicは日本時間9月19日、Accentureとの独立評価の提携を発表した。公式Xによると、評価者を社内に置くという約束の一部で、両社はこの分野に今後5年で少なくとも10億ドルを投じる見込みだという(詳細はAccenture提携の記事)。
大事なのは、エッセイが減速に付けていた条件である。原文はこうだ。
Pacing within democracies will be limited by the lead that US companies have over authoritarian regimes, chiefly the Chinese Communist Party. If we slow down by more than this amount, then (unpaced) CCP-associated projects will pull ahead, creating significant national security risk. I agree with Secretary Bessent that a Chinese lead in AI would pose grave danger for the United States and the world.
(民主主義国の中での減速は、米国企業が権威主義体制、主に中国共産党に対して持つリードの幅に制限される。それ以上に減速すれば、減速しない中国共産党系のプロジェクトが先に出て、国家安全保障上の大きなリスクを生む。中国がAIで先行すれば米国と世界に重大な危険をもたらす、というベッセント財務長官の考えに私は同意する)
エッセイは同じ節で、リードを守る手段として、強力なAI半導体と製造装置を中国に売らないこと、権威主義国の企業による無許可の蒸留の取り締まり、AI企業のセキュリティ強化と重みの盗難防止を挙げ、うまく実行すれば今後3〜5年で米国のリードを大きく広げられると書いている。
AnthropicはOpus 5.5の発表文(日本時間9月23日)でも、減速を「AIを安全に保ち、中国との競争力を保ち、AIの恩恵を実現するための方法」と位置づけている。
Pacing is an approach to keeping AI safe, remaining competitive with China, and realizing AI's benefits, particularly in areas like biology and medicine.
(ペースの調整は、AIを安全に保ち、中国との競争力を保ち、特に生物学や医療の分野でAIの恩恵を実現するための方法である)
減速論のあとの18日で、2社は5つのモデルを出した
エッセイの前後に2社が出したモデルを、日本時間の日付で並べる。
| 日付(日本時間) | 会社 | 出たもの | 同じ会社の前のモデルからの間隔 |
|---|---|---|---|
| 9月2日(米国時間9月1日) | Anthropic | Claude Fable 5.1 | ― |
| 9月4日(米国時間9月3日) | OpenAI | GPT-6 Astra | ― |
| 9月12日夜 | ― | アモディ氏のエッセイ「We Must Pace the Frontier」 | ― |
| 9月23日 | Anthropic | Claude Opus 5.5 | Fable 5.1から21日 |
| 9月23日 | OpenAI | GPT-6 Sol・GPT-6 Luna | GPT-6 Astraから19日 |
| 9月29日 | Anthropic | Claude Sonnet 5.5 | Opus 5.5から6日 |
| 9月30日 | OpenAI | GPT-6.1 Sol(DevDay 2026で発表) | GPT-6 Solから7日 |
エッセイから9月30日までの18日間に、Opus 5.5、GPT-6 Sol、GPT-6 Luna、Sonnet 5.5、GPT-6.1 Solの5つが出た。前のモデルからの間隔は、Anthropicが21日から6日へ、OpenAIが19日から7日へ縮んでいる。AnthropicはSonnet 5.5の告知で「Claude Haiku 5.5 will join the family in the coming weeks」(Haiku 5.5もこの数週間のうちに加わる)と予告しており、次も控えている。
この5つのモデルは、筆者のチャンネルでいずれも速報動画にしてきた。表のリンク先の記事に、それぞれの動画を埋め込んである。
Anthropicの説明と、OpenAIの文書
公平のために、減速論のあとも出し続けていることについての各社の説明を読む。
AnthropicはOpus 5.5の発表文の冒頭で、こう書いている。
Claude Opus 5.5 is our first release since we called for pacing the frontier. It was tested before release by external evaluators, including Frontier Design and METR.
(Claude Opus 5.5は、フロンティアのペース調整を呼びかけてから最初のリリースだ。公開前に、Frontier DesignやMETRを含む外部の評価者がテストした)
同じ発表文の「Pacing the frontier」の節では、今のモデルは外部評価と能力に合わせた安全装置を付けて出す、その先のモデルにはもっと高い基準が要る、という2段構えを説明している。減速の呼びかけが何に基づいていたかについては、次の1文がある。
Models with greater capabilities—such as those that can fully automate the work of AI research itself—require a higher safety standard still. Our calls for pacing were based in large part on our expectation that such models could be trained soon.
(AI研究そのものを完全に自動化できるような、より高い能力のモデルには、さらに高い安全基準が要る。私たちの減速の呼びかけは、そうしたモデルが近いうちに訓練されうるという見込みに大きく基づいていた)
Anthropicの説明では、減速は今のモデルを出すのをやめるという意味ではなかった、ということになる。
OpenAIについては、日本時間9月23日のGPT-6 Solの発表文を見た。筆者が9月30日に英語版の本文を取り直して検索したところ、「pace」「evaluator」「METR」「external」「independent」の語は0件だった。アラインメント(意図に沿った振る舞い)の評価の節はあり、詳細はシステムカードに案内している。
ただし、OpenAIは発表文とは別に、米国時間9月22日に「Priorities and principles for effective third party assessments」(効果的な第三者評価の優先事項と原則)という文書を出している。この文書は、減速論に直接つながる書き出しになっている。
As part of our efforts to pace the frontier, OpenAI is committed to supporting independent assessments with deep levels of access across training, evaluation, and deployment.
(フロンティアのペース調整の取り組みの一環として、OpenAIは、学習・評価・配備にまたがる深いレベルのアクセスを持つ独立した評価を支援することを約束する)
提携先の名前や金額は書かれておらず、中身は分野と原則の提示である(当サイトの記事で原文を読んだ)。動画ではGPT-6 Solの発表文だけを取り上げ、この文書には触れていない。
ここからは推測──減速の条件、記事の働き、告知のなさ
この節は本記事の考察で、事実として確認したものではない。
1つ目。「中国に抜かれない範囲なら減速する」という条件は、もうほとんど満たせないのではないか。 リードが約4か月なら、ペースを落とした時点ですぐ並ばれる計算になり、減速できる幅はほとんど残っていない。しかも追いついてきたのは、誰でもダウンロードできるモデルである。ただし、CAISIの「約4か月」はサイバーの試験の総合で、比べた相手には審査済みの利用者向けのモデルも入っている。エッセイの言う「リード」と同じ物差しかどうかは分からない。CAISI自身は「大幅に低い」とも書いている。エッセイは、リードを広げる手段を実行すれば3〜5年でリードを大きく広げられるとも書いている。
2つ目。この記事は、減速していないことの説明として読める面がある。 エッセイの条件どおりなら、中国製のモデルがここまで迫っていると示すことが、そのまま減速できない理由になるからだ。ただ、記事がそういう意図で出されたと決まったわけではない。記事自体は減速にも中国とのリードにも触れておらず、提言は守る側に同じ水準のAIを渡すことと、各国の政府による安全性の試験である。
3つ目。この記事は、Anthropicの公式Xで告知されていない。 筆者が9月30日12時40分(日本時間)に@AnthropicAIと@claudeaiの投稿一覧を取得した時点では、この記事を告知する投稿はなかった。同じ@AnthropicAIは、記事公開の約1時間半後の2時12分に、Anthropic Interviewerの新しい調査を告知している。9月前半にも、9月10日にサイバー評価中の事案のアラインメント評価を、9月11日に脅威インテリジェンス報告を、それぞれXで告知していた。今回告知しなかった理由は公表されていない。広めたくなかったようにも見えるが、推測である。
この記事の弱いところと、確かめていないこと
- 評価したのはAnthropic自身である。 GLM-5.3と同じく最先端のモデルを作って売っている会社の評価で、試験の選び方や条件は同社が決めている
- 安全装置の試験はシミュレーションの中の結果である。 数えたのは攻撃先に「接続しようとした」割合で、図の注記によると実際には何も実行していない。現実の被害の数字ではない
- Claudeの0%は、APIの安全装置が付いた状態の数字である。 安全装置を切ると、偽の設定でOpus 4.8が4%、Opus 5が10%だった。攻撃コードの試験のMythos PreviewとOpus 4.6も、安全装置を切った状態で試している
- Z.aiの反応は確認していない。 本記事はAnthropicの記事とCAISIの文書に書かれた範囲を扱っている
- 公式Xでの告知の有無は、9月30日12時40分時点の確認である。 その後に告知された場合は追記する
次に見ておくこと
- Haiku 5.5がいつ出るか。減速論のあとのAnthropicの間隔がさらに縮むかどうか
- Anthropicが約束した社内の外部評価者の詳細。Opus 5.5の発表文は「we expect to share more details on these efforts soon」(近いうちに詳しく伝える)と書いている
- OpenAIの第三者評価が、どの評価者と、どんなアクセスで始まるか
- Z.aiがAnthropicの記事にどう答えるか。GLM-5.3の後継に、各国の政府の試験が入るかどうか
出典と、日付の扱い
- GLM-5.3 and the spread of advanced cyber capabilities(Anthropic Frontier Red Team)
- CAISI's Assessment of Z.ai's GLM-5.3 Cyber Capabilities(NIST・9月17日)
- We Must Pace the Frontier(Dario Amodei・9月12日)
- Dario Amodei のX投稿(エッセイの告知)/Sam Altman のX投稿
- Anthropic公式X:Accentureとの提携/Partnering with Accenture on embedded evaluation(Anthropic)
- Introducing Claude Opus 5.5(Anthropic)/Introducing Claude Sonnet 5.5(Anthropic)/Claude公式X:Haiku 5.5の予告/Introducing Claude Fable 5.1 and Claude Mythos 5.1(Anthropic)
- Introducing GPT-6 Sol and Luna(OpenAI)/Introducing GPT-6.1 Sol(OpenAI)/GPT-6 Astra(OpenAI)
- Priorities and principles for effective third party assessments(OpenAI・9月22日)
- Anthropic公式Xの投稿:Anthropic Interviewerの調査/脅威インテリジェンス報告/サイバー評価中の事案のアラインメント評価
日付は、断りのないかぎり日本時間で書いている。Anthropicの記事ページの表記は「Sep 29, 2026」(米国時間)で、ページに埋め込まれた公開時刻は日本時間9月30日0時46分、最終更新は同4時28分だった。記事の数字のうち、割合(12%・14%・95%→6%など)と公開月は記事の図から、回数・時間・費用は本文から取った。攻撃の手順や再現に使える細部は、本記事では扱っていない。「18日で5つ」「21日から6日」などの日数は、各社の公式発表の日付から筆者が数えた。
関連動画
- 減速論の動画:アモディ『AIの進歩を遅らせるべきだ』/アモディ『減速』論に政治が割れた2日間(記事)/OpenAIとAnthropicが動いた(記事)
- 減速論のあとに出たモデル:Claude Opus 5.5/GPT-6 Sol・Luna/Claude Sonnet 5.5/GPT-6.1 Sol
- GLM-5.3そのもの:GLM-5.3公開の記事/GLM-5.3-Flashの記事/Mythosの経緯はClaude Mythosとは
出典・参照資料
- 一次資料GLM-5.3 and the spread of advanced cyber capabilities — Anthropic Frontier Red Team(米国時間2026-09-29・日本時間9月30日0時46分公開) ↗
- 一次資料CAISI's Assessment of Z.ai's GLM-5.3 Cyber Capabilities — NIST(2026-09-17) ↗
- 一次資料We Must Pace the Frontier — Dario Amodei(2026-09-12) ↗
- 一次資料Dario Amodei — X 投稿(2026-09-12 23:01 JST・エッセイの告知) ↗
- 一次資料Sam Altman — X 投稿(2026-09-13 01:30 JST) ↗
- 一次資料Anthropic公式X — Accentureとの独立評価の提携(2026-09-19 05:05 JST) ↗
- 一次資料Partnering with Accenture on embedded evaluation — Anthropic(2026-09-18) ↗
- 一次資料Introducing Claude Opus 5.5 — Anthropic公式(減速の節) ↗
- 一次資料Introducing GPT-6 Sol and Luna — OpenAI公式ブログ ↗
- 一次資料Priorities and principles for effective third party assessments — OpenAI(2026-09-22) ↗
- 一次資料Introducing Claude Sonnet 5.5 — Anthropic公式 ↗
- 一次資料Claude公式X — Haiku 5.5の予告(2026-09-29 03:03 JST) ↗
- 一次資料Introducing GPT-6.1 Sol — OpenAI公式ブログ ↗
- 一次資料Introducing Claude Fable 5.1 and Claude Mythos 5.1 — Anthropic公式 ↗
- 一次資料GPT-6 Astra: A new generation of intelligence — OpenAI公式ブログ ↗
- 一次資料Anthropic公式X — Anthropic Interviewerの調査の告知(2026-09-30 02:12 JST) ↗
- 一次資料Anthropic公式X — 脅威インテリジェンス報告の告知(2026-09-11 02:13 JST) ↗
- 一次資料Anthropic公式X — サイバー評価中の事案のアラインメント評価の告知(2026-09-10 04:02 JST) ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
トランプ「AIの脅威はデマ」、ハリス・オバマ「減速は必要」 アモディ『減速』論に政治が割れた2日間を原文で読む
トランプ「AIの脅威はデマ」、ハリス・オバマ「減速は必要」アモディ『減速』論に政治が割れた2日間を原文で読む
 動画
OpenAIは「自社AIの問題行動6件」を、Anthropicは「AIが研究の26%を主導」の数字を公開 ライバル2社が同じ方向に出した文書を一次ソースで読む
OpenAIは「自社AIの問題行動6件」を、Anthropicは「AIが研究の26%を主導」の数字を公開ライバル2社が同じ方向に出した文書を一次ソースで読む
OpenAIが「第三者評価の優先事項と原則」を公表 提携先も金額も書かず。Anthropic×Accentureの「社員並みアクセス」と並べて読む
OpenAIが「第三者評価の優先事項と原則」を公表提携先も金額も書かず。Anthropic×Accentureの「社員並みアクセス」と並べて読む
AnthropicがAccentureと「埋め込み型の独立評価」で提携 評価者が社員と同等のアクセスで社内に入り、学習中のモデルを見て、安全の約束が守られているかを検証し、事故を報告する。Accenture傘下のFacultyが主導し、評価・レッドチーム・アラインメント評価・安全装置の試験。両社が5年で各10億ドル以上。非独占でMETR等とも協議
AnthropicがAccentureと「埋め込み型の独立評価」で提携評価者が社員と同等のアクセスで社内に入り、学習中のモデルを見て、安全の約束が守られているかを検証し、事故を報告する。Accenture傘下のFacultyが主導し、評価・レッドチーム・アラインメント評価・安全装置の試験。両社が5年で各10億ドル以上。非独占でMETR等とも協議
 動画
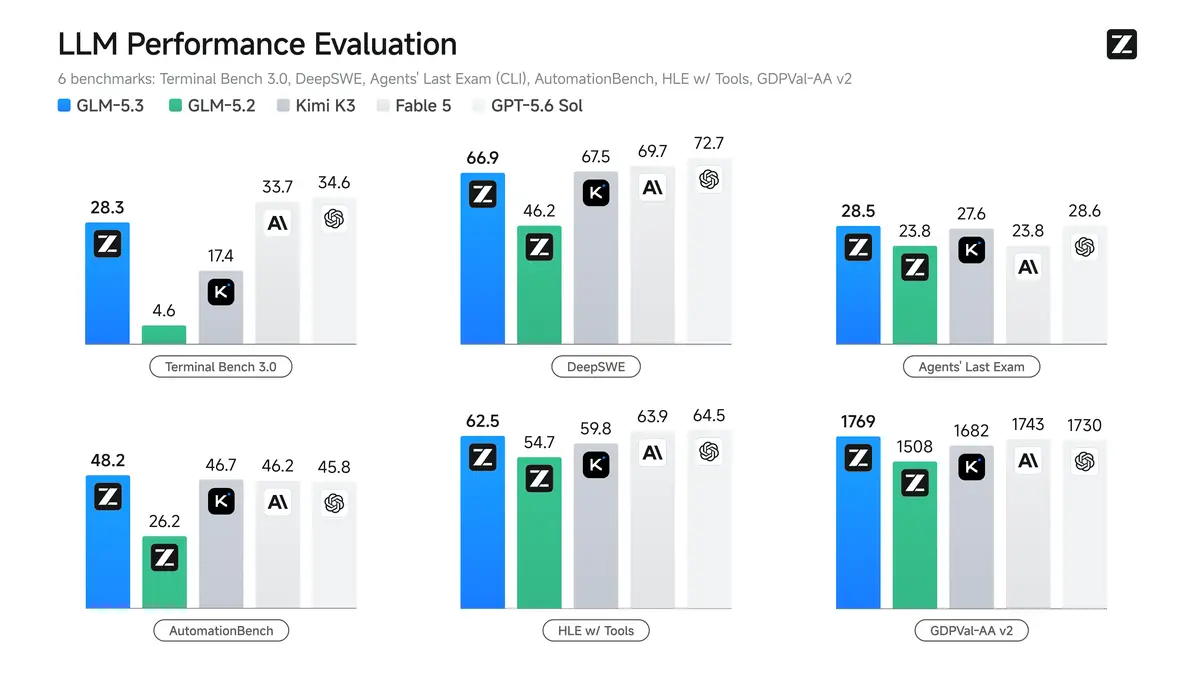
z.aiがGLM-5.3を公開 事後学習だけでTerminal Bench 6倍、サイバー能力が「予想外に」伸びた
z.aiがGLM-5.3を公開事後学習だけでTerminal Bench 6倍、サイバー能力が「予想外に」伸びた
 動画
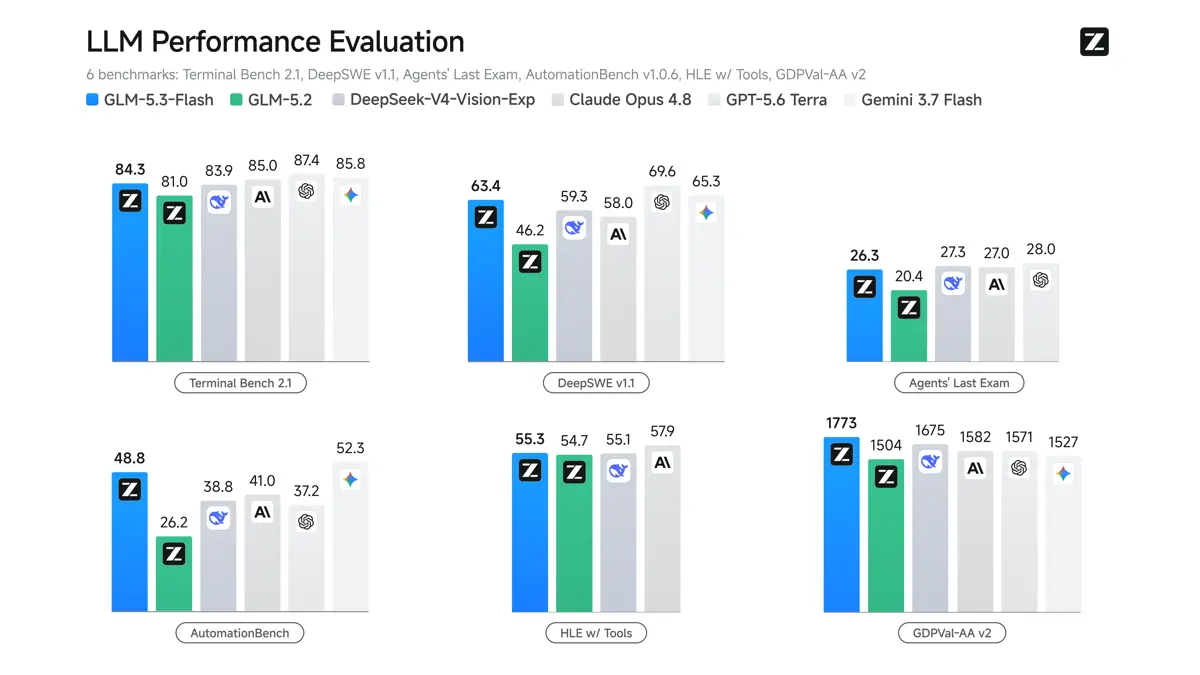
Z.aiがGLM-5.3-Flashを公開 Opus級に迫って価格は10分の1、覆面モデルOx Alphaの正体だった
Z.aiがGLM-5.3-Flashを公開Opus級に迫って価格は10分の1、覆面モデルOx Alphaの正体だった
Claude Mythosとは Fable 5.1と「同じモデルで安全装置が違う」招待制の最上位版。4月のPreviewから5.1までの経緯、誰が使えるか、価格、個人が触れる経路は無い
Claude MythosとはFable 5.1と「同じモデルで安全装置が違う」招待制の最上位版。4月のPreviewから5.1までの経緯、誰が使えるか、価格、個人が触れる経路は無い
 動画